


视觉-语言-动作(vla)模型在实际部署中常面临一个关键挑战:当相机视角、安装位置或机器人本体结构发生微小变动时,其性能往往显著下滑。
传统采用的“上下文学习”(In-Context Learning)方法,通常将上下文视为人工提供的任务示范样本,机器人仅模仿示例行为,却无法理解底层系统配置逻辑。一旦环境发生变化,研究人员往往不得不重新采集数据、重新训练模型,耗时耗力且难以快速响应。
为应对这一瓶颈,复旦大学邱锡鹏教授团队创新性地提出“上下文世界建模”(In-Context World Modeling,ICWM)。该方法要求机器人在正式执行任务前,先进行一段与任务无关的随机交互探测,并将整个交互过程作为上下文输入送入模型,从而让模型自主推断当前系统的整体运行状态。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文链接:https://www.php.cn/link/b263abe5072c23fa8bda9d66807508cf
仿真与真实机器人实验验证表明,ICWM 在多项指标上全面超越现有主流方法。该方法仅需极少量随机探测即可实现对新环境的自适应,无需额外人工示范,也无需更新模型参数,显著增强了跨视角与跨硬件配置的泛化能力。
ICWM 的核心设计思路
相较于传统 VLA 模型,ICWM 在动作生成前会先基于交互上下文识别当前系统配置,再据此规划后续行为,全程不依赖新示范或参数微调。其完整流程分为训练与推理两个阶段:
训练阶段:研究者在每个任务样本前拼接一段与任务无关的交互片段,作为模型的上下文输入。模型通过分析该片段中视觉观测的变化规律,学习判断当前系统所处的配置状态。ICWM 并未引入独立的世界模型模块,而是直接利用 VLA 主干网络处理交互历史序列——既降低了模型复杂度,又确保上下文信息能高效服务于动作预测。
推理阶段:机器人不会立即执行目标任务,而是首先开展主动探测(active probing),记录探测过程中动作施加前后对应的观测变化,构建出交互上下文(interaction context)。随后,模型将该上下文、当前观测图像以及任务指令三者联合编码,完成动作决策。
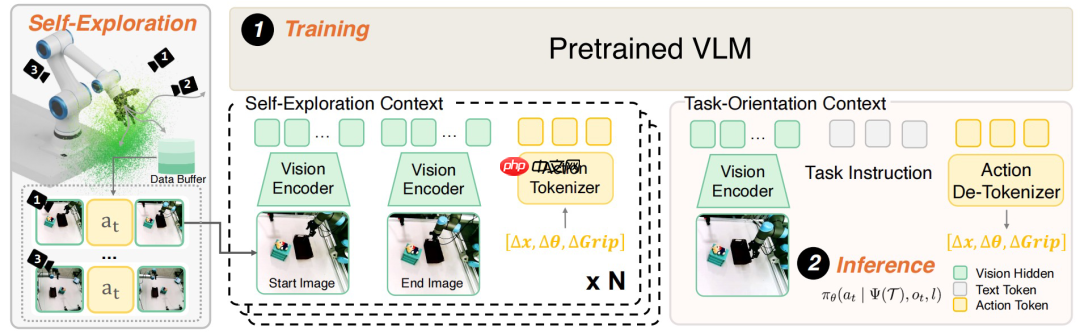
图|ICWM 的训练与推理流程概览。
实验结果
研究团队围绕跨视角迁移、真实机器人平台验证及多种分布外(OOD)扰动场景展开系统性评测。结果证实,ICWM 能有效借助交互上下文提升环境适应性,并展现出向语义变化、机器人形态差异等复杂场景拓展的潜力。
1. 仿真环境测试
团队首先在 LIBERO 仿真基准上开展跨视角泛化实验。结果显示,ICWM 在已见视角和未见视角下均优于所有基线方法。相比仅依靠多视角数据训练的传统方案,ICWM 在已见视角下平均成功率高出 8.1%,在未见视角下更达 13.0% 的优势。
值得注意的是,即便将真实的相机内参与外参显式输入模型,其泛化性能仍明显弱于 ICWM。此外,在长时序操作任务中,ICWM 对累积误差的抑制能力也更为突出。
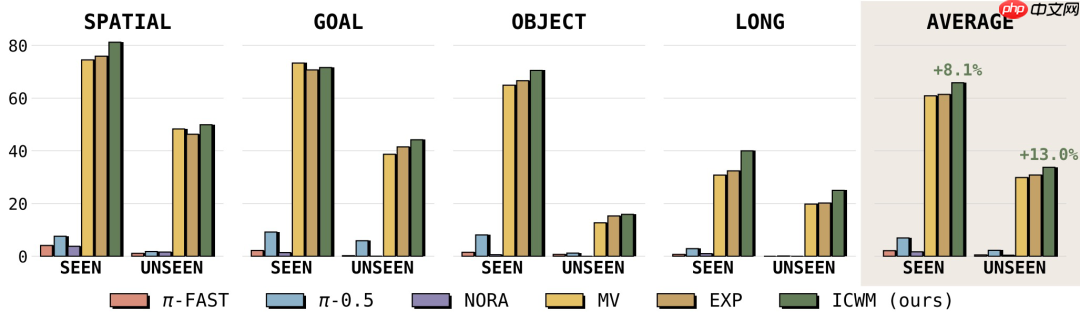
图|LIBERO 基准上,已见与未见视角下的任务成功率(%)。
2. 真实机器人平台验证
在 UR5e 真实机器人平台上,ICWM 同样展现出压倒性优势。评估采用一套由 12 台相机组成的多视角系统,覆盖堆叠、抓取、拾取与放置等多种典型操作任务。
实验数据显示,标准 VLA 模型对视角变化极为敏感:当从训练视角切换至测试视角时,平均成功率从 68% 断崖式跌落至 17%;而 ICWM 则保持了高度稳定性。
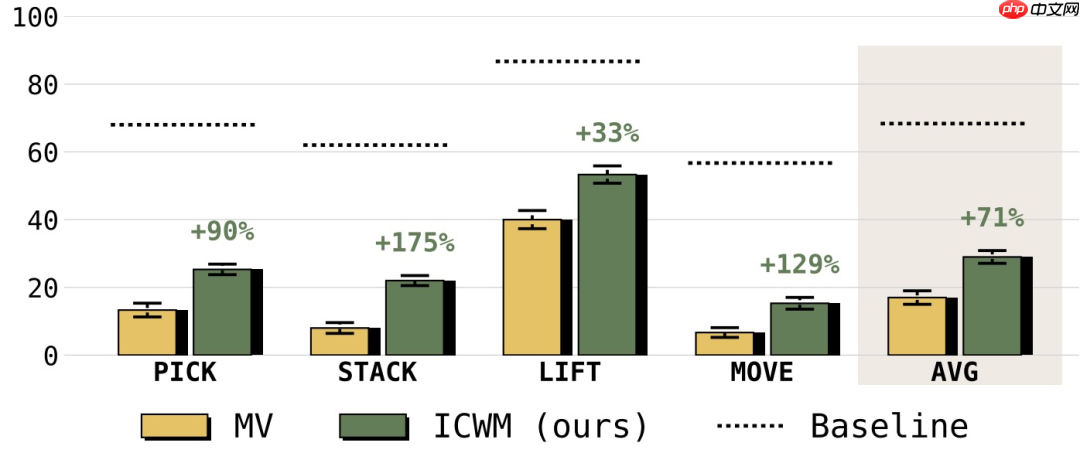
图|UR5e 平台上的真实世界性能评测。
定性分析进一步佐证了该结论:在新环境中,普通 VLA 模型常出现定位偏差、夹爪过早闭合等问题;ICWM 的行为则更加鲁棒、连贯。
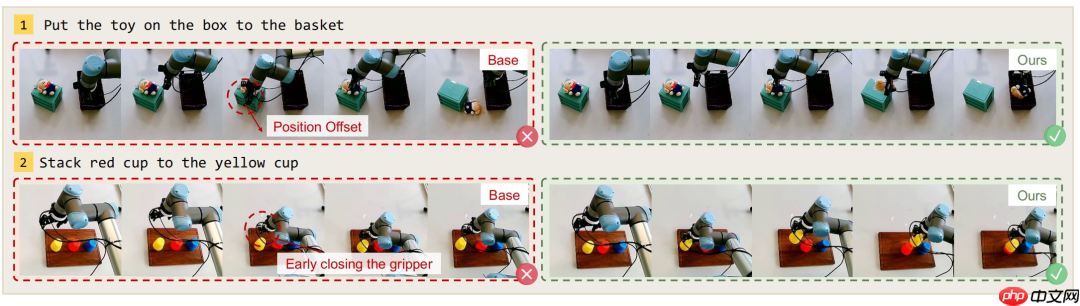
图|定性效果对比。
3. 消融研究与深入分析
消融实验明确指出,ICWM 的性能增益源自交互上下文的有效建模,而非简单的统计模式匹配。
若移除图像观测信息,模型平均成功率从 25.0% 急剧下降至 10.9%;若剔除动作序列信息,或完全不提供交互上下文,性能亦明显受损。更关键的是,当人为注入错误上下文时,模型表现甚至比无上下文情况更差。对照实验还表明,只有经过专门训练的模型才能真正利用交互上下文实现环境适配;未经训练的模型即使接收相同上下文,性能几乎归零。
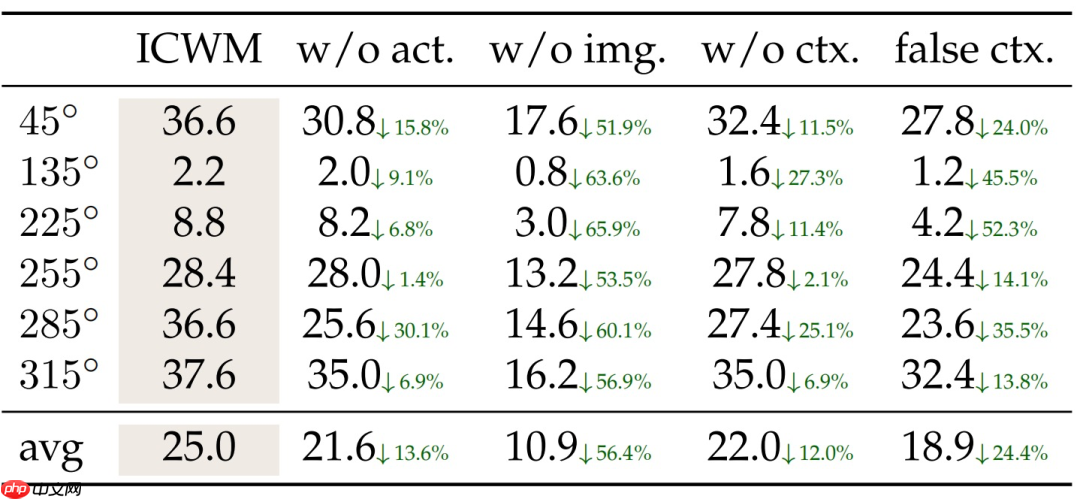
图|交互上下文消融实验结果。
从可视化分析可见,模型已具备区分不同视角与配置的能力:相同视角下的隐空间表征高度聚集,不同视角间则呈现清晰分离趋势。
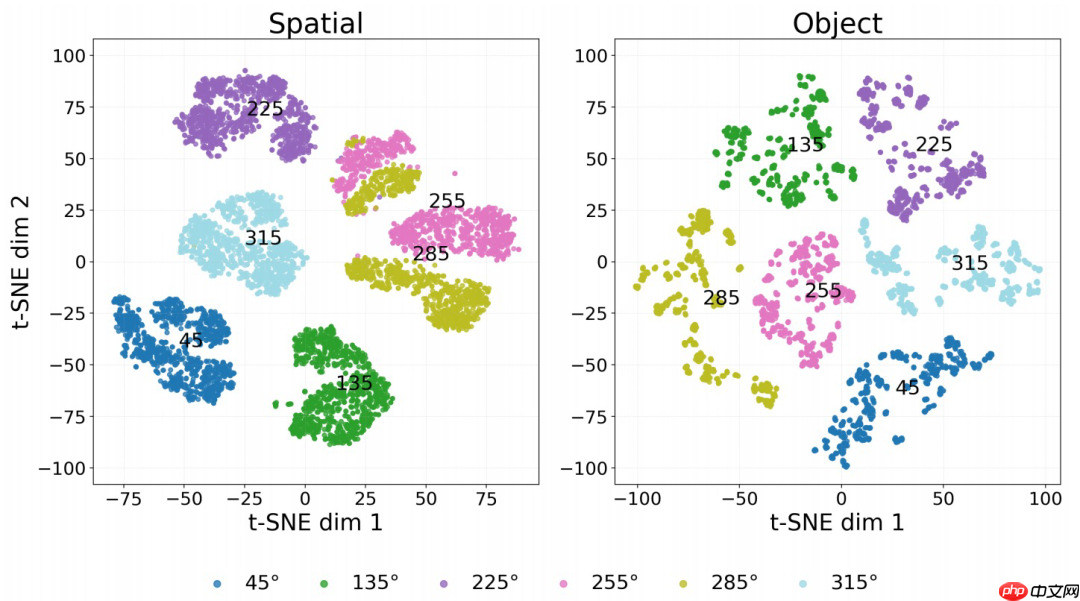
图|不同分布外(OOD)视角下 Ψ(T) 的 t-SNE 可视化结果。
研究还发现,ICWM 的有效性不依赖特定探测策略:无论是纯随机运动,还是仅沿 XY 平面、Z 轴或旋转方向进行探测,ICWM 均稳定优于对照方法,成功率提升幅度达 15%–27%。泛化性测试进一步显示,ICWM 对机器人形态变化具备较强鲁棒性,在语义扰动场景中亦表现出一定适应能力。
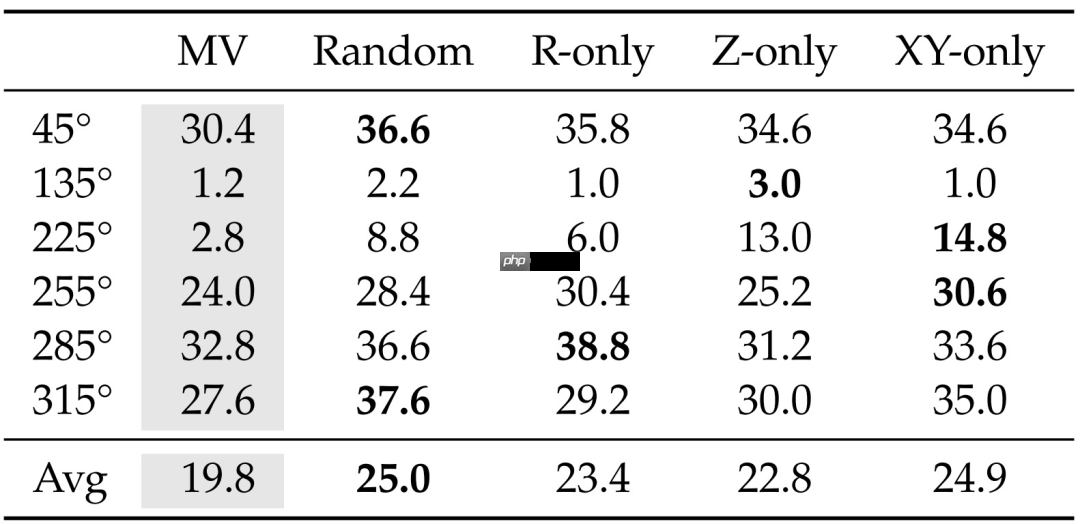
图|分布外(OOD)视角下,不同探测策略的成功率(%)。
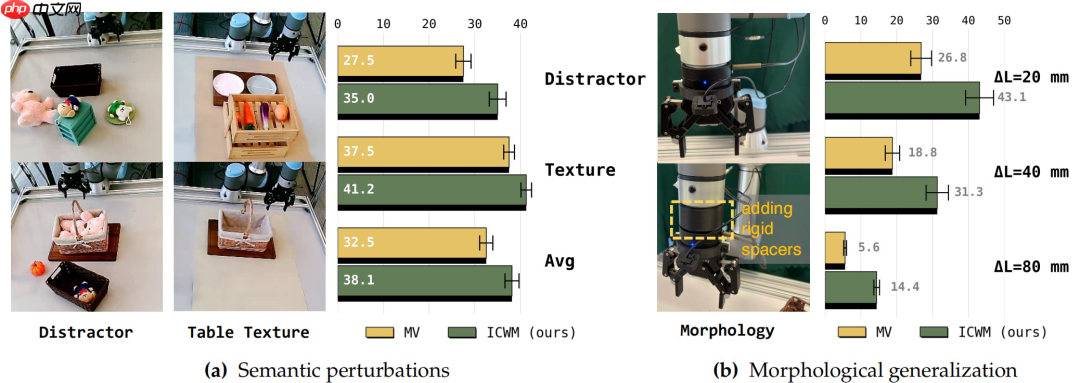
图|对语义场景扰动与机器人形态变化的鲁棒性评估。
局限性与未来展望
尽管 ICWM 显著增强了VLA 模型在未知环境中的自适应能力,但研究团队也坦诚指出当前存在的若干限制:
第一,在部分极端视角条件下(如严重遮挡、目标频繁脱离视野),ICWM 的性能提升仍较为有限。根本原因在于这些场景下视觉信号质量大幅下降。未来工作可融合多视角协同感知、主动视角重定位机制以及更强大的遮挡建模模块加以改进。
第二,在语义扰动实验中,ICWM 的增益尚不显著。这主要源于当前训练数据集中场景语义多样性与组合配置丰富度不足。若能在后续训练中引入更广泛的语义组合与物理配置样本,ICWM 在语义层面的泛化能力有望进一步跃升。
更多技术细节,请参阅原始论文。
本文来自微信公众号“学术头条”(ID:SciTouTiao),作者:夏千斯,36氪经授权发布。












