


6月16日,阿里巴巴正式推出千问具身智能大模型qwen-robot系列。该系列由三大核心模型构成:面向操作任务的vla模型qwen-robotmanip、专注自主移动的vln模型qwen-robotnav,以及具备环境建模与预测能力的世界模型qwen-robotworld。此举标志着头部科技企业在具身智能基础模型赛道的战略投入持续加码,推动机器人在动作执行、路径规划与物理规律理解三方面实现一体化协同。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
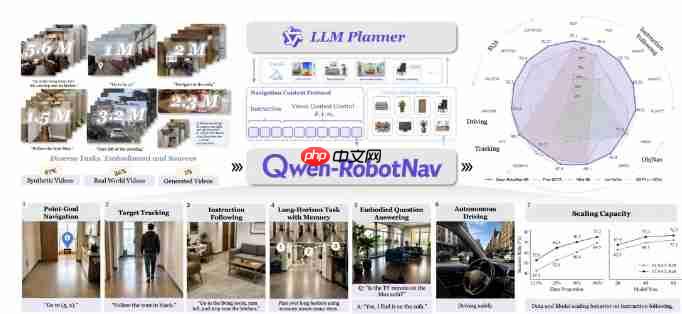
针对行业普遍存在的VLA模型跨硬件、跨场景泛化能力弱的问题,Qwen-RobotManip创新性地设计了一套80维统一动作表征体系,为形态各异的机器人本体构建起标准化的“动作语义接口”,显著降低硬件迁移门槛——仅需少量反馈即可完成新平台快速适配。而承担导航与定位职能的Qwen-RobotNav,则以Qwen-VL为视觉语言底座,首次将语言驱动导航、目标识别定位、类自动驾驶行为决策等五大典型任务整合至同一模型架构内,彻底规避多模型切换带来的系统冗余与响应延迟。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
作为整个系统的“认知中枢”,Qwen-RobotWorld赋予机器人对物理世界的状态推演与因果推理能力,可动态预测动作后果并模拟环境演化过程。当前,具身智能正加速从封闭场景走向开放通用,阿里此次同步发布三大模型,依托模块化解耦设计与深度多模态融合,有望大幅缩短异构机器人平台规模化落地的时间周期。













