


形式化定理证明,被公认为大语言模型(llm)最具挑战性的推理能力试金石——每一步推导都必须经由lean 4内核进行严格机器验证。
过去两年间,开源社区在MiniF2F、PutnamBench等主流评测基准上的表现持续攀升,但技术演进路径日益趋同:堆叠更大模型、扩充更多数据,并在部署阶段叠加检索增强与多轮自我修正机制。
一个根本性瓶颈始终未解:检索信号、编译器诊断反馈及失败修复逻辑,大多仅作为部署时的外围插件接入,而模型在训练过程中并未系统性习得如何感知、理解并利用这些关键信息。由此催生了训练目标与实际部署行为之间的“策略割裂”。
为突破这一瓶颈,M-A-P开源社区联合南京大学等研究团队正式推出OProver——
首个将检索增强、编译器反馈解析与多轮修复闭环深度内嵌至训练范式中的Lean 4定理证明框架。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
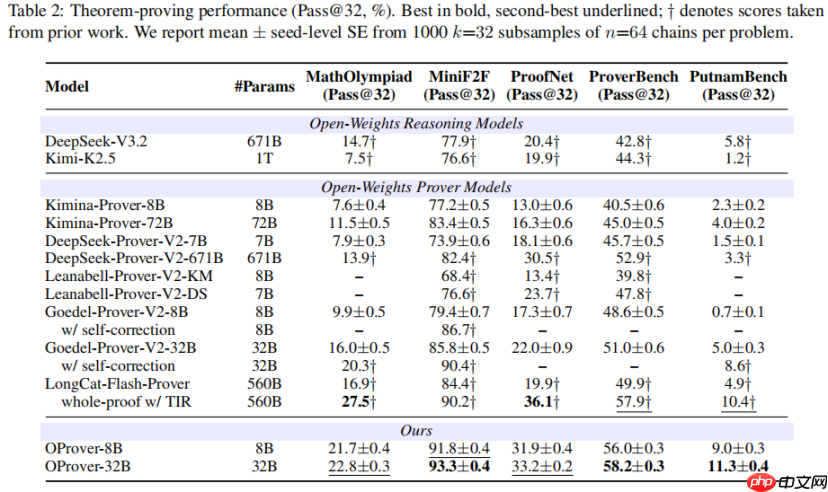
在涵盖MiniF2F、MathOlympiad、ProofNet、ProverBench、PutnamBench在内的五项Lean 4全证明(whole-proof)评测中,OProver-32B斩获三项第一、两项第二:
MiniF2F(93.3)、ProverBench(58.2)、PutnamBench(11.3)均超越LongCat-Flash-Prover w/ TIR;且在全部五项评测中全面领先参数量达671B的DeepSeek-Prover-V2。
项目同步开源包含176万条形式化命题、680万条经编译器验证的证明链的OProofs语料库,以及8B/32B共7个版本的模型权重。
代码、权重与完整训练脚本均已开放获取。
策略割裂:训练与部署的核心鸿沟
当前主流Lean 4定理证明系统(如Goedel-Prover-V2、DeepSeek-Prover-V2、Kimina-Prover等)已在MiniF2F上将Pass@32指标推至高位,部分工作亦尝试引入检索、编译器反馈或自修正模块。
但其共性局限在于:上述增强能力基本以“黑盒式后处理流程”形式加装于已训练完成的prover之上,而非从训练源头就被建模为学习目标。
由此造成显著错配:
- 训练阶段,模型仅接触结构清晰的“定理→已验证证明”监督样本;
- 部署阶段,系统却向模型实时注入检索所得相关证明、前序失败尝试记录及Lean 4返回的详细编译错误,驱动其开展多轮迭代修复。
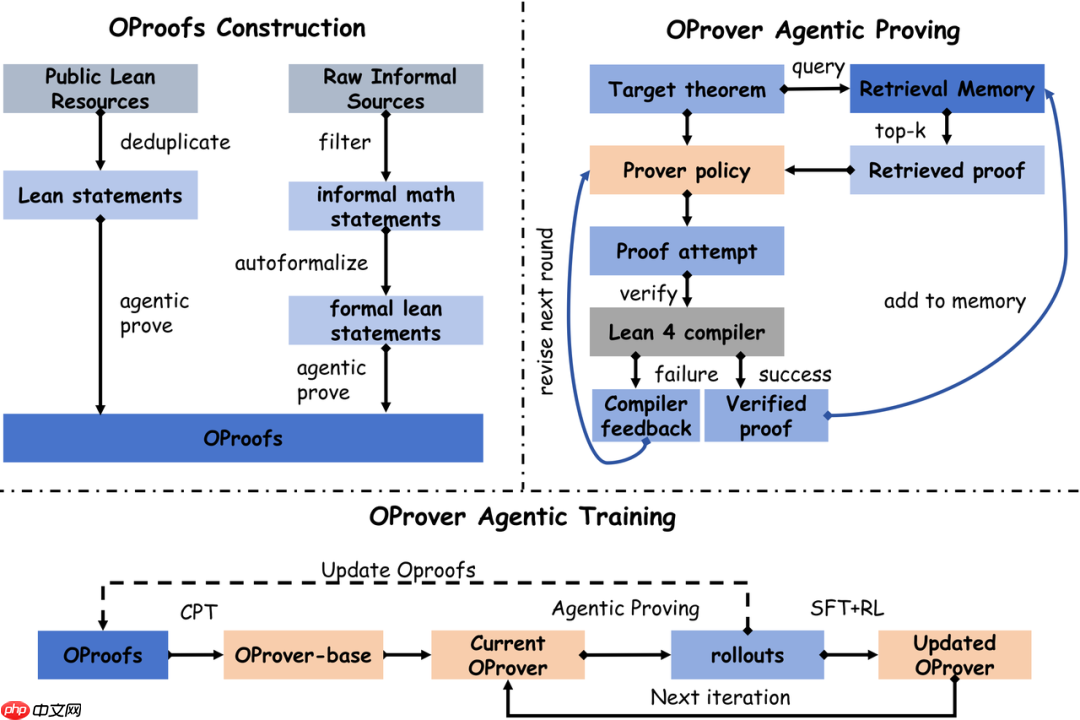
OProver的核心思想,是实现训练目标与真实部署证明流程的对齐:让模型在训练初期即习得执行智能体式精炼循环(agentic refinement loop) 的能力——将多轮修复、上下文检索与编译器反馈解析,统一纳入模型需主动建模与优化的策略空间,而非视作部署层的附加包装。
轻量化、端到端可训架构
部署阶段:可控轮次修复机制
OProver将定理证明任务建模为有限步数的修复循环。
每一轮输入包含:目标形式化命题、从记忆库中检索出的top-k条已验证证明、上一轮生成的未通过证明、以及Lean 4编译器返回的结构化诊断信息;模型据此生成新一轮证明尝试。任意一轮成功通过验证,整条推理轨迹即判定为有效。
训练阶段:双阶段协同优化
- 持续预训练(CPT):基于约65B token混合语料开展,其中Lean 4数据(来自OProofs)占比约30%,代码数据(OpenCoder)占20%,数学语料(Nemotron-Math-4-Plus)占40%,长思维链(CoT)数据占10%;
- 迭代式后训练:交替执行agentic proving rollout、基于轮次级修复样本的监督微调(SFT),以及面向难题集的强化学习(RL,采用GSPO算法)。
关键创新在于:检索结果、失败尝试痕迹与编译器反馈不再作为部署期临时拼接的外部信号,而是被显式编码为模型必须学习和响应的核心策略要素。
数据与模型的双向进化闭环
OProofs语料库与prover策略在迭代中相互驱动、共同演进。
每轮迭代中,当前模型在测试集上新生成并通过验证的证明,将自动加入OProofs并构建索引供后续检索使用;
修复过程中的完整轨迹成为下一轮SFT训练的关键样本;尚未攻克的“高难度题组”,则构成下一轮RL训练的核心奖励信号。
数据构建、模型训练与策略设计,由此形成持续正向反馈的演化闭环。
OProofs:专为agentic prover打造的Lean 4高质量语料
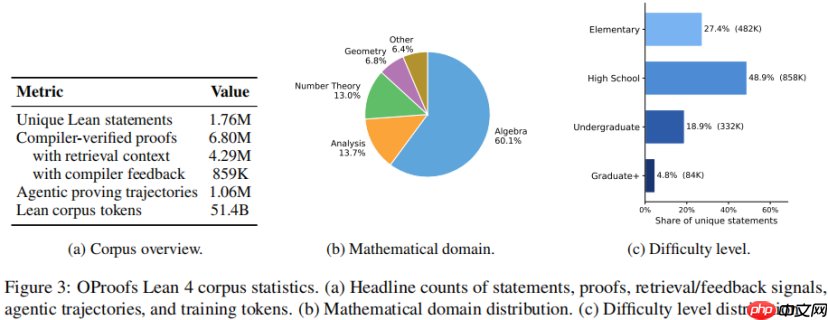
研究团队同步构建并开源OProofs语料库,涵盖约176万条形式化命题、680万条经Lean 4编译器验证的证明。
其中429万条证明附带检索所得的相关证明上下文,85.9万条样本整合了此前失败尝试所触发的编译器诊断反馈。模型不仅学习“什么是正确证明”,更系统掌握“当证明失败时,如何结合检索线索与编译器提示进行定向修复”。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
OProofs由两条互补的数据构建路径组成:
1、公开资源再验证生成
以NuminaMath-LEAN、Lean-Workbook、Leanabell-Prover-FormalStmt等权威开源Lean资源为起点,经清洗去重后,交由agentic proving系统重新生成并验证全部证明,同步采集检索上下文、失败日志与修复轨迹。
2、自然语言→形式化自动转化
从Common Crawl与GitHub大规模挖掘数学自然语言陈述,借助CriticLean工具链自动转化为Lean 4形式化表达,再经agentic proving流程完成证明生成与验证。
从覆盖维度看,OProofs横跨代数(60.1%)、分析(13.7%)、数论(13.0%)、几何(6.8%)四大数学分支;难度分布以初等(27.4%)与高中水平(48.9%)为主,同时包含本科难度(18.9%)与研究生难度(4.8%)问题。
五项评测稳居前列:三项榜首、两项次席
研究团队在MiniF2F、MathOlympiad、ProofNet、ProverBench、PutnamBench五大Lean 4评测基准上完成系统评估,默认报告Pass@32指标,基于n=64条独立多轮rollout的无偏估计。
在开源权重的全证明prover阵营中,OProver-32B呈现三大核心优势:
1、32B全面碾压671B
OProver-32B在全部五项评测中超越DeepSeek-Prover-V2(671B),并在MiniF2F(93.3)、ProverBench(58.2)、PutnamBench(11.3)上同步领先LongCat-Flash-Prover w/ TIR(560B)。
2、8B反超32B竞品
OProver-8B在全部五个benchmark上均优于Goedel-Prover-V2-32B,参数量仅为后者的四分之一。
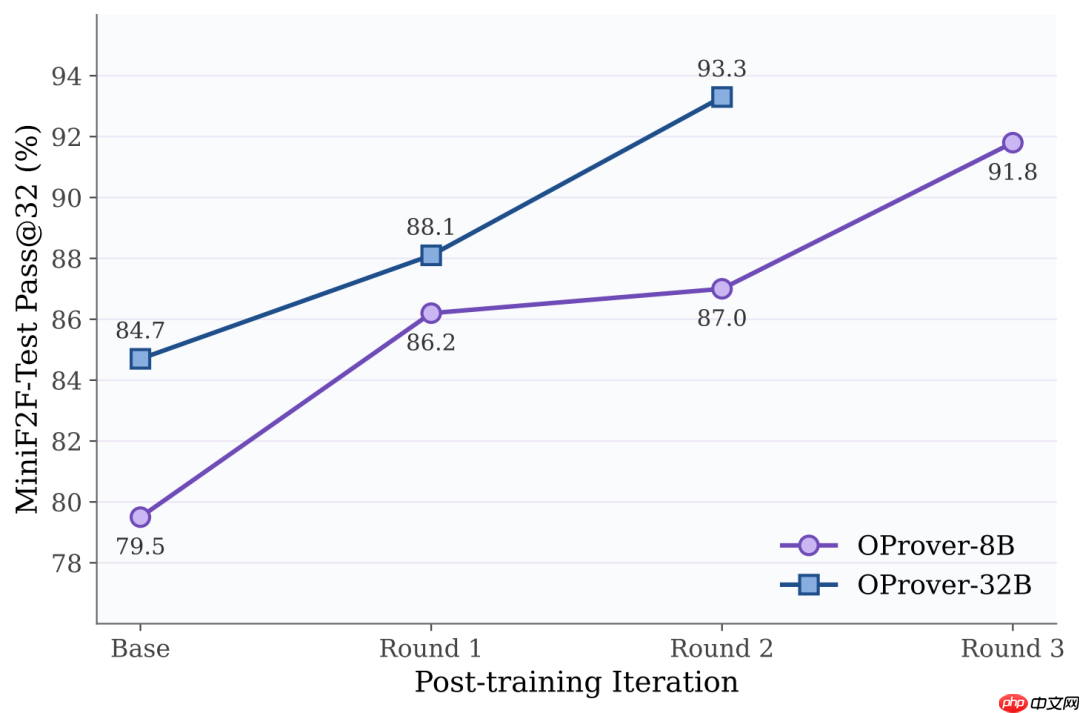
3、迭代训练带来持续增益
在MiniF2F-Test上,OProver-8B得分由79.5跃升至91.8(+12.3),OProver-32B由84.7提升至93.3(+8.6)。
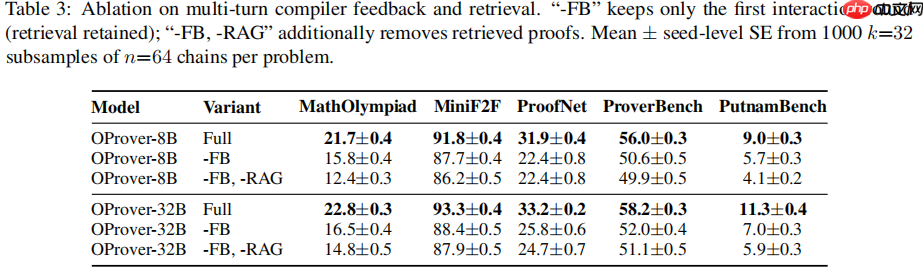
消融实验:检索与编译器反馈协同增效
移除多轮编译器反馈导致性能最大幅度下滑:OProver-32B在PutnamBench从11.3跌至7.0,在ProofNet从33.2降至25.8。
若进一步移除检索模块,指标继续下探至5.9与24.7。
这表明性能跃升并非源于简单粗暴的best-of-N采样,而是源自检索提供的结构启发与编译器反馈引导的精准修复之间形成的强协同效应。
其中,Lean编译器反馈提供关键纠错方向;检索上下文则贡献可复用的证明模式与片段模板。
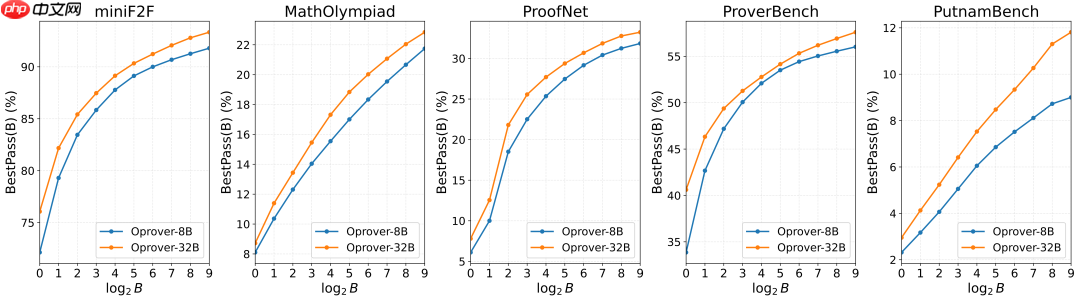
测试时扩展性:推理预算增长稳定提效
随着单次推理预算由8提升至256,OProver-32B在全部五项评测中均呈稳健上升趋势:MiniF2F从87.5升至92.8,MathOlympiad从15.5升至22.0,ProofNet从25.6升至32.8,ProverBench从51.3升至56.9,PutnamBench从6.4升至11.3。
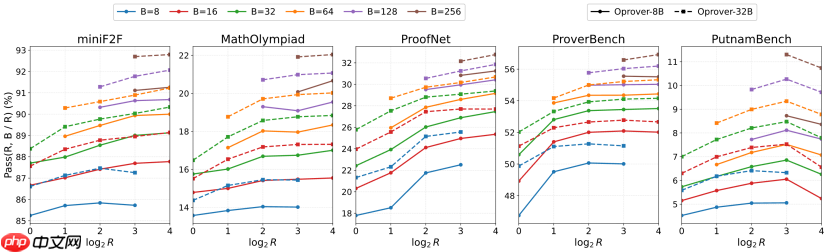
最优预算分配策略与评测难度高度相关:多数benchmark受益于加深单线程修复深度;而PutnamBench等低通过率难题,则需在修复深度与并行探索广度之间取得动态平衡。
全面开源与生态发布
研究团队已完整开源OProver全栈资源,包括模型权重、OProofs语料库及标准化训练流水线,覆盖各阶段checkpoint。
• m-a-p/OProver-32B / OProver-8B — 最终发布模型
• m-a-p/OProver-32B-Base / Round1 — 32B各训练阶段checkpoint
• m-a-p/OProver-8B-Base / Round1 / Round2 — 8B各阶段checkpoint
• m-a-p/OProofs — 176万条命题 / 680万条验证证明 / 106万条修复轨迹
需指出的是,OProver当前聚焦于Lean 4全证明场景。
未来值得关注的方向包括:该agentic refinement框架向Coq、Isabelle等其他主流证明助手的迁移可行性;以及在更长周期的数据-模型协同进化中,性能增长是否具备可持续性。
论文:https://www.php.cn/link/b45357b8257d2ec975e90db3da32947e
代码:https://www.php.cn/link/d847776976cb4d14fd28d53d9f326190
模型与数据:https://www.php.cn/link/161eef2abeb0574e9a8d4e14effea38c
本文首发于微信公众号“量子位”,作者:OProver团队,36氪经授权转载。















