databuddy 是腾讯云于2026年5月19日正式推出的大数据原生智能体工作台,隶属“buddy家族”第三位成员,与workbuddy共享同源harness ai框架及agent底层能力。它面向企业级数据基础设施,深度融合data+ai一体化理念,覆盖数据分析、数据治理、数据工程三大核心场景,专为数据分析师、数据治理人员、数仓工程师及业务人员设计。
用户仅需通过自然语言对话提出目标(如“把A系统订单表按时间字段做T+1增量同步至数仓”),DataBuddy即可自主完成任务拆解、路径规划、Skill调用、异常修正与结果交付,真正实现“一句话驱动全链路”,彻底告别多页面跳转与手动配置。其内嵌六层统一语义知识层与数据飞轮机制,支撑自动巡检、AI诊断、ETL自动生成、血缘追溯等高阶能力,将传统需1–2周完成的数仓建设、数据治理等任务压缩至小时级交付。

WorkBuddy Visio — Visio 兼容架构图生成器
下载
使用 draw.io(.drawio 格式)和 SVG 生成兼容 Microsoft Visio 的架构图。当用户需要以下任一场景时触发: - 用于 Visio 或技术文档的架构/系统/网络图 - 带连接标注的分层控制系统图 - 将 draw.io XML 转换为稳定、可嵌入的 SVG - 修复 Visio 或 draw.io 无法打开的故障排查类图表 - 任何需专业级布局且文本可编辑的图表
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
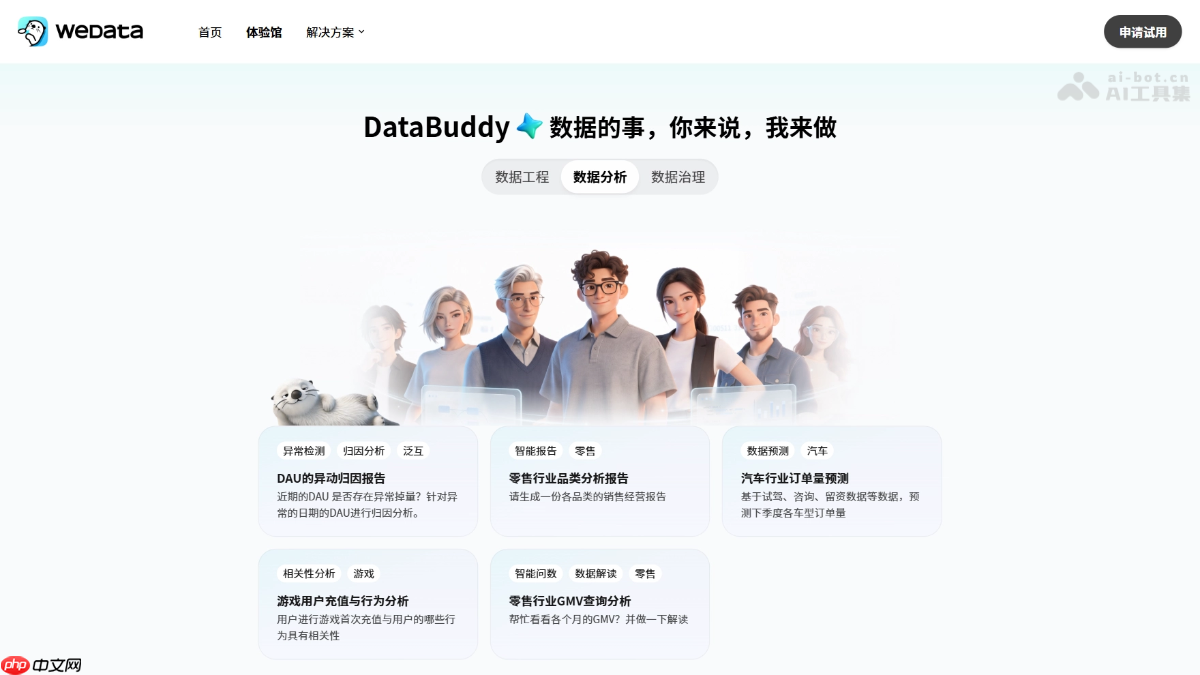
DataBuddy的主要功能
- 自然语言智能分析:支持口语化问数、多维指标归因、自动报告生成与拖拽式可视化看板构建,依托统一语义层保障跨角色、跨会话结果一致性。
- 闭环式数据治理:覆盖数据编目、语义建模、质量监控、安全分级、血缘追踪五大维度,具备AI驱动的自动巡检、根因诊断与分级修复能力。
- 对话式数据工程:以自然语言完成从数据接入、分层建模、SQL/Python代码生成、工作流编排到故障定位的全生命周期管理。
- 业务知识持续沉淀:通过六层知识体系(含表结构、指标口径、业务术语、组织规则、个人偏好与历史洞察)自动提取、去重、关联业务认知,形成可复用、可演进的知识资产。
- 纵深安全可信执行:集成Agent Guardrail防护机制、全链路操作审计、最小权限执行策略,并内置提示注入识别与越狱行为拦截能力,确保自动化不逾越企业安全边界。
如何使用DataBuddy
- 登录认证:访问腾讯云WeData平台官网(https://www.php.cn/link/45ec40b01a59e8f10dd49b290314c22e。
- 自然语言提需:在交互界面输入清晰业务目标,例如:“对比近30天华东与华南区域GMV趋势,并标注环比变化超10%的日期”。
- Agent自主响应:系统实时解析意图,调度数据集成、DLC计算引擎、元数据服务等Skill,自动执行查询、建模或代码生成。
- 关键环节确认:对涉及权限变更、DDL操作、跨域数据导出等高危动作,触发人工复核流程;其余低风险任务秒级自动完成。
- 成果即时交付:分析结果以结构化表格、归因图谱、可视化看板或可运行ETL脚本等形式,直接呈现在对话流中,支持一键导出或发布。
DataBuddy的核心优势
- 真Agent交付范式:突破“AI辅助工具”定位,升级为人设目标、Agent全权交付的原生模式,从“人点鼠标”迈向“人说目标”。
- 语义一致零偏差:六层知识体系与统一语义层深度对齐业务语言,从根本上消除“同一指标、多人多解”的协作断点。
- 效率跃迁式提升:数仓建模周期由周级降至小时级,数据治理任务响应从小时级压缩至分钟级,ETL开发耗时下降超90%。
- 无缝继承现有资产:原生对接WeData平台全部能力模块(数据集成、任务调度、质量中心、元数据中心),无需迁移数据、重建权限或重构调度逻辑。
- 安全合规无妥协:所有Agent行为受Guardrail实时约束,严格遵循企业既有RBAC模型、脱敏策略与审计规范,满足金融、政务等强监管场景要求。
DataBuddy的同类竞品对比
| 对比维度 | **DataBuddy**(腾讯云) | **DataWorks Agent**(阿里云) |
|---|---|---|
| **产品定位** | 面向大数据场景的原生 AI Agent 工作台 | 大数据开发治理平台的 Agent 智能体 |
| **交互范式** | **Agent 自主交付**:用户提目标,Agent 拆解任务、调用 Skill、规划流程并直接交付结果 | **AI 辅助 + 自动执行**:自然语言转化为治理动作,可自动配置规则并执行 |
| **覆盖链路** | 数据分析 + 数据治理 + 数据工程 **全链路** | 数据开发 + 数据治理 + 质量监控 |
| **核心能力** | 智能问数、指标归因、报告生成、自动治理巡检、ETL 自动生成、血缘追溯、数仓建仓 | 质量规则自动配置、质量问题治理、元数据管理、数据目录 |
| **知识/语义层** | **六层知识体系**:从表结构、指标口径、业务术语到个人记忆,自动沉淀业务洞察飞轮 | 基于元数据与数据资产目录,智能分析字段语义和业务重要性 |
| **执行模式** | **分级执行**:低风险操作秒级自动完成,高危操作需人工确认后执行 | 治理动作可自动执行(如自动配置质量规则),部分需人工审核 |
| **安全/治理** | **Agent Guardrail** + 最小权限原则 + 全链路审计 + 提示注入/越狱拦截 | 传统 RBAC + 操作审计 + 数据安全策略 |
| **生态集成** | 原生连接腾讯云 DLC 数据湖引擎,继承现有 WeData 数据资产与权限体系 | 深度集成阿里云 MaxCompute、Hologres、EMR 等大数据产品 |
| **目标用户** | 数据分析师、数据治理人员、数仓工程师、业务人员 | 数据开发工程师、数据治理专员、运维人员 |
| **差异化亮点** | **Buddy 家族统一 Agent 框架**(WorkBuddy 同源),”用数驱动治数”的正向飞轮,小时级建仓交付 | 从”主动式”迈向”自主式”数据治理,专家级治理能力自动配置 |
DataBuddy的应用场景
- 业务一线自助问数:市场、运营等非技术角色直接输入“上月新客转化率TOP5城市及原因分析”,秒级获取带归因结论的图文报告。
- 治理任务无人值守:定时触发全库元数据扫描,自动识别缺失描述、空值率超标、敏感字段未脱敏等问题,并推送分级修复建议。
- 敏捷数仓快速落地:输入“基于CRM与订单库构建客户主题宽表”,系统自动生成ODS-DWD-DWS分层方案、SQL建模脚本与调度依赖关系。
- 跨系统根因穿透诊断:当某核心报表数据异常时,沿血缘向上追溯至源头系统字段变更、下游ETL逻辑错误或中间表加工延迟,输出综合健康评估报告。