





proxy_next_upstream 通过多节点 upstream、被动健康检查、精准错误类型筛选、严格重试控制及兜底降级策略,实现对静态存储后端偶发故障的快速切换与高可用保障。
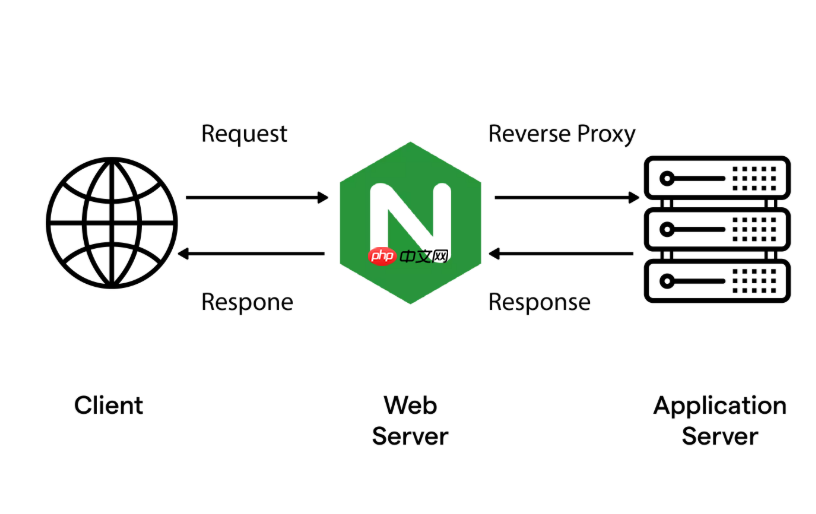
proxy_next_upstream 可以有效应对后端静态存储节点(如对象存储网关、CDN源站、MinIO集群、NFS代理层等)偶发不可用问题,但它的作用不是“自动修复”,而是“失败后快速切换到其他健康节点”,前提是架构本身支持多节点冗余部署。单纯加一行配置无法容错,必须配合 upstream 定义、错误类型筛选、重试边界控制和被动健康检查,才能形成闭环。
必须定义多节点 upstream 并启用被动健康检查
静态存储服务通常无状态,适合横向扩展。Nginx 不会主动探测节点是否存活,只能靠请求失败来“学习”——这就是 passive health check 的核心逻辑:
- 每个 server 行必须显式配置 max_fails=2 fail_timeout=30s,表示连续失败 2 次后,该节点在 30 秒内不参与调度
- 若只配一个存储节点,proxy_next_upstream 就没有“下一个”可切,配置无效
- 建议搭配 backup 节点(例如本地缓存代理或降级静态页),仅当所有主节点都标记为不可用时才启用
只对可安全重试的错误类型启用重试
静态资源请求(GET/HEAD)天然幂等,但并非所有响应都适合重试。重点区分业务失败与临时故障:

WebChat Voice Proxy
下载
⚠️ 已弃用 — 该技能已拆分为两个独立技能,以提升模块化程度:**webchat-https-proxy**(HTTPS/WSS 反向代理)和 **webchat-voi...**
- 必须包含:error timeout invalid_header —— 覆盖连接拒绝、建连超时、响应头损坏等底层异常
- 推荐加入:http_502 http_503 http_504 —— 这三类多由网关中断、上游过载或超时引发,换节点大概率成功
- 明确排除:http_404 http_403 http_500 —— 404/403 是路径或权限确定性结果;500 若来自存储逻辑异常(如元数据损坏),重试同构节点无意义
严格限制重试次数与总耗时
静态资源常被高频访问,重试失控会放大延迟甚至引发雪崩。关键参数需协同设置:
- proxy_next_upstream_tries 3:最多尝试 3 次(含首次),避免轮空或打满所有节点
- proxy_next_upstream_timeout 8s:从第一次请求发出开始计时,超时立即终止并返回错误。该值应略小于 proxy_read_timeout(例如设为 10s),确保有余量留给网络抖动
- 配套设置 proxy_connect_timeout 2s 和 proxy_read_timeout 10s,防止单次卡死拖垮整体
补充兜底策略增强鲁棒性
proxy_next_upstream 解决的是“转发阶段失败”,但用户仍可能看到 502/504。可叠加以下机制进一步降级:
- 用 error_page 502 503 504 = @fallback 指向本地缓存目录或默认占位图,实现静默降级
- 开启 proxy_cache_use_stale error timeout updating,允许在上游异常时返回陈旧缓存,保障可用性优先于新鲜度
- 通过 $upstream_status 记录每次尝试的真实状态(如 “502,504,200”),用于日志分析与故障定位












