


deepseek正式开启大规模图像识别功能内测,标志着这款国产大模型领军者全面迈入图文融合的多模态交互新阶段。继4月底开展小范围灰度测试后,deepseek于5月9日显著扩大“识图模式”的开放范围,目前大部分内测账号已在对话界面通过全新设立的独立入口启用该能力。尽管界面仍标注为“功能内测中”,但其与“快速模式”、“专家模式”并列置于输入框上方的显性布局,清晰传递出多模态理解已深度融入其核心产品架构的战略信号。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
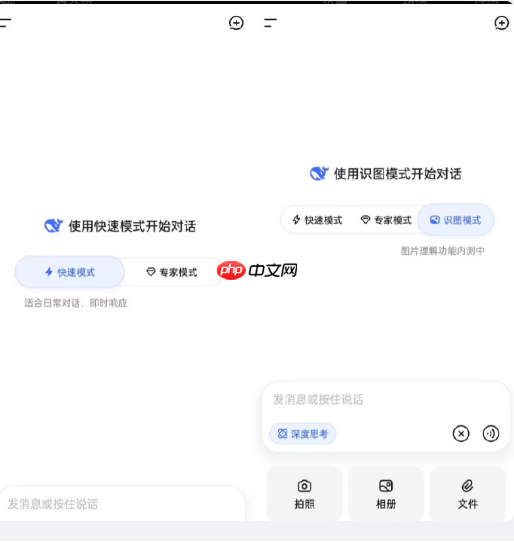
区别于传统OCR仅限于文字提取的浅层处理,DeepSeek本轮升级的核心在于构建起对图像内容的深层解析与语义建模能力。实测显示,该模式可对视觉信息进行结构化拆解与上下文感知,支持用户直接上传图片,完成推理问答、细节追问、跨模态联想等高阶交互任务。此举有效弥补了DeepSeek此前在多模态理解维度的能力缺口,为其对标GPT-4o等国际先进模型提供了关键支撑。

Unified LLM Gateway - One API for 70+ AI models. Route to GPT, Claude, Gemini, Qwen, Deepseek, Grok and more
下载
统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
从产业演进角度看,DeepSeek在持续保持卓越算力效率与成本优势的基础上,快速补强多模态能力,折射出国产大模型竞争主战场正加速由纯文本生成向“视觉—语言”深度融合迁移。随着识图功能逐步覆盖更广泛用户群体,DeepSeek将在智能办公提效、工业质检分析、科研图表解读等专业场景中释放更强应用价值。这场从“识文”到“辨图”的跃迁,不仅拓展了人机交互的物理边界与认知深度,也正推动中国大模型产业迈向多模态能力规模化落地与普惠化发展的新纪元。











