





根据superclue-vlm发布的2026年4月最新评估报告,中文多模态视觉语言模型领域正经历一场深层次的格局重构。在面向全球17款主流大模型开展的全面横向评测中,国产ai力量展现出强劲的增长势能——不仅在中文语义与视觉协同理解方面具备显著优势,整体综合能力亦首次实现对海外头部模型的全面超越。
字节跳动强势领跑,多支国产劲旅稳居第一阵营
评测数据显示,字节跳动研发的Doubao-Seed-2.0-Pro-260215以90.66分的优异成绩摘得总榜桂冠,力压此前广受瞩目的谷歌Gemini-3.1-Pro-Preview(89.35分)。此外,阿里巴巴推出的Qwen3.5系列、商汤科技SenseNova、智谱AI GLM等国产模型亦表现亮眼,集体挺进榜单TOP5。相较之下,OpenAI的GPT-5.4与X.AI的Grok等国际知名模型,在本次中文多模态专项测评中仅处于中段区间。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
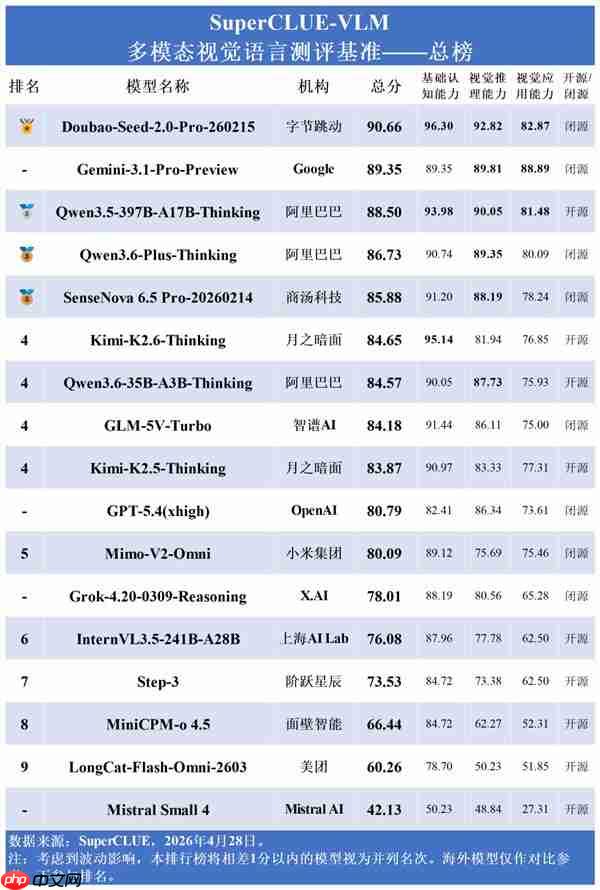
三大能力维度精细拆解,底层感知与识别能力趋于稳健
立即进入“豆包AI人工智官网入口”;

在 Linux 上通过 Chrome 挂载/VNC 自动发布小红书长笔记。Agent 撰写标题和正文后执行 xhs_publish.sh --publish --submit,触发小红书发布。
立即学习“豆包AI人工智能在线问答入口”;
本周期评测体系科学严谨,围绕基础认知、视觉推理、视觉应用三大核心能力维度展开,覆盖通用物体识别、复杂图表解析、医学影像判读等25类典型任务场景。国产模型在“基础认知”与“数据分析”两大模块中表现尤为突出,平均得分普遍突破90分阈值,充分印证其技术稳定性及对中文多模态环境的高度适配能力。
专业场景仍存提升空间,工业质检与临床影像成攻坚焦点
尽管综合表现跃居前列,测评结果同时指出,国产模型在部分高门槛垂直领域尚存优化余地。尤其在工业缺陷检测、亚毫米级医疗影像分析等强专业性“视觉推理”任务中,与全球领先水平相比仍有追赶空间,个别子任务得分离散度偏高。
行业观察指出,此次排名更迭标志着中文多模态人工智能已迈过关键成长临界点。国产大模型在中文语境下的深度语义建模、跨模态对齐与落地泛化能力上,已构筑起扎实的技术护城河,正式步入与国际一线阵营同台竞技、并在多个细分方向实现率先突破的新发展阶段。












