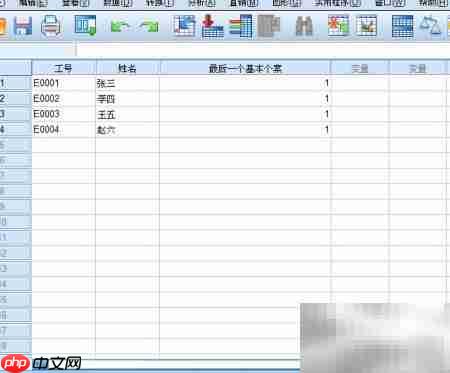
在spss中开展数据分析时,重复数据常因录入错误或系统异常而产生,必须先完成数据清洗,再进入建模与统计分析阶段。以下是一套实用、可复现的去重操作流程,助您保障数据质量并提高分析效率。
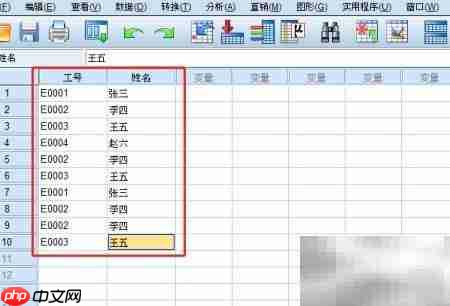
1、构建一份模拟数据集,包含“工号”与“姓名”两个关键字段,其中人为设置若干重复记录,用于后续步骤演示。
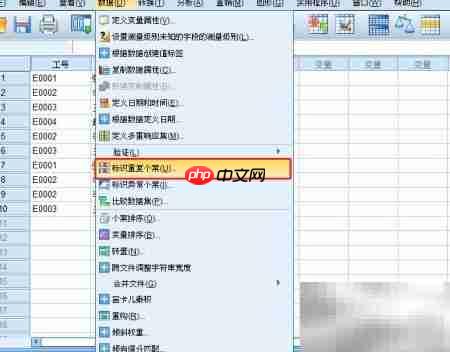
2、依次点击顶部菜单栏【数据】→【标识重复个案】,系统将自动识别并标记出所有重复观测。
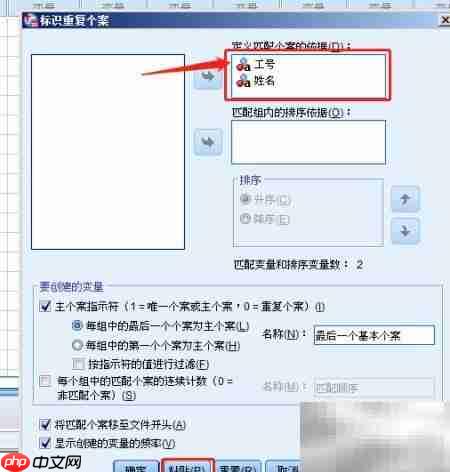
3、在弹出对话框中,将“工号”和“姓名”两个变量通过中间箭头按钮移入右侧【定义匹配个案依据】列表框;确认无误后,点击下方【粘贴】按钮生成对应语法代码。
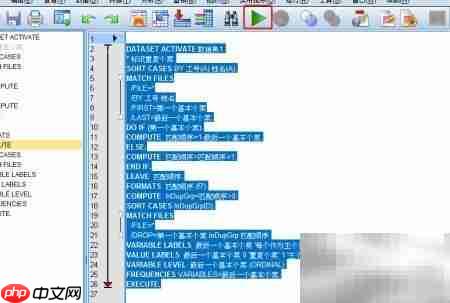
4、语法代码将自动载入SPSS语法编辑器窗口,点击工具栏上的绿色运行三角图标(▶),即可执行去重判定逻辑。
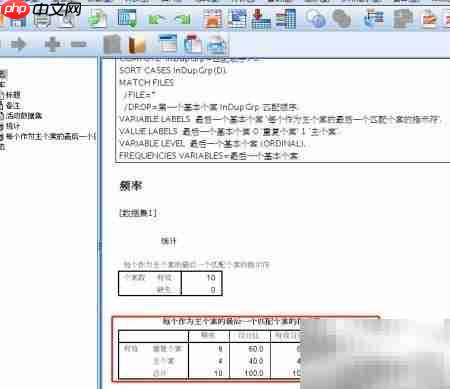
5、执行结果将在输出查看器中呈现,频率统计表显示总样本量为10条,其中被识别为重复的个案共计6条。
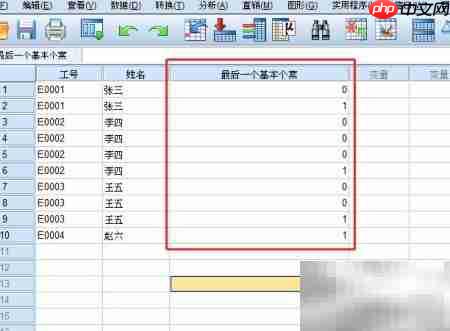
6、回到数据视图界面,可发现数据末尾新增一列名为“FirstLast”的新变量,其取值仅为0或1;切换至变量视图,可见该变量标签注明:“0=重复个案,1=首次出现个案”。
7、为高效剔除重复项,建议对新增列进行升序排序:右键单击该列列名,在快捷菜单中选择【升序排列】,此时所有值为0的行将集中排列于数据顶部。
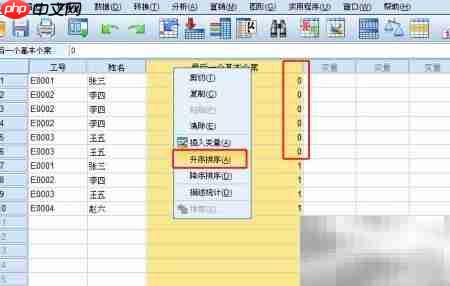
8、选中顶部连续多行(即“FirstLast”值为0的全部行),右键点击左侧行号区域,选择【清除】命令,即可批量删除重复记录。
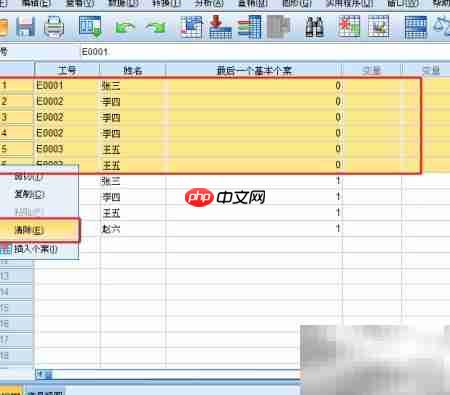
9、最终保留4条唯一记录,原始重复数据已全部清理完毕。至此,SPSS中基于多字段组合判重的标准操作流程顺利完成。