




Nginx需用nginx_upstream_check_module实现主动健康检查,替代max_fails+fail_timeout的被动模式;须源码打补丁编译,upstream中配置check指令启用定时探活,并配check_status页面与proxy_next_upstream兜底。
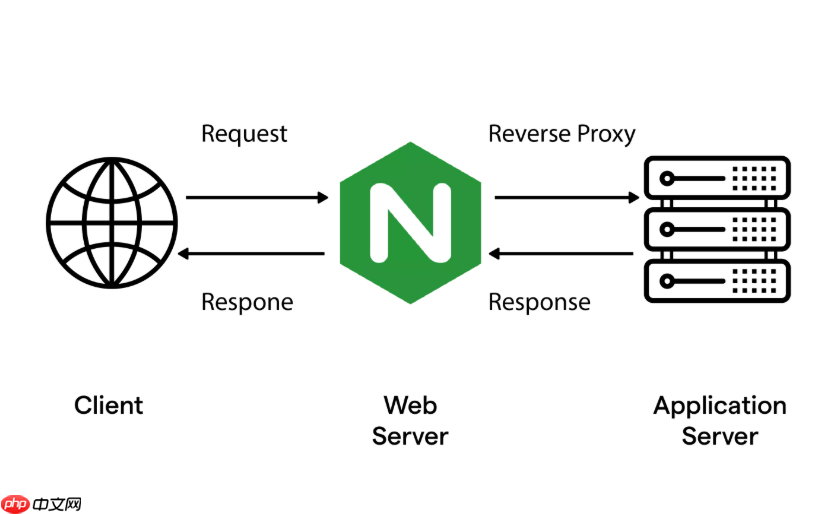
要让 Nginx 真正做到“未病先防”,就得用 nginx_upstream_check_module 实现主动健康检查——它不是等用户请求失败才反应,而是自己定时发心跳探活,实时踢出或恢复后端节点。
为什么必须换掉默认的被动检查
原生 upstream 的 max_fails + fail_timeout 是典型的“事后补救”:第一个访问故障节点的用户必然收到 502/超时;若后端进程僵死但端口仍通,Nginx 就会持续转发请求,直到堆积超时;节点恢复后还要等一次成功探测才能上线,中间存在服务空窗期。这些都不是高可用系统能容忍的。
模块安装:打补丁 + 重新编译是唯一路径
该模块未被官方集成,必须源码编译。关键步骤如下:

- 下载与当前 Nginx 版本严格匹配的源码包(如 nginx-1.28.0)和对应版本的 check 模块(推荐 v0.4.0)
- 从模块包中选取最接近且不高于 Nginx 版本的补丁文件(例如 nginx-1.28.0 应选 check_1.26.1+.patch)
- 进入 Nginx 源码目录执行 patch -p1
- configure 时加入 --add-module=/path/to/nginx_upstream_check_module-0.4.0,其他参数建议与原安装一致(可通过 nginx -V 查看)
- make && make install 完成部署,验证 nginx -V 输出中是否含 check_module 字样
配置主动检查:在 upstream 块内加 check 指令
启用后,检查逻辑完全脱离用户请求流,独立运行:
- 在 upstream 块中为每个 server 行添加 check 参数,例如:
server 192.168.1.101:8080 weight=1 max_fails=3 fail_timeout=30s check interval=3 rise=2 fall=3 timeout=1; - interval=3 表示每 3 秒探测一次;rise=2 表示连续 2 次成功则标记为健康;fall=3 表示连续 3 次失败才下线;timeout=1 控制单次探测超时为 1 秒
- 支持 http、https、tcp、mysql 多种检查类型,默认为 http;可配合 check_http_send / check_http_expect 自定义请求头与期望响应内容
- 健康状态页面需单独配置一个 location,例如 location /status { check_status; },便于人工或监控系统轮询
搭配 proxy_next_upstream 提升容错纵深
即使启用了主动检查,仍建议保留 proxy_next_upstream 配置作为兜底:
- 在 location 块中设置 proxy_next_upstream error timeout http_502 http_504;这样当某次探测漏判或网络抖动导致单次转发失败时,Nginx 仍可自动重试其他节点
- 注意:proxy_next_upstream 不会触发节点下线,只做单次请求重发;真正剔除节点靠的是 upstream 中的 check 机制
- 两者协同,既避免首请求失败,又防止探测间隙出现流量误打,形成双重保障














