


之前我们介绍了基于 Transformer 和扩散模型(Diffussion Model)的序列建模(sequence modelling)方法在强化学习,特别是离线连续控制领域的应用。这其中 Trajectory Transformer(TT)和 Diffusser 属于基于模型的规划型算法,它们展现出了非常高精度的轨迹预测已经很好的灵活性,但是相对来说决策延迟也比较高。尤其是 TT 将每个维度独立离散化作为序列中的符号,这使得整个序列变得非常长,而且序列生成的耗时会随着状态和动作的维度提升快速升高。
为了让轨迹生成模型能被达到实用级别的决策速度,我们在和 Diffusser 平行(有重叠但是应该稍晚)的时候开始了高效轨迹生成与决策的项目。我们首先想到的是用连续空间内的 Transformer+Mixture of Gaussian 而非离散分布来拟合整个轨迹分布。虽然不排除实现上的问题,但是这种思路下我们没能获得一个比较稳定的生成模型。随后我们尝试了 Variational Autoencoder(VAE),并且取得了一定的突破。不过 VAE 的重建(reconstruction)精度不是特别理想,使得下游的控制表现和 TT 相差比较大。在几轮迭代之后,我们最终选定了 VQ-VAE 作为轨迹生成的基础模型,最终得到了一个能高效采样和规划,并且在高维度控制任务上表现远超其它基于模型方法的新算法,我们称为 Trajectory Autoencoding Planner(TAP)。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
- 项目主页:https://sites.google.com/view/latentplan
- 论文主页:https://arxiv.org/abs/2208.10291
规划效率与高维下的表现
在单个 GPU 下,TAP 能轻松以 20Hz 的决策效率进行在线决策,在低维度的 D4RL 任务中下决策延迟只有 TT 的 1% 左右。更重要的是随着任务状态和动作维度 D 的增加,TT 的理论决策延迟会以三次方增长 ,Diffusser 理论上会线性增长
 ,而 TAP 的决策速度则不受维度影响
 。而在智能体的决策表现方面,随着动作维度增高,TAP 相对于其它方法的表现出现了提升,相对于基于模型方法(如 TT)的提升尤为明显。
决策延迟对决策和控制任务的重要性是非常明显的,像 MuZero 这样的算法虽然在模拟环境中表现优异,但是面对现实世界中需要实时快速响应的任务,过高的决策延迟就会成为它部署的一大困难。此外,在拥有模拟环境的前提下,决策速度慢也会导致类似的算法的测试成本偏高,同时被运用在在线强化学习中的成本也会比较高。
此外,我们认为让序列生成建模方法能顺利扩展到维度较高的任务上也是 TAP 一个很重要的贡献。现实世界中我们希望强化学习能最终解决的问题其实大都有较高的状态和动作维度。比如对于自动驾驶来说,各路传感器的输入哪怕经过各种感知层面的预处理也不太可能小于 100。复杂的机器人控制往往也有很高的动作空间,人类的所有关节自由度大概是 240 左右,也就对应了至少 240 维的动作空间,一个和人一样灵活的机器人也需要同样高维的动作空间。
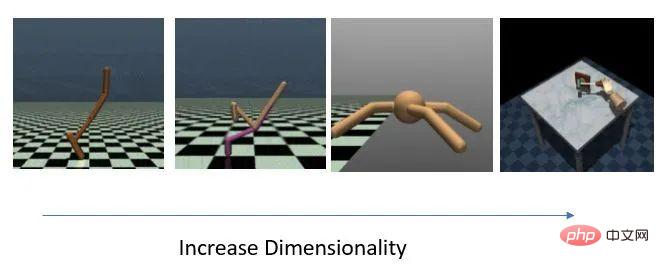
四组维度逐渐升高的任务
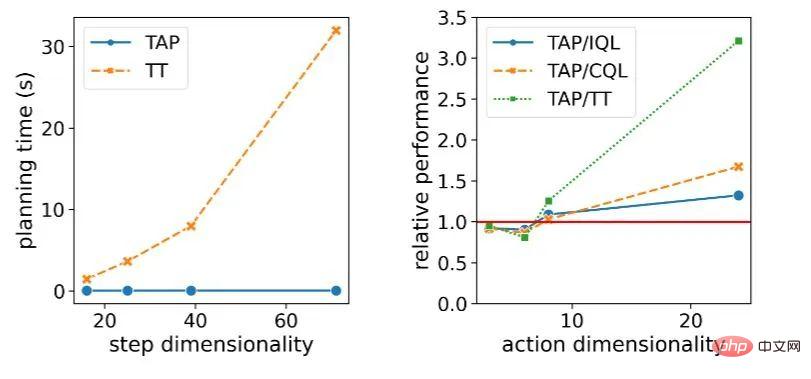
决策延迟和相对模型表现随着任务维度增长的变化
方法概述
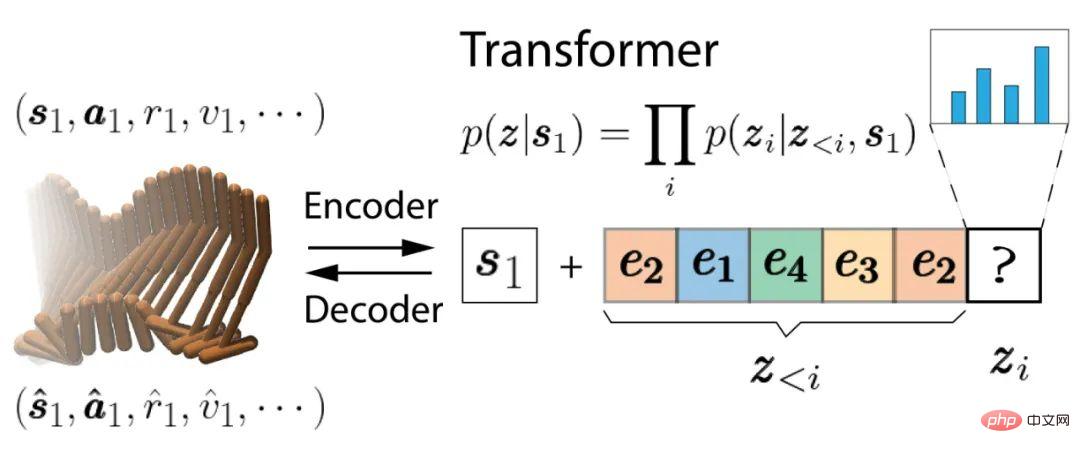
首先,训练 VQ-VAE 的自编码器 (autoencoders) 部分,这里和原本 VQ-VAE 有两个不同。第一个不同是编码器和解码器都是基于 Causal Transformer,而不是 CNN。第二个不同则是我们学习了一个条件概率分布,被建模的可能的轨迹都必须从当前状态  出发。自编码器学习一个从当前状态
 开始的轨迹和隐编码(latent codes)之间的双向映射。这些隐编码和原本轨迹一样按时间顺序排列,每个隐编码会被对应到实际
 步轨迹。因为我们使用了 Causal Transformer,时间排位靠后的隐编码 (如
 ) 不会将信息传到排位靠前的序列(如
 ),这使得 TAP 可以通过前 N 个隐编码部分解码出长度为 NL 的轨迹,这在后续用它进行规划时是非常有用的。
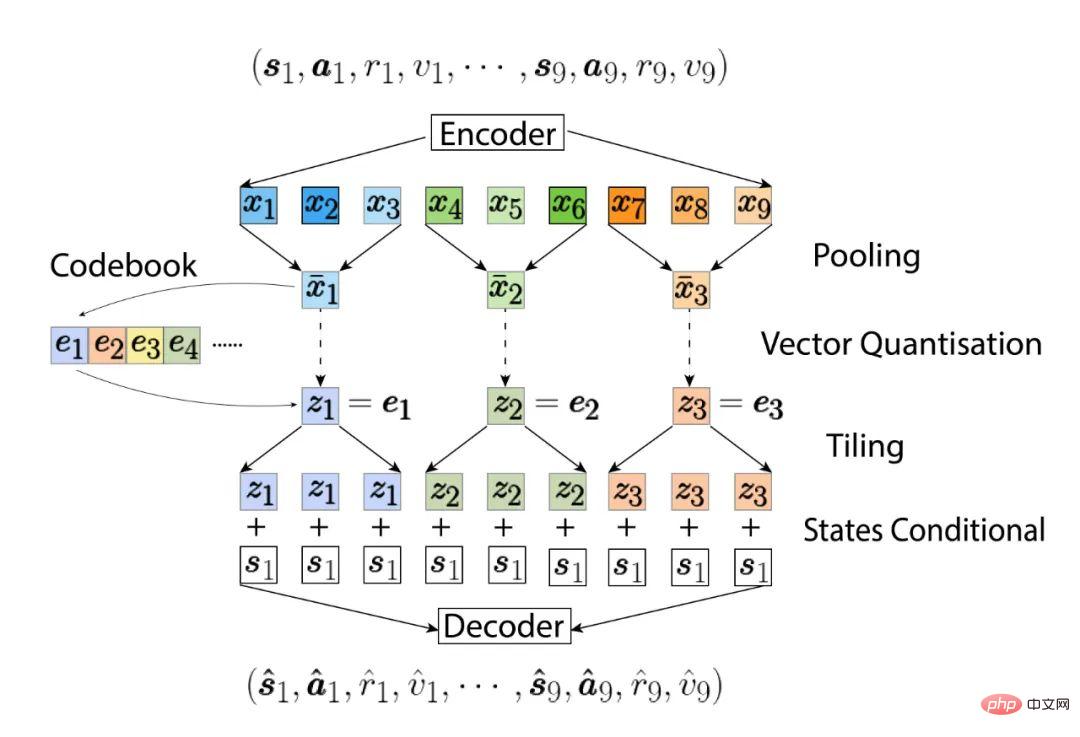
随后我们会用另一个 GPT-2 式的 Transformer 来建模这些隐编码的条件概率分布  :
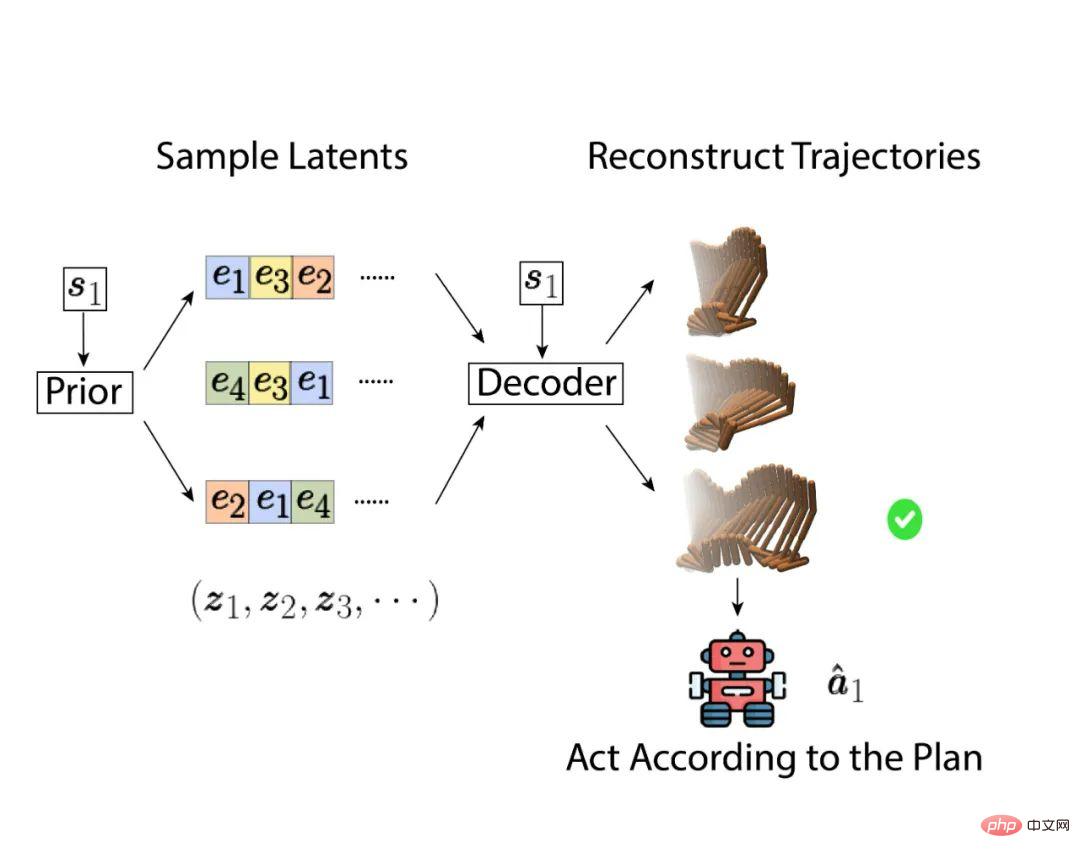
在决策时,我们可以通过在隐变量空间内进行优化寻找最好的未来轨迹,而不是在原动作空间进行优化。一个非常简单但也能起效的方法就是直接从隐编码的分布中进行采样,然后选取表现最好的轨迹,如下图:
在选择最优轨迹的时候参考的目标分数 (objective score) 会同时考虑轨迹的预期收益(奖励加最后一步的估值)和这条轨迹本身的可行性或者说概率。如下面这个公式,其中  是一个远大于最高 return 的数,当轨迹的概率高于一个阈值
 ,评判这条轨迹的标准会是它的预期收益(红色高亮),否则这条轨迹的概率本身将会是主导部分(蓝色高亮)。也就是说 TAP 会在大于阈值的轨迹中选择一条预期收益最高的。
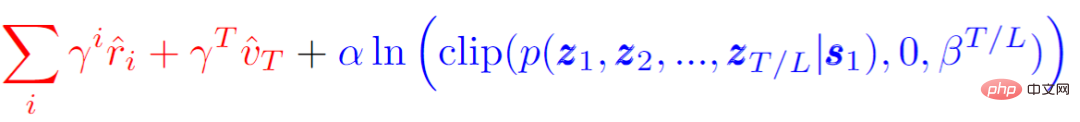
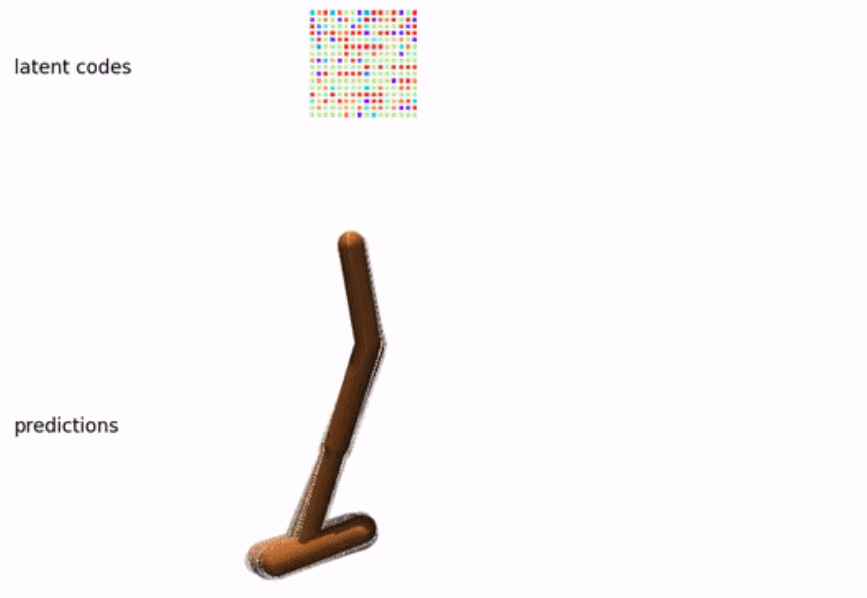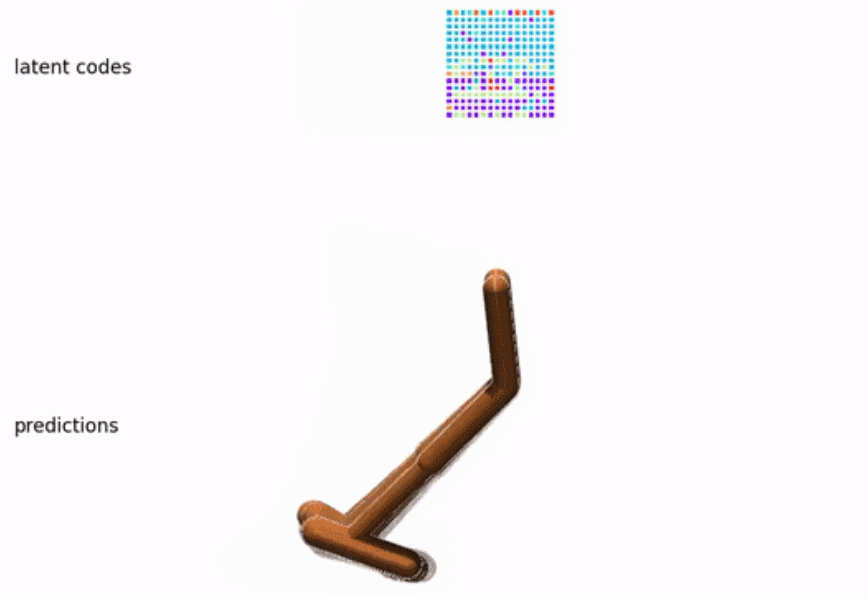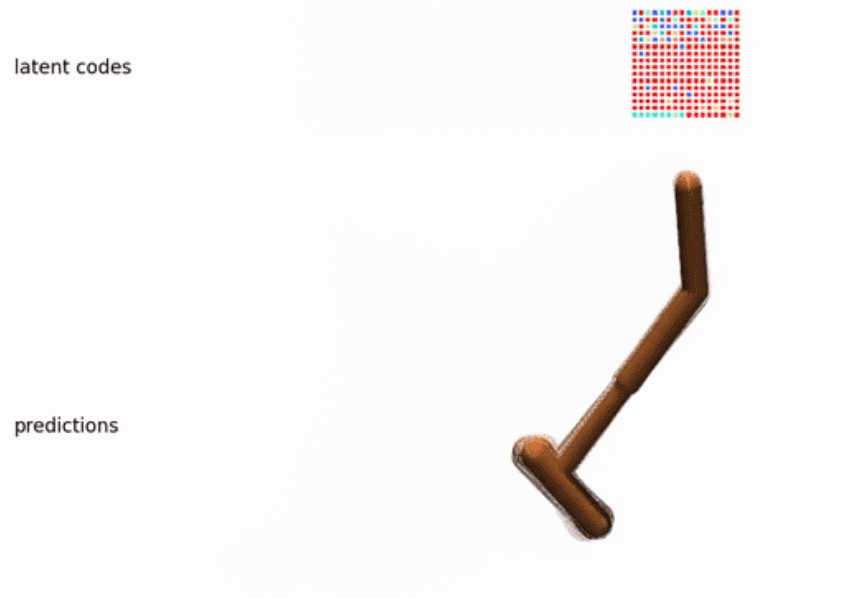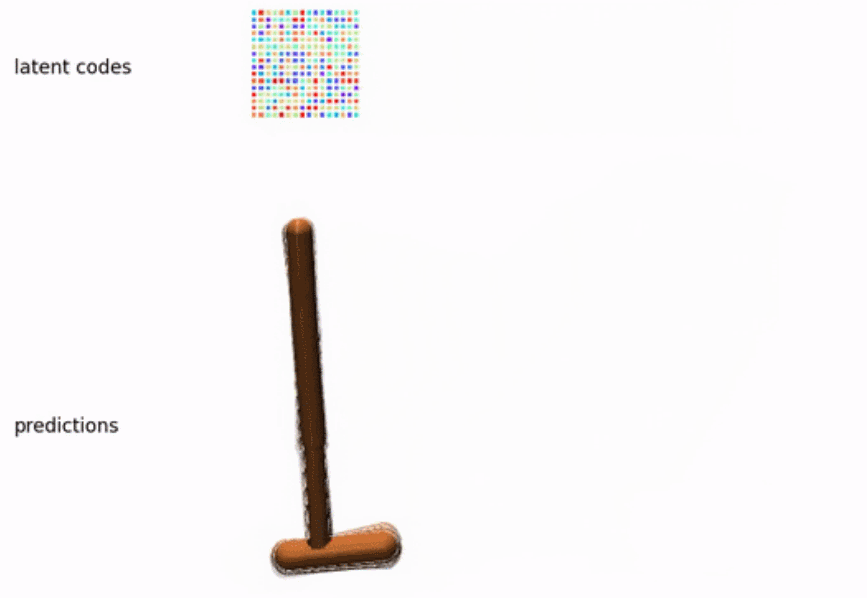
虽然采样数量足够大了以后直接采样在预测序列较短的时候效果也可以很好,在限制采样数量和规划所需的总时间的前提下,用更好的优化器还是会带来更好的表现。以下两个动图展示了当要预测未来 144 步以后用直接采样和 beam search 产生的轨迹的区别。这些轨迹被按最后的目标分数排序,在最上层最前面的轨迹分数越高,在被叠在后面的轨迹分数越低。另外分数低的轨迹同时透明度也会越低。
在图中我们可以看到直接采样产生的轨迹很多动态都不太稳定也不太符合物理规律,尤其是背景里比较淡的轨迹几乎都是飘着走的。这些都是概率比较低的轨迹,在最终选择方案的时候会被剔除。在最前排的轨迹看起来动态要更真实一些,但是相对应的表现就比较差,似乎要摔倒了。而相比之下,beam search 在展开下一个隐变量的时候就会动态考虑轨迹的概率,使得概率很低的分支会被提前终结,这样产生的候选轨迹就都集中在表现较好而且可能性比较大的轨迹周围了。
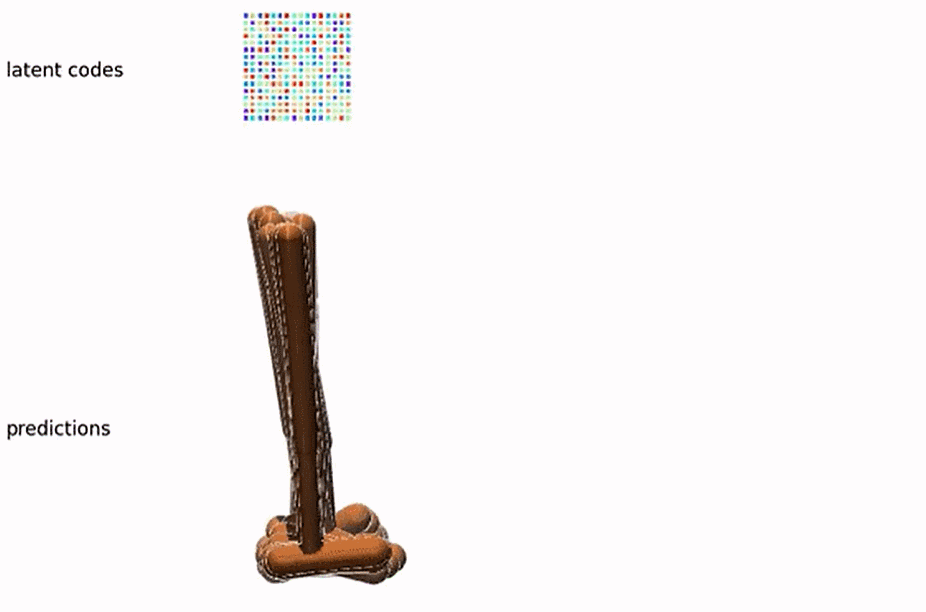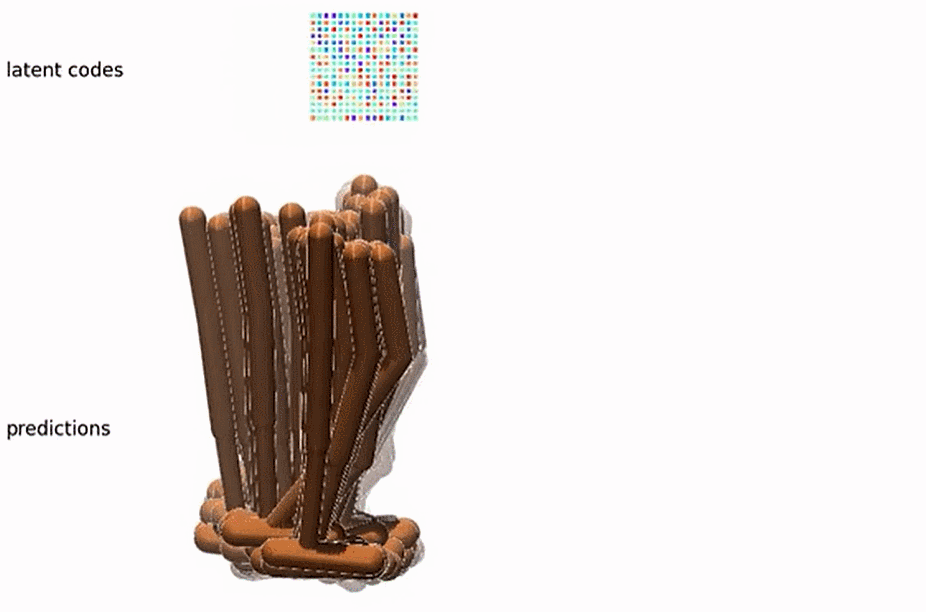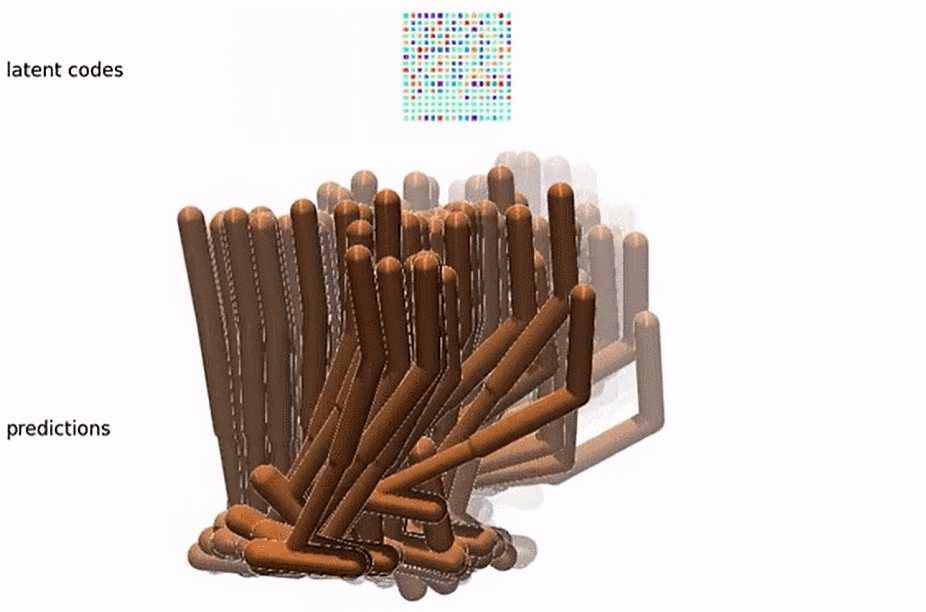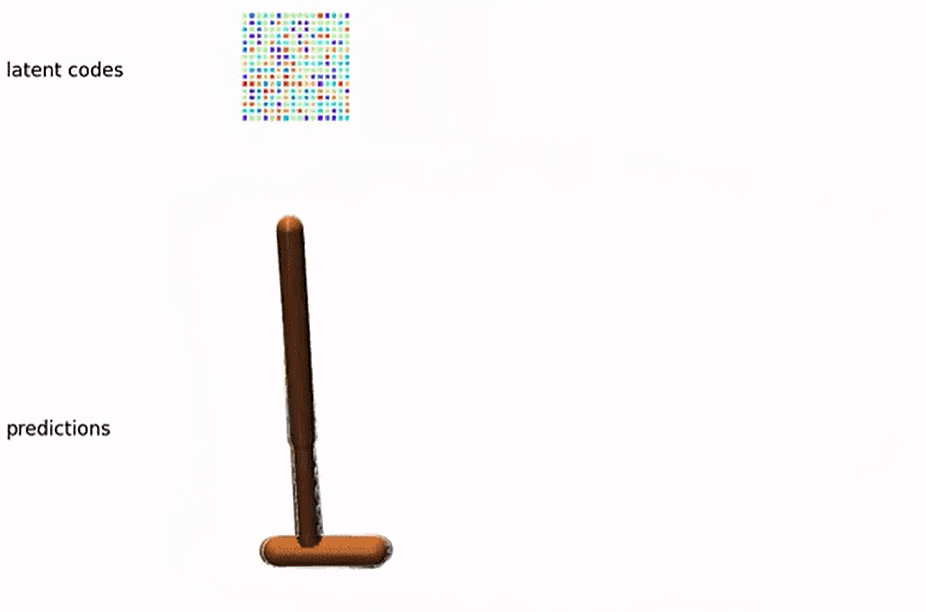
直接采样
Beam search
实验结果
在没有更高级的估值以及策略提升的情况下,仅仅依靠预测精度的优势,在低维度的任务上 TAP 就取得了和其它离线强化学习相当的表现:
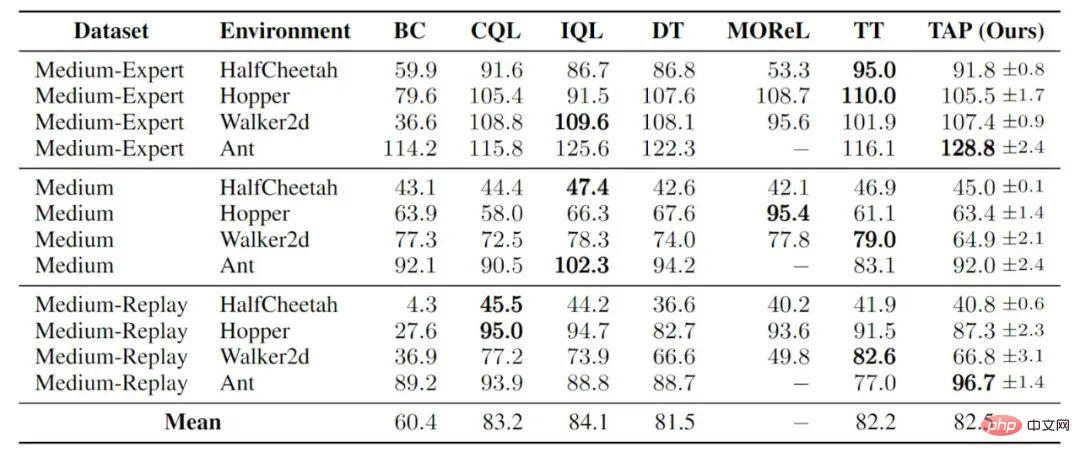
gym locomotion control
在高维的任务上,TAP 取得了远超其它基于模型的方法的表现,同时也胜过了常见的无模型方法。这里其实有两个还未有解答的开放性问题。首先是为什么此前基于模型的方法在这些高维度的离线强化学习任务中表现较差,其次是为什么 TAP 在这些任务上表现又能反超很多无模型方法。我们的一个假设是因为在高维问题上进行策略优化又要考虑防止策略偏离行为策略太多是非常困难的。当学习了一个模型,模型本身的误差可能还会放大这种困难。而 TAP 将优化空间搬到了一个很小的离散隐变量空间,这使得整个优化过程的鲁棒性更强了。
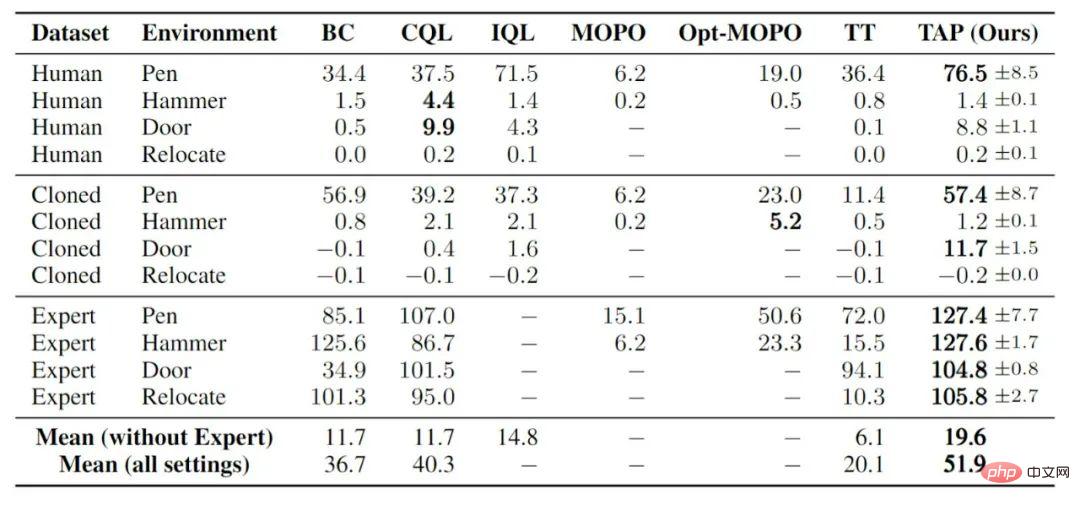
adroit robotic hand control
一些切片研究
对于 TAP 里面的诸多设计,我们也在 gym locomotion control 的任务上做了一系列切片研究。首先是每个隐编码实际对应的轨迹的步数 (黄色柱状图),事实证明让一个隐变量对应多步状态转移不光有计算上的优势,在最后模型表现上也有提升。通过调节搜索的目标函数中触发低概率轨迹惩罚的阈值
 (红色柱状图),我们也确认了目标函数中两个部分确实都对模型最后表现是有帮助的。另外一点就是向未来规划的步数(planning horizon,蓝色柱状图)对模型表现的影响反而不大,在部署后的搜索中哪怕只展开一个隐变量最后智能体的表现也只会降低 10% 左右。
最后我们尝试了直接采样的情况下 TAP 的表现(绿色柱状图)。注意这里的采样的样本数量是 2048 而上面的动图里只有 256,而且上面的动图是生成了未来 144 步的规划,但是实际我们的基础模型指挥规划 15 步。结论是直接采样在样本数量足够的情况下,且规划路径不长,那么直接采样也能获得和 beam search 相近的表现。但是这是从学到的隐变量条件分布中采样的情况,如果直接从隐编码中直接等概率采样,那最后还是会比完整的 TAP 模型差很多。
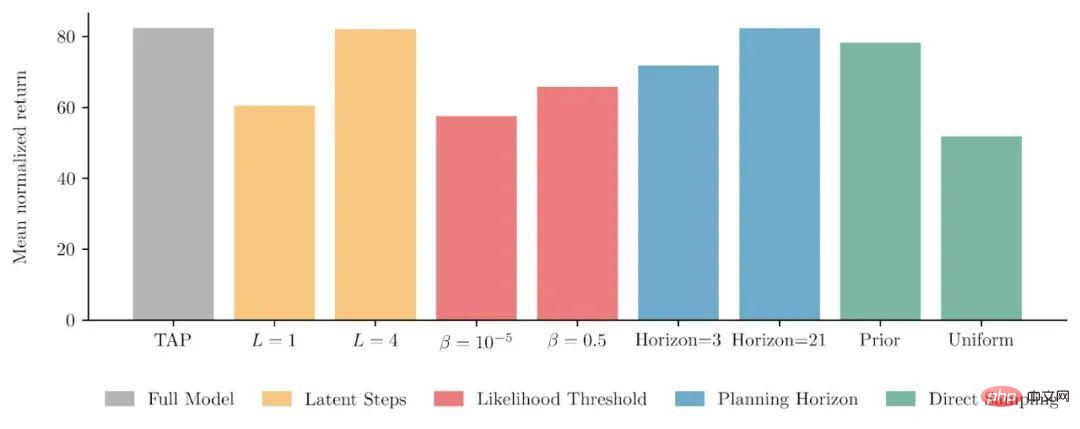
切片研究的结果













