XORM框架怎么优化大批量数据的查询性能
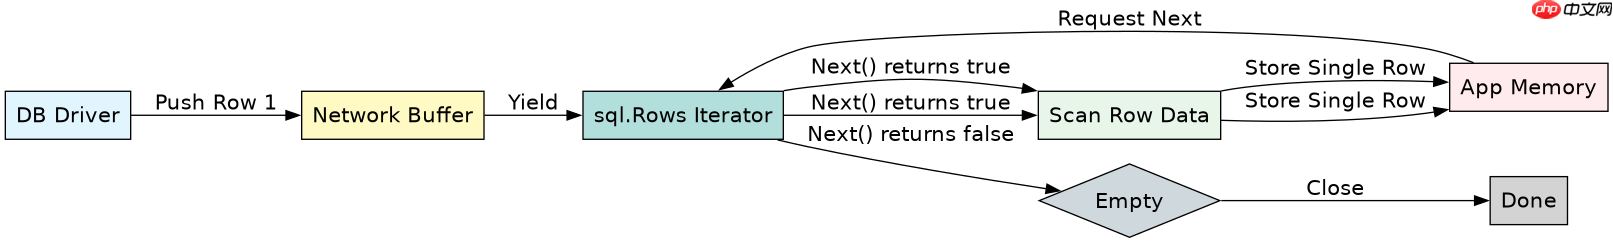
使用xorm进行大批量数据查询时,核心优化手段是启用流式查询(stream)或游标模式,避免一次性将全量数据加载到内存中。具体做法是在调用`rows()`方法获取结果集后,通过`next()`和`scan()`逐行处理数据,或者结合`limit`与`offset`进行分页拉取。这样做可以显著降低内存占用,防止因oom导致的服务崩溃,同时保持稳定的cpu利用率。
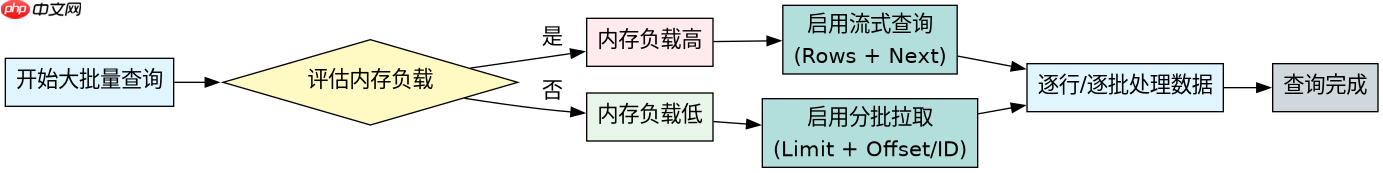
如何正确实现基于游标的分批拉取逻辑
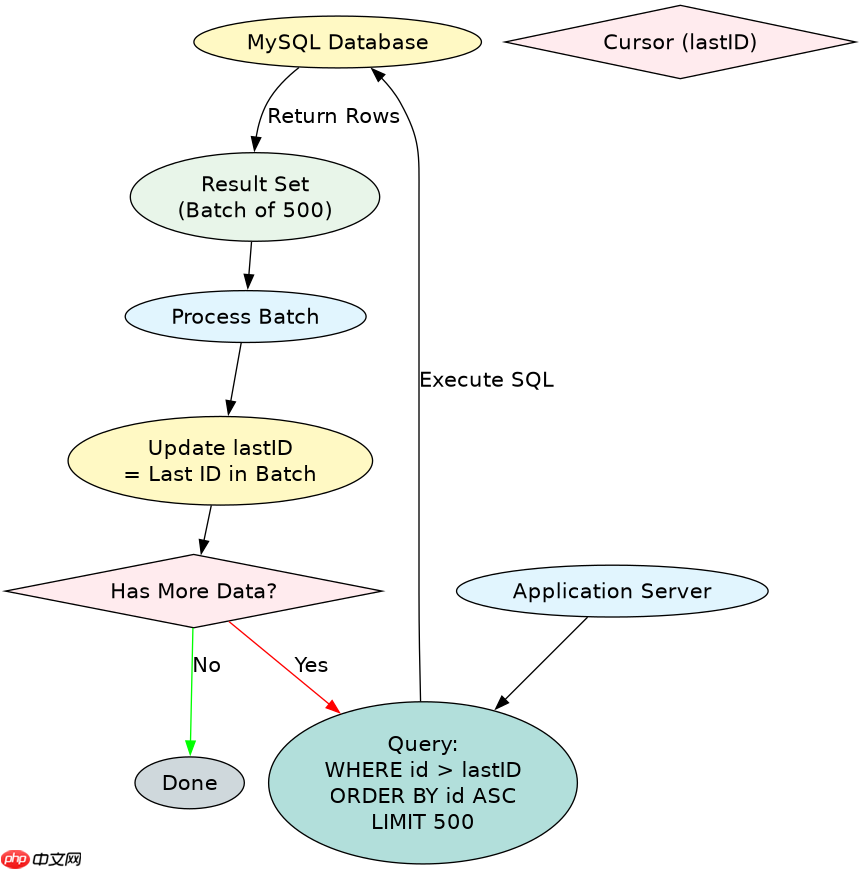
在需要处理数百万级数据且必须保证顺序的场景下,推荐使用基于主键或唯一索引的分批拉取策略。通过维护一个`lastID`变量,每次查询`WHERE id > lastID ORDER BY id ASC LIMIT 500`,可以有效利用数据库索引快速定位下一批数据,避免深度分页带来的性能衰减。这种写法比传统的`OFFSET`方式在大数据量下快得多,因为数据库无需扫描并跳过前面的大量记录。
package main

import (
    "fmt"
    "log"
    "github.com/xormplus/xorm"
)

// User 定义用户结构体
type User struct {
    ID   int64  `xorm:"pk autoincr"`
    Name string `xorm:"varchar(100) notnull"`
}

func main() {
    // 初始化引擎
    engine, err := xorm.NewEngine("mysql", "user:pass@tcp(127.0.0.1:3306)/dbname")
    if err != nil {
        log.Fatal(err)
    }
    defer engine.Close()

    // 设置最大并发连接数,避免连接池耗尽
    engine.SetMaxOpenConns(10)
    engine.SetMaxIdleConns(5)

    // 分批拉取示例
    var lastID int64
    batchSize := 500
    totalProcessed := 0

    for {
        var users []User
        // 关键:使用 Where 和 Order By 配合 Limit 进行游标分页
        err := engine.Where("id > ?", lastID).
            OrderBy("id ASC").
            Limit(batchSize, 0).
            Find(&users)
        if err != nil {
            log.Fatal(err)
        }

        if len(users) == 0 {
            break
        }

        // 处理当前批次数据
        for _, u := range users {
            fmt.Printf("Processing user: %d - %s\n", u.ID, u.Name)
            // 这里执行你的业务逻辑,如写入另一个表、计算等
        }

        totalProcessed += len(users)
        // 更新 lastID 为当前批次的最后一条记录的 ID
        lastID = users[len(users)-1].ID

        // 可选:添加短暂休眠,减轻数据库压力
        // time.Sleep(10 * time.Millisecond)
    }
    fmt.Printf("Total processed: %d\n", totalProcessed)
}
上述代码展示了标准的游标分页实现。输入条件是数据库中已存在按自增ID排序的用户数据。实际运行结果是程序不会一次性加载所有用户对象,而是分批次处理。预期输出包括每行的处理日志以及最终的总处理数量。注意,`OrderBy`必须与`Where`条件中的字段一致,通常选择主键,以确保查询效率最高。如果主键不连续,该策略依然有效,因为它只依赖相对大小关系。
流式查询在处理超大结果集时的具体表现
当数据量极大且不需要复杂业务逻辑处理,仅需简单导出或转换时,XORM的`Rows()`方法提供的流式接口更为高效。它直接映射到底层数据库驱动的结果集迭代器,几乎不占用额外内存。通过`Next()`遍历每一行,并使用`Scan()`将列值填充到结构体或变量中,可以实现真正的零缓冲处理。这种方式适用于ETL任务或数据备份场景,能最大程度减少GC压力。
package main

import (
    "database/sql"
    "fmt"
    "log"
    "github.com/xormplus/xorm"
)

func streamQueryExample(engine *xorm.Engine) error {
    // 使用 Rows 获取原生 sql.Rows
    rows, err := engine.QueryRows("SELECT id, name FROM user")
    if err != nil {
        return err
    }
    defer rows.Close()

    // 定义用于接收数据的变量
    var id int64
    var name string

    // 逐行读取
    for rows.Next() {
        err := rows.Scan(&id, &name)
        if err != nil {
            return err
        }
        // 处理单条数据
        fmt.Printf("Streamed: ID=%d, Name=%s\n", id, name)
    }
    return rows.Err()
}

func main() {
    engine, _ := xorm.NewEngine("mysql", "user:pass@tcp(127.0.0.1:3306)/dbname")
    defer engine.Close()

    if err := streamQueryExample(engine); err != nil {
        log.Fatal(err)
    }
}
这段代码演示了流式查询的具体用法。输入是简单的SELECT语句,不涉及复杂的JOIN。实际行为是数据库服务器逐行推送数据,客户端内存中仅保留当前这一行的数据副本。预期结果是控制台持续打印用户信息,直到结果集结束。若遇到网络中断或SQL语法错误,`rows.Err()`会返回相应的错误信息。这种模式特别适合那些对内存敏感且处理逻辑简单的场景,避免了`Find()`方法将所有结果构建为切片所带来的内存峰值。