








xorm框架中逐行扫描结果集的正确做法是调用 rows() 方法获取 *sql.rows 对象,随后使用 next() 推进游标,并通过 scan() 将当前行数据映射到结构体实例。该方法适用于处理可能返回大量数据的查询,因为它不会一次性将所有结果加载到内存中,而是按需读取每一行。

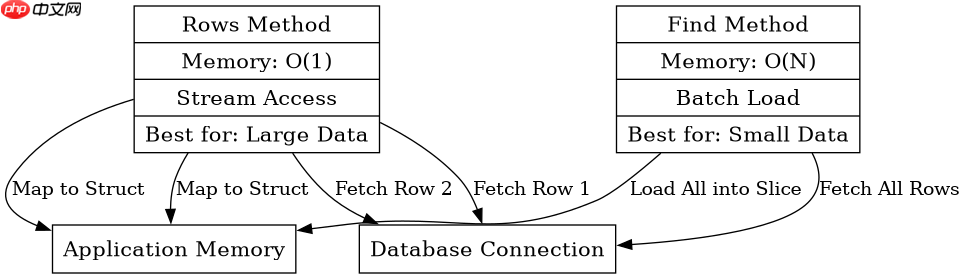
Rows() 与 Find() 在内存占用上的区别是什么
Rows() 采用流式读取,内存占用恒定且极低;而 Find() 会将所有匹配记录一次性加载到切片中,内存随数据量线性增长。对于百万级数据,必须使用 Rows() 以避免内存溢出。
package main

import (
    "fmt"
    "log"
    "github.com/xormplus/xorm"
)

type User struct {
    Id   int64
    Name string
}

func main() {
    engine, err := xorm.NewEngine("mysql", "user:pass@tcp(127.0.0.1:3306)/db")
    if err != nil {
        log.Fatal(err)
    }
    defer engine.Close()

    rows, err := engine.Table("users").Where("age > ?", 18).Rows()
    if err != nil {
        log.Fatal(err)
    }
    defer rows.Close()

    var user User
    for rows.Next() {
        err = rows.Scan(&user)
        if err != nil {
            log.Fatal(err)
        }
        fmt.Printf("ID: %d, Name: %s\n", user.Id, user.Name)
    }
}
上述代码针对 users 表中年龄大于18的记录进行流式遍历。预期输出为每行打印对应的 ID 和 Name,程序在处理过程中内存峰值仅维持在一个结构体的大小。
如何在使用 Rows() 时安全地关闭资源并处理错误
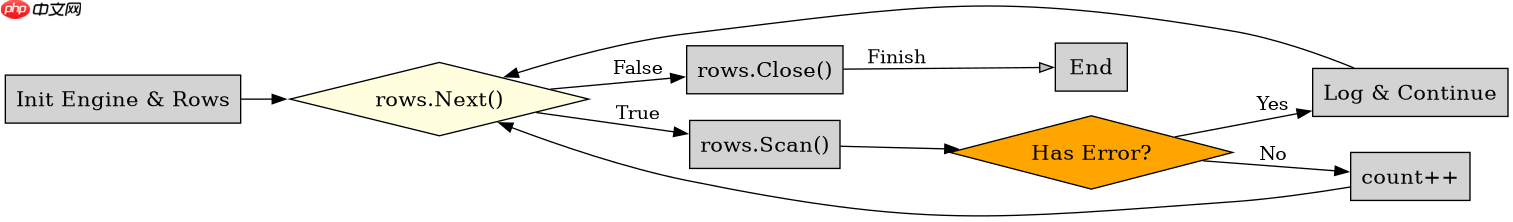
必须在获取 Rows 后立即通过 defer rows.Close() 确保连接释放,且在循环内部检查 Scan 的返回值以捕获类型转换或数据库读取错误。若忽略 Close 会导致数据库连接泄漏,忽略 Scan 错误则可能导致静默的数据截断或程序崩溃。
package main

import (
    "fmt"
    "log"
    "github.com/xormplus/xorm"
)

type Product struct {
    Id      int64
    Price   float64
    IsStock bool
}

func main() {
    engine, _ := xorm.NewEngine("sqlite3", "test.db")
    defer engine.Close()

    rows, err := engine.Table("products").Cols("id", "price", "is_stock").Rows()
    if err != nil {
        log.Fatal(err)
    }
    defer rows.Close()

    var p Product
    count := 0
    for rows.Next() {
        err = rows.Scan(&p.Id, &p.Price, &p.IsStock)
        if err != nil {
            fmt.Println("Scan error at row ", count, ":", err)
            continue // 跳过错误行,继续处理后续行
        }
        count++
    }
    fmt.Printf("Total processed: %d\n", count)
}
该示例展示了在 SQLite 环境下对特定列进行扫描的逻辑。当某一行数据存在类型不匹配时,Scan 会返回错误,代码通过 continue 跳过该行并记录日志,最终统计成功处理的行数。这种模式确保了即使部分数据异常,程序也能继续运行并给出准确的处理计数。
当查询结果为空时 Rows() 的行为表现如何
当查询条件未匹配任何记录时,Rows() 返回的对象依然有效,但 Next() 会立即返回 false,导致循环体一次都不会执行。此时无需额外判断结果集是否为空,直接依靠循环控制即可自然结束,且不会产生任何错误或异常。


















