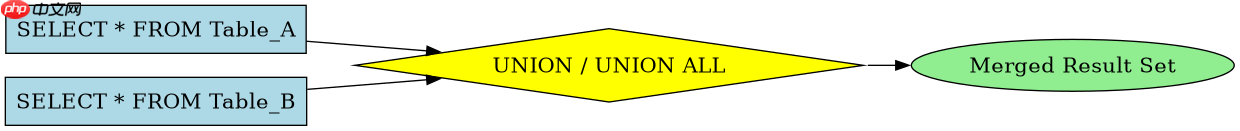
在navicat中合并两次查询的结果,核心方法是使用sql的union或union all操作符。你需要编写一个包含两个select语句的查询,中间用union连接,这样数据库引擎会将两个结果集纵向拼接并自动去重;若需保留所有重复行,则改用union all。执行该sql脚本即可在结果网格中看到合并后的数据。
UNION与UNION ALL的区别是什么
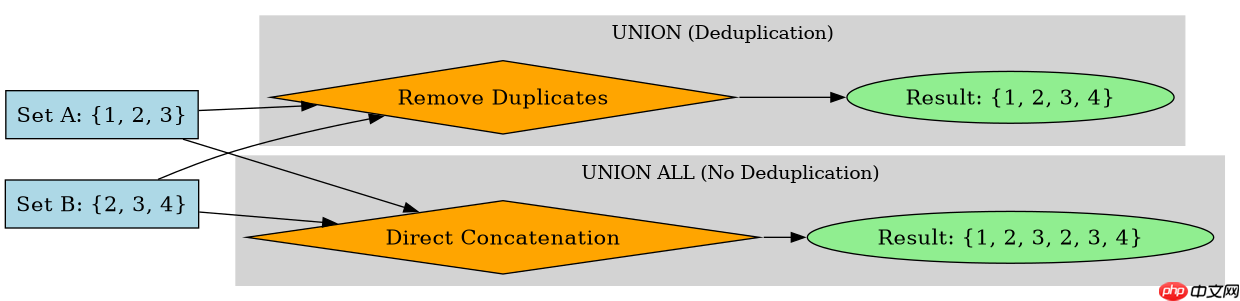
UNION和UNION ALL的主要区别在于对重复行的处理。UNION会自动去除两个结果集中完全相同的重复行,这涉及额外的排序和去重开销;而UNION ALL直接简单拼接两个结果集,不进行去重检查,因此执行速度通常更快。选择哪种方式取决于你是否需要唯一的数据记录。

Navicat Premium 17.1
下载
Navicat Premium 17.1 Windows x64 历史系列获取入口。该系列扩展 Garnet、PolarDB 等连接支持,并增强可视化查询解释与 Redis 树视图;未核实到公开固定安装包直链。
SELECT id, name FROM users WHERE status = 'active'
UNION
SELECT id, name FROM users WHERE status = 'inactive';

-- 预期结果:所有状态的用户列表,无重复(id, name)组合

SELECT id, name FROM users WHERE status = 'active'
UNION ALL
SELECT id, name FROM users WHERE status = 'inactive';

-- 预期结果:所有状态的用户列表,包含重复(id, name)组合(如果存在)
如何确保两个查询结果的列结构一致
在使用UNION合并查询时,必须确保两个SELECT语句的列数相同,且对应位置的数据类型兼容。如果列数不一致或类型不匹配,数据库会报错。你可以通过在SELECT子句中指定具体的列名或使用常量占位来调整结构,保证两边对齐。
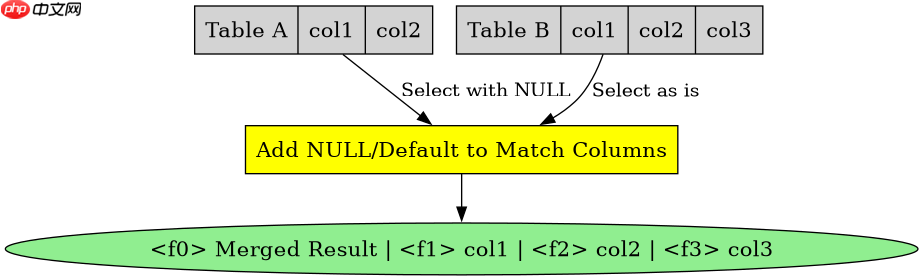
-- 假设表A有col1, col2,表B有col1, col2, col3
-- 错误示例:列数不一致
SELECT col1, col2 FROM table_A
UNION
SELECT col1, col2, col3 FROM table_B;

-- 正确示例:通过NULL或默认值补齐列数
SELECT col1, col2, NULL AS col3 FROM table_A
UNION
SELECT col1, col2, col3 FROM table_B;
合并结果后如何按特定字段排序
当使用UNION合并结果后,如果需要按特定字段排序,必须在整个UNION查询的最后添加ORDER BY子句。注意,ORDER BY只能引用第一个SELECT语句中定义的列名或别名,不能直接使用第二个SELECT中的原始列名,除非它们具有相同的名称或别名。此外,ORDER BY通常作用于最终合并后的完整结果集。