








在sql中处理多语言字符集查询乱码,核心在于确保数据库连接层、会话层和存储层统一使用utf-8编码(如`utf8mb4`),并在客户端显式设置字符集。只要连接建立时未指定正确的字符集,或者数据写入与读取的编码不一致,就会导致非ascii字符显示为乱码。

如何验证当前连接的字符集设置
要确认当前环境是否支持多语言,需检查会话级别的字符集变量。通过执行查询语句查看`character_set_connection`和`collation_connection`,可以判断当前会话使用的编码是否与数据库默认一致。如果不一致,后续的所有字符串操作都可能产生乱码。
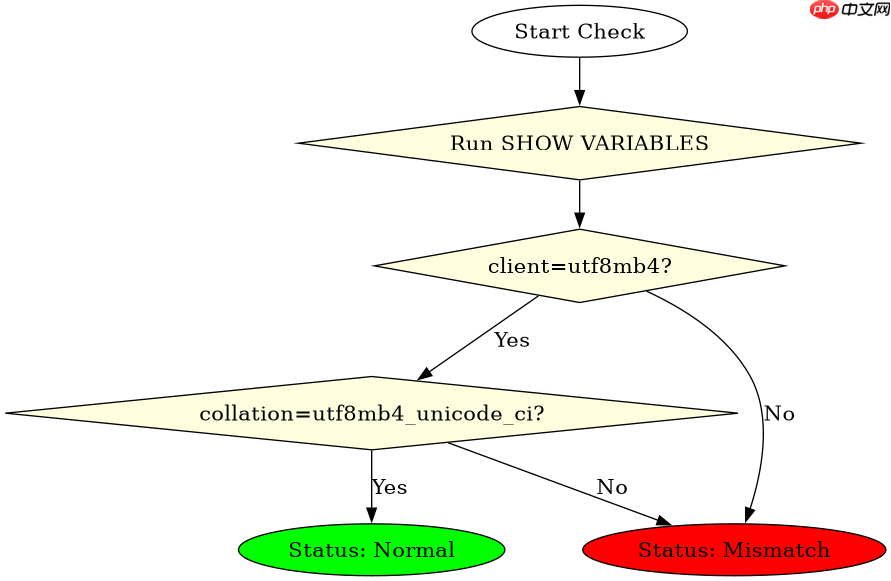
SHOW VARIABLES LIKE 'character_set%';
SHOW VARIABLES LIKE 'collation%';
上述命令会列出服务器和会话级别的字符集配置。重点关注`character_set_client`(客户端发送数据的编码)、`character_set_connection`(转换用的中间编码)和`character_set_results`(返回给客户端的编码)。如果这三者均为`utf8mb4`,则基础环境正常。

为跨境电子商务生成多语言、SEO 优化的产品描述。支持英语、西班牙语、俄语和阿拉伯语,并针对不同搜索引擎(Google / Bing、Yandex、中东市场)进行专项 SEO 优化。适用于以下场景:用户需为国际市场创建符合 SEO 规范的产品文案、批量生成产品描述,或针对特定搜索引擎及区域用户偏好优化内容。
如何在应用代码中强制指定字符集
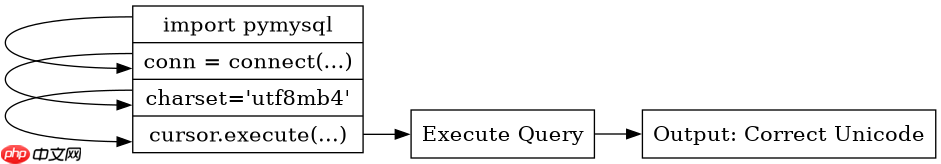
在编写数据库连接代码时,必须在连接字符串或初始化参数中明确指定字符集。以Python的`pymysql`库为例,可以在连接参数中添加`charset='utf8mb4'`。这样即使服务器默认配置有误,客户端也能强制使用正确的编码进行通信,从而避免乱码。
import pymysql

conn = pymysql.connect(
    host='localhost',
    user='root',
    password='password',
    database='test_db',
    charset='utf8mb4'
)
cursor = conn.cursor()
cursor.execute("SELECT * FROM users WHERE name = %s", ('张三',))
print(cursor.fetchall())
这段代码展示了如何通过编程方式确保连接使用`utf8mb4`。执行后,无论输入的是中文、Emoji还是其他多语言字符,都能正确存入并读取。若省略`charset`参数,则依赖驱动程序的默认行为,这在不同版本间可能不一致,存在风险。
当表中已存在乱码数据时如何修复
如果数据库中已经存储了乱码数据,通常是因为早期写入时使用了错误的字符集(如将UTF-8字节流误认为Latin1存储)。修复方法是先备份数据,然后修改表结构而不重新导入。通过`ALTER TABLE ... CONVERT TO CHARACTER SET utf8mb4`,MySQL会重新解释现有字节并转换为新编码。此操作不可逆,务必先备份。
,

















