








在sql server 2019中,通过 approx_count_distinct 函数可以实现对重复数据的近似去重统计。该函数返回的是基于hyperloglog算法估算的唯一值数量,而非精确计数,因此在数据量极大且允许一定误差的场景下能显著提升性能。
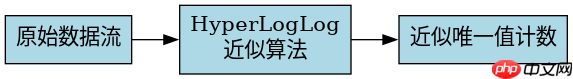
如何替换传统的COUNT(DISTINCT)进行查询
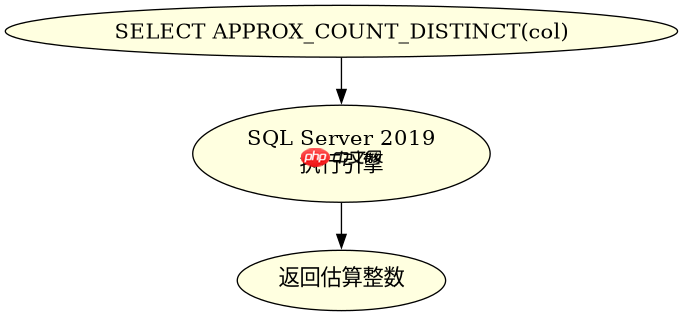
将原有的 COUNT(DISTINCT) 语法直接替换为 APPROX_COUNT_DISTINCT 即可生效。例如,在统计用户表中的唯一IP地址时,只需修改聚合函数名,无需改变其他逻辑结构。
SELECT APPROX_COUNT_DISTINCT(ip_address) AS approx_unique_ips
FROM user_logs;
上述代码执行后,数据库引擎会使用近似算法快速扫描索引或堆表,返回一个接近真实值的整数结果。相比传统方法,它避免了昂贵的排序和哈希去重操作。
如何处理高基数列的精度权衡
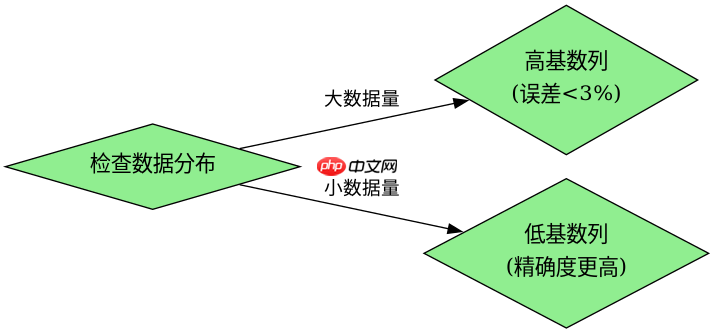
当处理包含数百万甚至数十亿条记录的列时,APPROX_COUNT_DISTINCT 的误差率通常控制在3%以内。开发者需要在查询性能与数据准确性之间做出选择,若业务场景允许轻微偏差,此函数是优化长耗时查询的有效手段。
SELECT
    category,
    APPROX_COUNT_DISTINCT(user_id) AS approx_users
FROM transactions
GROUP BY category;
分组查询同样适用该函数。在执行按类别分组的大规模数据分析时,使用近似去重可以大幅缩短响应时间,适用于报表预览或实时大屏展示等对毫秒级延迟敏感的场景。
基于特定输入条件的性能表现差异
针对包含大量空值(NULL)的数据集,APPROX_COUNT_DISTINCT 会自动忽略空值参与计算,这与 COUNT(DISTINCT) 的行为一致。但在极端 skewed(偏斜)分布的数据下,其估算稳定性优于某些自定义哈希方案,适合用于初步筛选异常数据源。




















