








在sql中根据多重业务条件动态调整rank排序,核心做法是利用窗口函数 rank() 或 dense_rank(),并在 order by 子句中通过 case when 表达式构建复合优先级。具体而言,将不同业务维度的条件转化为数值权重(如0或1),按权重降序排列,再辅以次要字段(如时间戳)确保结果稳定。这样做可以直接在查询层实现复杂的排序逻辑,无需在应用层进行二次处理。

如何为不同状态的用户设置优先显示顺序
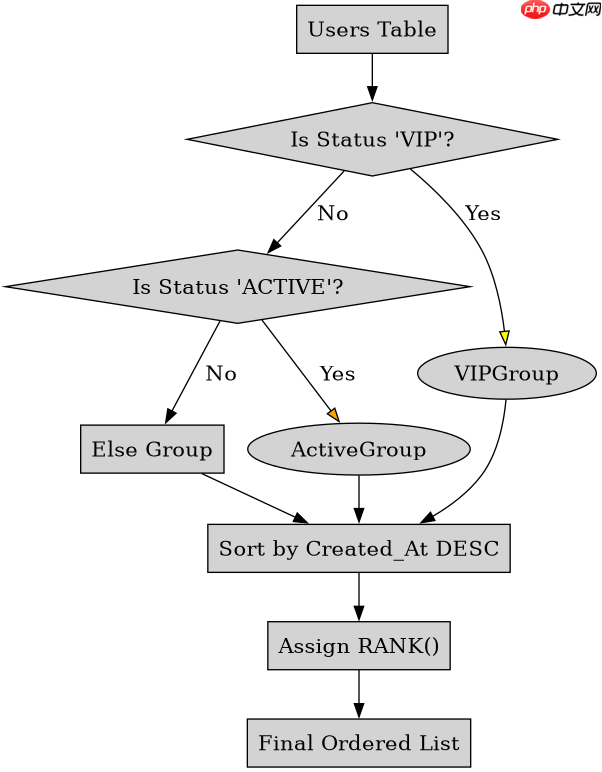
针对用户列表展示场景,若需优先显示“VIP”用户,其次显示“活跃”用户,最后显示“普通”用户,可以通过在 ORDER BY 中嵌套 CASE 语句来实现。该方案假设输入为用户表 users,包含 status 和 created_at 字段。执行此查询后,系统将严格按照预设的优先级层级对数据进行重排,同优先级内则按注册时间倒序排列。
SELECT
    id,
    username,
    status,
    created_at,
    RANK() OVER (ORDER BY
        CASE status
            WHEN 'VIP' THEN 1
            WHEN 'ACTIVE' THEN 2
            ELSE 3
        END ASC,
        created_at DESC
    ) as priority_rank
FROM users;
预期结果:所有 status 为 'VIP' 的记录排在最前,其内部按 created_at 从新到旧排序;接着是 'ACTIVE' 用户;最后是其他状态用户。排名列 priority_rank 会反映这一分组后的相对位置。
如何处理多条件冲突时的并列排名问题
当业务要求在同一优先级组内,若存在多个相同权重的记录,需要明确是否允许并列排名以及并列后的次级排序规则时,选择 RANK() 与 DENSE_RANK() 会产生不同的结果分布。RANK() 会在出现并列时跳过后续名次,而 DENSE_RANK() 则连续排名。本节以订单表为例,演示如何在金额相同的情况下,依据下单时间打破平局并生成最终序列。

SELECT
    order_id,
    amount,
    order_time,
    RANK() OVER (ORDER BY amount DESC, order_time ASC) as rank_result
FROM orders;
预期结果:高金额订单排在前面。若两笔订单金额相同,则较早时间的订单排名更靠前(因 order_time ASC)。若金额和时间完全一致,RANK() 会赋予相同的排名值,且下一个不同金额的订单排名会跳过中间空缺的数字。
基于特定输入条件下的排名边界情况验证
在上述程序中,如果输入数据中存在 NULL 值的 status 或 amount,排序行为会发生显著变化。默认情况下,大多数数据库(如 MySQL、PostgreSQL)在 ASC 排序时将 NULL 视为最小值,在 DESC 排序时视为最大值。但在 CASE 表达式中,未匹配的 NULL 会落入 ELSE 分支。例如,若 status 为 NULL,它会被归类为优先级 3 的普通用户,而非被排除或单独处理。这种隐式转换可能导致非预期的排序结果,特别是在混合了有效状态和空值的数据集中。


















