








google的harness自我改进实验显示,整体重写运行框架与逐模块验证,可能在成功率和token成本上走向不同结果。固定gemini 3.8 flash时,整体重写方案在保留测试上达到42.5%,平均每题451.6k token;模块化验证方案为40.0%,平均46.7k token。前者成功率略高,后者成本更低,不能只挑一个指标宣布全面胜出。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
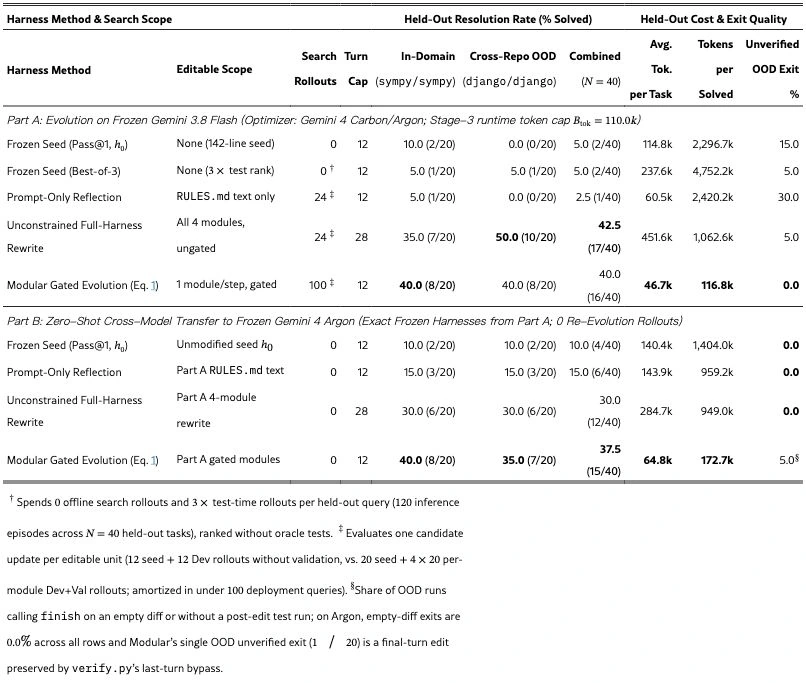
图源:原始论文Table IV,CC BY 4.0;结果对应指定模型与任务划分。
增加回合可能把上下文成本一起放大
整体重写方案把回合上限由12提高到28,却没有同时压缩近期文件与Shell输出;论文报告其中一次运行超过2.8M Token。模块化方案保留12回合限制,逐项验证上下文整理、工具接口和结束检查等改动,并拒绝超过成本约束的候选。
换更强模型后也没有沿用同一排名
将已形成的框架直接迁移到Gemini 4 Argon、且不重新调优时,模块化方案的保留测试成功率为37.5%,整体重写为30.0%。这说明某个模型上允许更长运行的方案,不一定能以相同比例迁移到另一模型;数据也不代表基础模型本身变差或变强了多少。

Google Workspace MCP 服务器通过任何支持 MCP 的 AI 助手,提供对 Gmail、Google Calendar、Drive、Docs、Sheets、Slides、Forms、Tasks、Contacts 和 Chat 的全面自然语言控制。它支持 OAuth 2.1 多用户认证,并包含用于编码代理的 CLI。
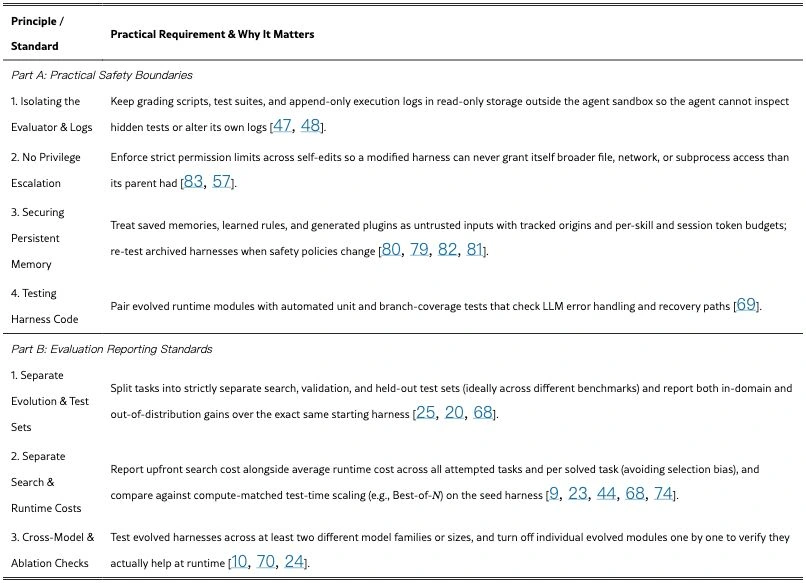
图源:原始论文Table III,CC BY 4.0;评估器及审计边界应置于可修改运行代码之外。
必须同时评估质量、运行成本和优化成本
论文中的每题成本来自其运行环境,外部优化搜索也有额外开销。比较时应保持题目划分、模型与输入条件一致,区分开发分数、保留测试、运行Token及搜索成本。验证器不能被候选补丁随意修改,否则更高分数可能来自评估被绕过。
这项结果支持在实际工作负载上联合检查任务完成率、失败类型和消耗,而不是把压缩上下文或限制回合作为通用节省保证。上述结论限于论文所用的模型、框架与任务集合,不能替代其他系统自己的测量。

















