








优化sql中group by字段的隐式类型转换,核心做法是确保聚合字段与过滤或分组条件的数据类型严格一致,避免数据库引擎在运行时进行自动转换。当发生隐式转换时,通常是因为比较操作的一方被强制转换,导致索引失效和全表扫描。通过显式转换或修改列类型,可以消除这种开销并提升查询性能。
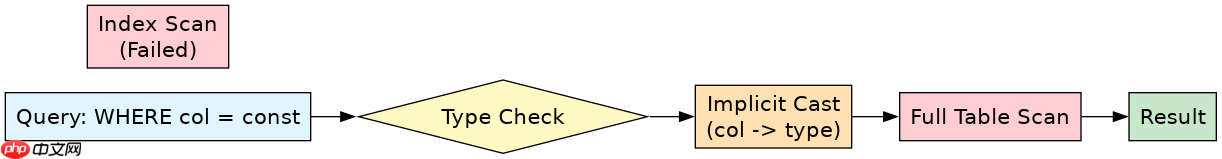
为什么GROUP BY会触发隐式类型转换
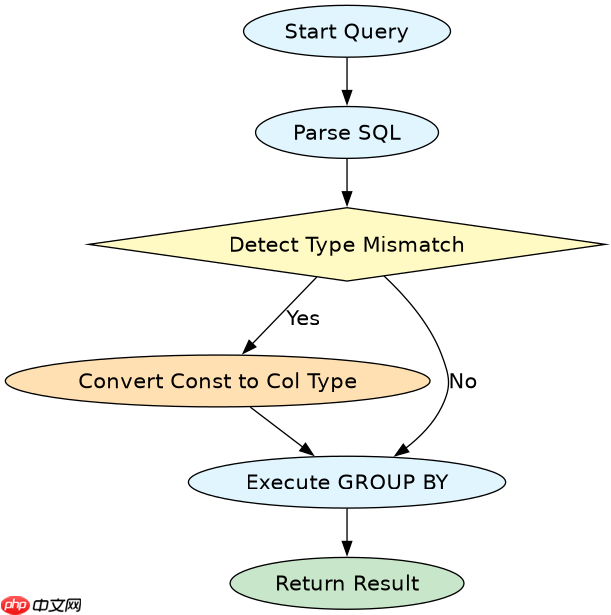
当GROUP BY的字段与WHERE条件中的常量或另一列类型不匹配时,数据库为了进行比较,会对其中一个操作数进行隐式转换。最常见的情况是将字符串类型的列与整数常量比较,或者将数字列与字符串比较。这种转换发生在每一行数据上,不仅增加了CPU计算负担,更致命的是它阻止了B-Tree索引的使用,因为索引存储的是原始类型的数据,而转换后的值无法直接映射到索引树上。
SELECT user_id, COUNT(*)
FROM orders
WHERE status = 1001
GROUP BY user_id;
假设orders表的status列定义为VARCHAR(50),而查询中传入的是整数1001。MySQL等数据库会对status列执行CAST(status AS SIGNED)操作。这导致全表扫描,且GROUP BY阶段也需要对每行数据进行额外的类型检查和转换,显著降低效率。
如何显式处理类型以优化性能
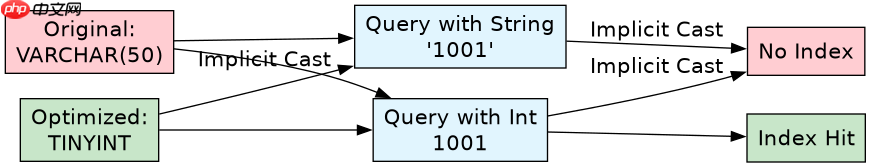
解决该问题的最直接方法是修改查询语句,使用CAST或CONVERT函数显式地将常量转换为列的类型,或者反之。虽然显式转换仍然可能无法利用索引(取决于具体数据库实现),但它明确了开发者的意图,并且避免了因类型推断错误导致的逻辑问题。更根本的解决方案是修改表结构,将列的类型改为与业务逻辑最匹配的类型,例如将存储状态的VARCHAR改为TINYINT或ENUM。
SELECT user_id, COUNT(*)
FROM orders
WHERE status = '1001'
GROUP BY user_id;
如果status列确实是VARCHAR,那么将查询中的整数1001改为字符串'1001',就可以避免隐式转换。这样数据库可以直接使用status列上的索引进行查找,然后对结果集进行GROUP BY操作。这是在不改变表结构前提下的最佳实践。如果经常需要按数值范围查询状态,则应考虑重构表结构,将status改为INT类型,并将所有相关查询调整为整数比较。
基于orders表status列类型为VARCHAR的具体问题
在orders表中,如果status列定义为VARCHAR(50),且存在大量查询需要按状态码进行分组统计,那么任何涉及数值比较的GROUP BY查询都会面临性能瓶颈。例如,当执行GROUP BY status WHERE status > 1000时,数据库必须逐行将VARCHAR转换为整数进行比较。这种操作在大数据量下会导致严重的I/O等待和CPU飙升。优化方案包括:一是将所有涉及状态比较的查询统一使用字符串格式;二是评估业务需求,若状态码固定且数量少,可将列类型改为TINYINT并重建索引;三是使用覆盖索引,确保查询只涉及索引列,减少回表带来的额外处理开销。


















