








php 计算字符串相似度通常使用 similar_text() 函数,该函数通过计算两个字符串的相似字符数并转换为百分比来返回结果。调用时传入两个字符串变量及一个用于接收结果的引用参数即可得到具体的相似度数值。需要注意的是,该算法基于最长公共子序列原理,对于长字符串或差异较大的字符串,计算耗时可能较高,且结果受字符顺序影响较大。
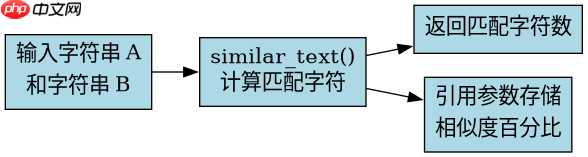
similar_text() 函数的基本用法与返回值是什么
similar_text() 函数直接接受两个字符串作为输入,并通过第三个引用参数输出相似度百分比。它返回的是实际匹配的字符数量,而相似度百分比则存储在传入的引用变量中。例如比较 "hello" 和 "hallo",函数会识别出大部分字符相同,从而给出较高的相似度评分。这种机制允许开发者同时获取原始匹配数和归一化后的比例,便于在不同场景下灵活处理。
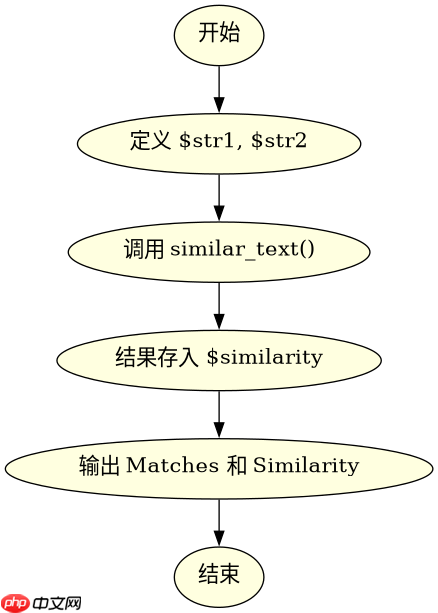
$str1 = "hello world";
$str2 = "helo world";
$similarity = 0;
$matches = similar_text($str1, $str2, $similarity);
echo "Matches: $matches\n";
echo "Similarity: $similarity%";
预期输出: Matches: 9 Similarity: 81.818181818182%
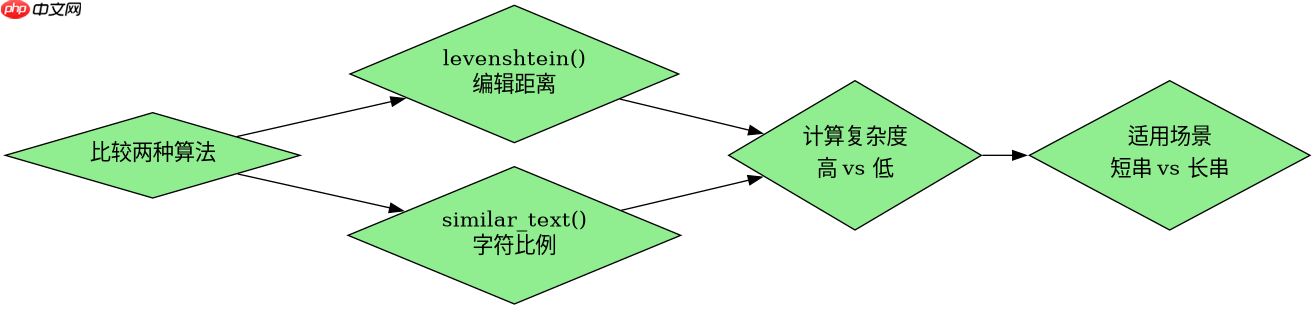
如何对比 levenshtein() 与 similar_text() 的差异
levenshtein() 函数计算的是编辑距离,即通过插入、删除或替换字符将一个字符串转换为另一个所需的最少操作次数,数值越小表示越相似。而 similar_text() 关注的是共同字符的数量比例。两者在短字符串上表现接近,但在长字符串或包含大量重复字符时,levenshtein() 的计算复杂度呈立方级增长,而 similar_text() 相对较快但可能忽略局部错位的影响。选择哪种方法取决于对“相似”的定义是侧重操作成本还是字符重合度。

使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
立即学习“PHP免费学习笔记(深入)”;
$str1 = "kitten";
$str2 = "sitting";
$dist = levenshtein($str1, $str2);
$sim = 0;
similar_text($str1, $str2, $sim);
echo "Levenshtein Distance: $dist\n";
echo "Similar Text: $sim%";
预期输出: Levenshtein Distance: 3 Similar Text: 57.142857142857%
当字符串包含特殊字符或大小写混合时,相似度计算结果有何变化
当字符串包含特殊字符或大小写混合时,similar_text() 和 levenshtein() 均默认区分大小写,且特殊字符被视为独立字符参与计算。这意味着 "Hello" 和 "hello" 会被视为不同,相似度会降低;而 "a!b" 和 "a b" 也会因标点符号的存在导致匹配数减少。若需忽略大小写或特殊字符,应在计算前使用 strtolower() 或正则表达式进行预处理,否则直接计算会得到偏低的相似度分数,无法反映语义上的真实相似性。



















