








使用 linq 的 orderby 配合 list.indexof 即可实现。核心做法是将目标列表传入 orderby,在排序委托中调用参考列表的 indexof 方法获取每个元素的索引位置,从而按参考列表的顺序对目标列表进行重排。
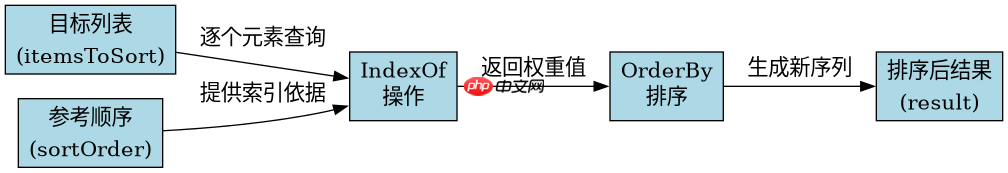
如何确保不在参考列表中的元素排在末尾?
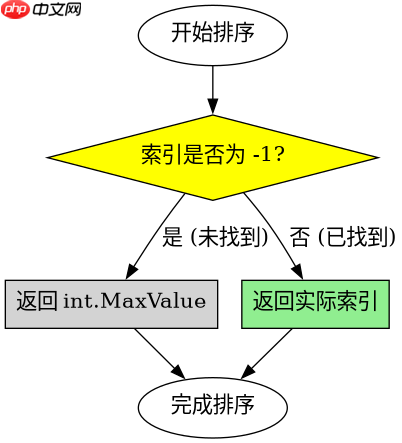
默认情况下 IndexOf 找不到元素会返回 -1,这会导致未匹配项被排到最前面。解决方法是在委托中加入判断,若索引为 -1 则赋予一个大于参考列表长度的值(如 int.MaxValue),这样它们就会自然沉底。
using System;
using System.Collections.Generic;
using System.Linq;

class Program
{
    static void Main()
    {
        // 定义参考顺序
        List<string> sortOrder = new List<string> { "Apple", "Banana", "Cherry" };

        // 定义需要排序的目标列表(包含参考列表外的元素)
        List<string> itemsToSort = new List<string> { "Cherry", "Date", "Apple", "Banana", "Elderberry" };

        // 执行排序:匹配项按索引升序,未匹配项排在最后
        var result = itemsToSort.OrderBy(x =>
        {
            int index = sortOrder.IndexOf(x);
            return index == -1 ? int.MaxValue : index;
        }).ToList();

        Console.WriteLine(string.Join(", ", result));
    }
}运行上述代码,预期输出结果为:Apple, Banana, Cherry, Date, Elderberry。其中 Date 和 Elderberry 因为不在 sortOrder 中,所以被排在了后面,且保持了它们在原列表中的相对顺序(稳定排序特性)。

如果两个列表都很大,这种写法性能如何?
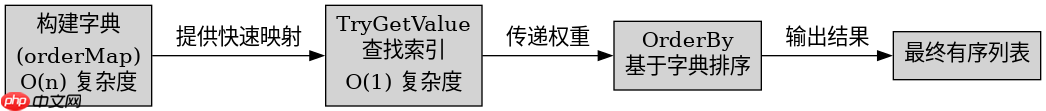
当数据量较大时,IndexOf 的时间复杂度是 O(n),嵌套在 OrderBy 中会导致整体复杂度接近 O(n^2)。此时应改用字典建立映射关系,将查找时间降为 O(1)。
using System;
using System.Collections.Generic;
using System.Linq;

class Program
{
    static void Main()
    {
        List<string> sortOrder = new List<string> { "Apple", "Banana", "Cherry" };
        List<string> itemsToSort = new List<string> { "Cherry", "Date", "Apple", "Banana", "Elderberry" };

        // 构建索引映射字典
        Dictionary<string, int> orderMap = new Dictionary<string, int>();
        for (int i = 0; i < sortOrder.Count; i++)
        {
            orderMap[sortOrder[i]] = i;
        }

        // 使用字典进行高效排序
        var result = itemsToSort.OrderBy(x =>
        {
            if (orderMap.TryGetValue(x, out int index))
            {
                return index;
            }
            return int.MaxValue;
        }).ToList();

        Console.WriteLine(string.Join(", ", result));
    }
}该优化方案同样输出:Apple, Banana, Cherry, Date, Elderberry。通过预先构建 orderMap,避免了重复遍历参考列表,适合处理成千上万条数据的场景。


















