








使用正则表达式 /[\x{4e00}-\x{9fa5}]+/u 配合 preg_match_all() 可以提取字符串中的中文内容。该函数会返回所有匹配的中文片段到一个数组中,直接处理即可得到结果。
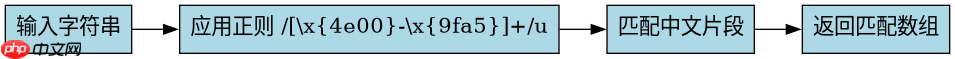
如何提取并拼接连续的中文片段?
调用 preg_match_all() 后,返回的数组包含所有匹配项,使用 implode() 将它们连接成一个完整的字符串。这种方法能保留原始顺序,适用于需要完整中文文本的场景。
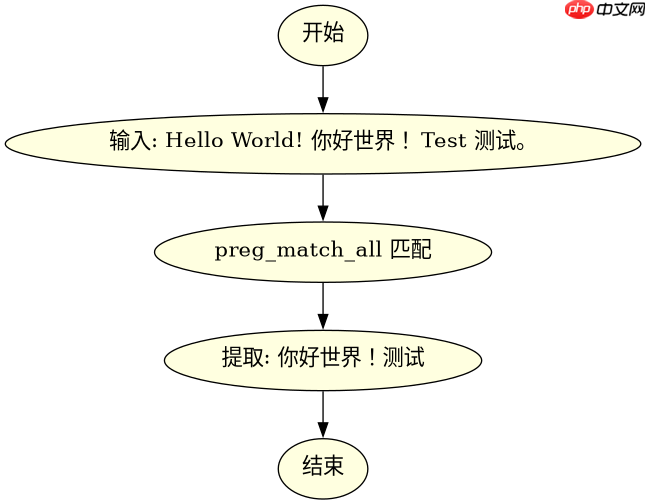
<?php
$subject = "Hello World! 你好世界! Test 测试。";
$pattern = '/[\x{4e00}-\x{9fa5}]+/u';
preg_match_all($pattern, $subject, $matches);
$result = implode('', $matches[0]);
echo $result; // 输出: 你好世界!测试
?>预期结果为:你好世界!测试。注意标点符号如感叹号不在匹配范围内,仅汉字被提取。若需包含中文标点,可调整正则范围。
立即学习“PHP免费学习笔记(深入)”;

Build MCP servers and clients for PHP applications with the official PHP SDK
下载
使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
如何处理非连续中文片段?
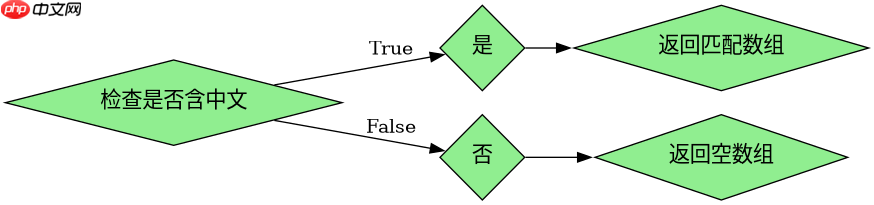
当字符串中中文片段不连续时,preg_match_all() 仍会正确识别每个独立片段。例如在混合英文和数字的字符串中,每个中文块都会被单独捕获,无需额外预处理。
<?php
$subject = "A1B2C3 中文 D4E5F6 更多中文 G7H8I9";
$pattern = '/[\x{4e00}-\x{9fa5}]+/u';
preg_match_all($pattern, $subject, $matches);
print_r($matches[0]);
?>预期输出为数组:Array ( [0] => 中文 [1] => 更多中文 )。这验证了非连续片段的正确处理。若输入为空或无中文,返回空数组,符合预期行为。
基于输入“Test 123”的提取结果是什么?
对于输入字符串 Test 123,由于不包含任何中文字符,preg_match_all() 将返回空数组。这意味着没有匹配项,程序不会抛出错误,而是安全地处理空结果。

















