








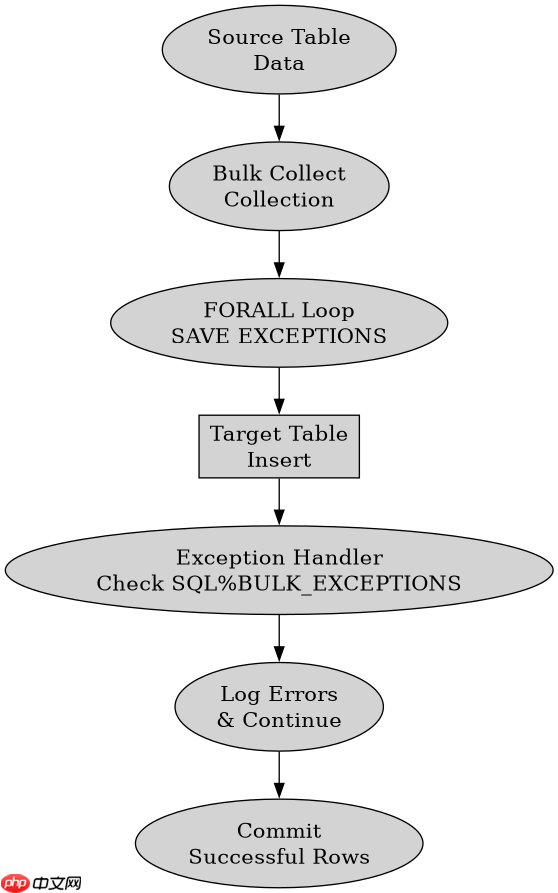
在oracle 19c中,使用 bulk collect 结合 forall ... save exceptions 是实现批量处理并忽略部分错误继续执行的标准做法。具体步骤是:先通过 bulk collect 将数据加载到集合中,然后在 forall 语句后添加 save exceptions 子句;当执行过程中发生异常时,oracle不会立即中断事务,而是记录所有失败的索引和错误信息到内置的 sql%bulk_exceptions 集合中,允许程序后续遍历该集合进行日志记录或重试。

如何编写包含SAVE EXCEPTIONS的基础代码结构
基础结构的核心在于声明集合变量、使用 BULK COLLECT INTO 获取数据,以及在 FORALL 循环中指定 SAVE EXCEPTIONS。以下是一个完整的示例,演示如何将一个包含潜在无效数据的源表批量插入到目标表中,并捕获错误。
DECLARE
    TYPE t_id_table IS TABLE OF NUMBER;
    TYPE t_name_table IS TABLE OF VARCHAR2(100);

    v_ids t_id_table;
    v_names t_name_table;

    e_bulk_exception EXCEPTION;
    PRAGMA exception_init(e_bulk_exception, -24381);
BEGIN
    -- 1. 批量收集数据
    SELECT id, name
    BULK COLLECT INTO v_ids, v_names
    FROM source_table;

    -- 2. 批量插入,保存异常
    FORALL i IN 1 .. v_ids.COUNT SAVE EXCEPTIONS
        INSERT INTO target_table (id, name)
        VALUES (v_ids(i), v_names(i));

    COMMIT;
EXCEPTION
    WHEN e_bulk_exception THEN
        -- 3. 处理异常
        FOR j IN 1 .. SQL%BULK_EXCEPTIONS.COUNT LOOP
            DBMS_OUTPUT.PUT_LINE(
                'Error at index: ' ||
                SQL%BULK_EXCEPTIONS(j).ERROR_INDEX ||
                ', Code: ' ||
                SQL%BULK_EXCEPTIONS(j).ERROR_CODE
            );
        END LOOP;
        ROLLBACK;
END;
运行上述代码时,如果 source_table 中有数据违反 target_table 的约束(如主键冲突或非空约束),FORALL 会尝试插入所有行。成功插入的行会被提交(如果在异常块外提交)或保留在事务中,而失败的行会被记录在 SQL%BULK_EXCEPTIONS 中。开发者可以通过遍历这个集合来查看哪些索引失败了以及具体的 Oracle 错误代码。
如何处理特定类型的批量错误并验证结果
在实际应用中,往往需要区分不同类型的错误并进行不同的处理。例如,主键冲突可能需要跳过,而数据类型转换错误可能需要报警。我们可以通过检查 SQL%BULK_EXCEPTIONS(j).ERROR_CODE 来实现细粒度的控制。以下代码展示了如何根据错误代码分类处理,并验证最终有多少行成功、多少行失败。

DECLARE
    TYPE t_emp_table IS TABLE OF employees%ROWTYPE;
    v_emps t_emp_table;

    v_success_count NUMBER := 0;
    v_error_count NUMBER := 0;
BEGIN
    SELECT * BULK COLLECT INTO v_emps FROM employees WHERE department_id = 10;

    FORALL i IN 1 .. v_emps.COUNT SAVE EXCEPTIONS
        INSERT INTO employees_backup (employee_id, first_name, last_name, salary)
        VALUES (v_emps(i).employee_id, v_emps(i).first_name, v_emps(i).last_name, v_emps(i).salary);

    COMMIT;
EXCEPTION
    WHEN OTHERS THEN
        IF SQLCODE = -24381 THEN
            FOR j IN 1 .. SQL%BULK_EXCEPTIONS.COUNT LOOP
                DECLARE
                    err_code NUMBER := SQL%BULK_EXCEPTIONS(j).ERROR_CODE;
                BEGIN
                    IF err_code = 1 OR err_code = 3 THEN -- 主键/唯一键冲突
                        DBMS_OUTPUT.PUT_LINE('Skipped duplicate key at index: ' || SQL%BULK_EXCEPTIONS(j).ERROR_INDEX);
                    ELSIF err_code = 1400 THEN -- NOT NULL violation
                        DBMS_OUTPUT.PUT_LINE('Null value error at index: ' || SQL%BULK_EXCEPTIONS(j).ERROR_INDEX);
                    ELSE
                        DBMS_OUTPUT.PUT_LINE('Other error ' || err_code || ' at index: ' || SQL%BULK_EXCEPTIONS(j).ERROR_INDEX);
                    END IF;
                END;
            END LOOP;
            v_error_count := SQL%BULK_EXCEPTIONS.COUNT;
            v_success_count := v_emps.COUNT - v_error_count;
            DBMS_OUTPUT.PUT_LINE('Total Processed: ' || v_emps.COUNT);
            DBMS_OUTPUT.PUT_LINE('Success: ' || v_success_count);
            DBMS_OUTPUT.PUT_LINE('Failed: ' || v_error_count);
        ELSE
            RAISE; -- 重新抛出非批量异常
        END IF;
END;
这段代码验证了 SAVE EXCEPTIONS 的行为:它允许事务继续完成,即使部分行失败。通过检查 SQL%BULK_EXCEPTIONS 的长度和内容,我们可以精确知道哪些行被跳过了。注意,COMMIT 必须在 FORALL 之后且在异常处理之前执行,以确保成功插入的行被持久化。如果希望在异常发生时回滚整个批次,可以将 COMMIT 移到异常处理块的最后,或者不提交已成功插入的行(这通常不符合业务逻辑,因为部分成功通常是可接受的)。此方法特别适用于数据清洗场景,其中少量脏数据不应阻止大量有效数据的导入。

SQL%BULK_EXCEPTIONS集合中的索引与原始集合索引有何对应关系
在使用 SAVE EXCEPTIONS 时,SQL%BULK_EXCEPTIONS 集合中的 ERROR_INDEX 字段直接对应于 FORALL 语句中使用的绑定数组的下标。这意味着如果我们在 FORALL i IN 1 .. n 中使用,那么 ERROR_INDEX 的值就是 1 到 n 之间的整数,代表原集合中的第几个元素导致了错误。这一点至关重要,因为它允许我们将错误信息与原始数据行关联起来。
例如,在上述第一个示例中,如果 v_ids(5) 导致了一个主键冲突,那么 SQL%BULK_EXCEPTIONS 中将会有一个条目,其 ERROR_INDEX 为 5。开发者可以使用这个索引值直接从 v_ids 或 v_names 集合中取出对应的原始数据进行详细分析或写入错误日志表。这种映射关系是线性的且直接的,不需要额外的查找操作。理解这一点对调试批量作业非常关键,因为它确保了错误追踪的准确性。




















