








在java中通过shardingsphere实现oracle分库分表,核心是配置数据源路由规则与分片算法。你需要引入shardingsphere-jdbc依赖,在spring boot配置文件中定义逻辑表、真实数据源以及具体的分片策略(如基于主键取模),启动应用后框架会自动拦截sql并根据配置将请求分发到对应的物理库表中。
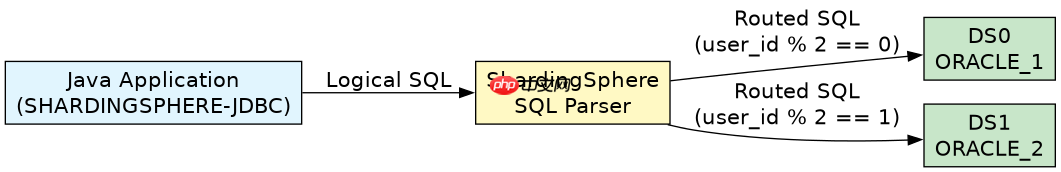
如何配置基础的分片规则
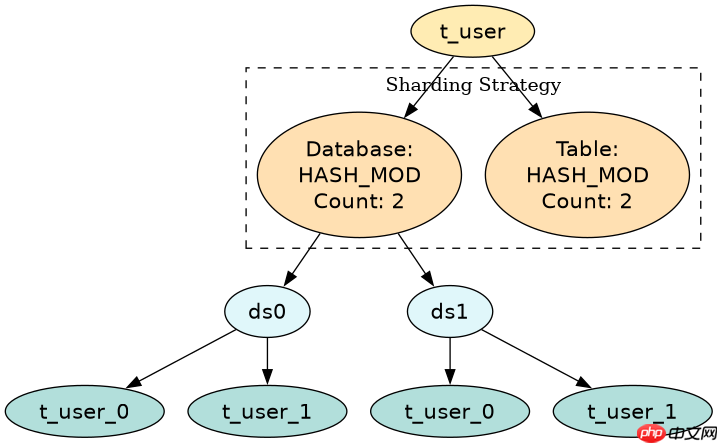
配置的基础在于声明逻辑表映射到哪些真实数据源,并指定分片键。以用户表为例,我们通常使用 user_id 作为分片键,采用哈希取模的方式将数据均匀分布到两个库中。这种配置方式能确保相同ID的数据始终落在同一节点,保证查询的一致性。
spring:
  shardingsphere:
    datasource:
      names: ds0,ds1
      ds0:
        type: com.zaxxer.hikari.HikariDataSource
        driver-class-name: oracle.jdbc.OracleDriver
        jdbc-url: jdbc:oracle:thin:@//localhost:1521/orcl1
        username: sharding
        password: secret
      ds1:
        type: com.zaxxer.hikari.HikariDataSource
        driver-class-name: oracle.jdbc.OracleDriver
        jdbc-url: jdbc:oracle:thin:@//localhost:1521/orcl2
        username: sharding
        password: secret
    rules:
      sharding:
        tables:
          t_user:
            actual-data-nodes: ds$->{0..1}.t_user_$->{0..1}
            database-strategy:
              standard:
                sharding-column: user_id
                sharding-algorithm-name: database-hash
            table-strategy:
              standard:
                sharding-column: user_id
                sharding-algorithm-name: table-hash
        sharding-algorithms:
          database-hash:
            type: HASH_MOD
            props:
              sharding-count: 2
          table-hash:
            type: HASH_MOD
            props:
              sharding-count: 2
上述配置定义了 t_user 这张逻辑表。当插入一条 user_id 为 10 的记录时,框架会计算 10 % 2 = 0,因此该记录会被路由到 ds0.t_user_0。若 user_id 为 11,则路由到 ds1.t_user_1。开发者只需操作逻辑表名,无需关心底层物理表的分布。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何处理跨库分页与排序问题
在分库分表场景下,简单的 ORDER BY 和 LIMIT 会导致性能灾难或结果错误,因为每个库只返回局部有序的结果。解决此问题的标准做法是在应用层进行“内存分页”或使用ShardingSphere提供的分布式排序功能,但后者开销较大。更常见的优化是避免深分页,或者利用业务时间戳进行范围查询而非全表排序。

// 模拟应用层处理跨库查询的逻辑
public List<User> queryUsersByPage(int page, int size) {
    // 1. 先查询所有库的总记录数(需走全库扫描,注意优化)
    long total = shardingTemplate.countAllUsers();

    // 2. 计算需要查询的物理库范围
    // 假设只有2个库,且数据分布均匀
    List<User> allResults = new ArrayList<>;
    for (int i = 0; i < 2; i++) {
        // 强制路由到特定数据源查询局部数据
        List<User> localData = shardingTemplate.queryFromSpecificDb(i, page, size);
        allResults.addAll(localData);
    }

    // 3. 在内存中进行全局排序和截取
    allResults.sort(Comparator.comparing(User::getCreateTime));
    int fromIndex = page * size;
    int toIndex = Math.min(fromIndex + size, allResults.size());
    return allResults.subList(fromIndex, toIndex);
}
代码展示了如何在Service层处理分页。由于Oracle不支持跨库联合排序,我们必须先从各个物理库拉取候选数据,然后在Java内存中合并排序。对于大数据量,建议限制最大页数或在业务设计上规避深度分页,例如使用游标分页(Cursor-based Pagination)代替传统的Offset分页。
当分片键不在查询条件中会发生什么
如果查询语句中没有包含分片键 user_id,例如执行 SELECT * FROM t_user WHERE email = 'test@example.com',ShardingSphere无法直接定位数据所在的物理节点。此时,框架会触发“广播查询”或“全库扫描”,即把SQL发送到所有配置的真实数据源上执行,然后合并结果。这种方式虽然能保证数据准确性,但性能极差,应尽量避免。




















