








java jdbc 处理连接池连接信息的核心做法是将数据库 url、用户名和密码等配置项从硬编码中剥离,统一交由连接池实现类(如 hikaricp、druid)管理。具体而言,开发者应通过配置文件或环境变量注入这些参数,并在初始化连接池时调用相应的 setter 方法或构造函数传入。这样做不仅实现了配置与代码的解耦,还能在运行时动态调整连接属性,确保应用的安全性和可维护性。

HikariCP 如何通过构造函数注入连接信息
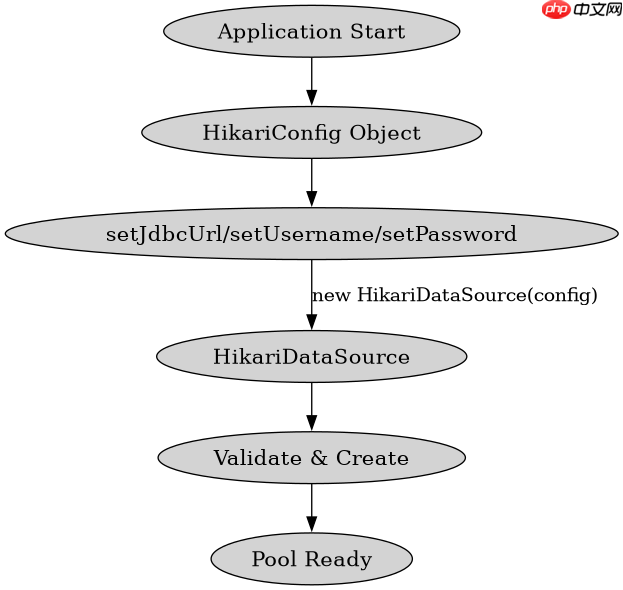
HikariCP 推荐使用构造器模式直接传入 DataSourceProperties 对象来初始化连接池,从而一次性绑定所有连接信息。这种方式比逐个设置属性更简洁且不易出错,适合在启动阶段明确知道数据库地址和凭证的场景。通过这种方式初始化的连接池会立即验证连接信息的合法性,并在首次获取连接时建立实际的网络会话。
import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;

public class PoolSetup {
    public static void main(String[] args) {
        // 创建配置对象并填入连接信息
        HikariConfig config = new HikariConfig();
        config.setJdbcUrl("jdbc:mysql://localhost:3306/mydb");
        config.setUsername("root");
        config.setPassword("secret");
        config.addDataSourceProperty("cachePrepStmts", "true");
        config.addDataSourceProperty("prepStmtCacheSize", "250");

        // 构建数据源
        HikariDataSource ds = new HikariDataSource(config);
        System.out.println("Pool initialized with URL: " + config.getJdbcUrl());
    }
}
上述代码展示了如何实例化 HikariConfig 并设置关键属性。运行该程序后,控制台将打印出配置的 JDBC URL,证明连接信息已成功注入到配置对象中。此时 HikariDataSource 已持有这些元数据,后续调用 getConnection() 时将直接使用这些信息建立连接。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
Druid 如何通过 Properties 对象加载连接信息
Alibaba Druid 连接池支持通过 java.util.Properties 对象批量加载连接信息,这种方式特别适合需要从配置文件(如 .properties 或 .yml)读取参数的场景。开发者只需将键值对放入 Properties 实例,再传递给 DruidDataSourceFactory.createDataSource() 即可。该方法会自动解析标准 JDBC 属性及 Druid 特有参数,完成连接池的预热和配置绑定。

import com.alibaba.druid.pool.DruidDataSourceFactory;
import javax.sql.DataSource;
import java.util.Properties;

public class DruidSetup {
    public static void main(String[] args) throws Exception {
        Properties props = new Properties();
        props.setProperty("driverClassName", "com.mysql.cj.jdbc.Driver");
        props.setProperty("url", "jdbc:mysql://localhost:3306/mydb");
        props.setProperty("username", "root");
        props.setProperty("password", "secret");
        props.setProperty("initialSize", "5");

        // 工厂方法创建数据源
        DataSource ds = DruidDataSourceFactory.createDataSource(props);
        System.out.println("Druid pool created with driver: " + props.getProperty("driverClassName"));
    }
}
运行此段代码,系统将加载指定的驱动类和连接字符串,并初始化 5 个初始连接。输出结果确认了驱动类名已被正确识别,表明连接信息已通过 Properties 对象成功传递至 Druid 内部。这种基于属性的方式允许在不修改 Java 代码的情况下,仅通过更改配置文件内容来切换不同的数据库环境。
当 JDBC URL 中包含特殊字符时连接池如何处理
当 JDBC URL 中包含如 &、# 或中文等非 ASCII 字符时,连接池通常依赖底层 JDBC 驱动进行解码,但前提是这些字符必须在配置文件中以正确的编码形式存在。若未进行 URL 编码,部分驱动可能会抛出 SQLException 或解析出错误的参数。因此,最佳实践是在写入连接信息前使用 URLEncoder.encode() 对特殊部分进行转义,或在配置文件中直接使用 Unicode 转义序列。
import java.net.URLEncoder;
import java.nio.charset.StandardCharsets;

public class UrlEncoding {
    public static void main(String[] args) throws Exception {
        String rawUrl = "jdbc:mysql://localhost:3306/my_db#test?useSSL=false";
        // 注意:通常只对参数值编码,URL 结构本身不编码
        // 这里演示对包含特殊字符的参数值进行编码
        String paramValue = "my_password&special";
        String encodedParam = URLEncoder.encode(paramValue, StandardCharsets.UTF_8);

        System.out.println("Encoded param: " + encodedParam);
        // 在实际连接池中,应将 encodedParam 作为 password 属性传入
    }
}
执行上述代码,控制台将输出经过 UTF-8 编码后的参数字符串。这证明了在处理含特殊字符的连接信息时,手动编码是确保连接池能正确解析的关键步骤。若直接将原始含 & 的密码传给连接池,多数情况下会导致认证失败或连接异常。



















