








starlette 集成数据库连接池的标准做法是在应用生命周期事件中初始化连接池,并通过依赖注入系统将其传递给路由处理函数。具体而言,需要在 lifespan 管理器中创建连接池实例,并在 startup 阶段启动它,在 shutdown 阶段关闭它以释放资源。随后,定义一个异步依赖项(dependency),该依赖项从应用状态或全局变量中获取连接池,并在每次请求时提供连接。这样做可以确保每个请求都能获得一个有效的数据库连接,且在请求结束后自动归还连接,从而避免连接泄漏并提高并发性能。
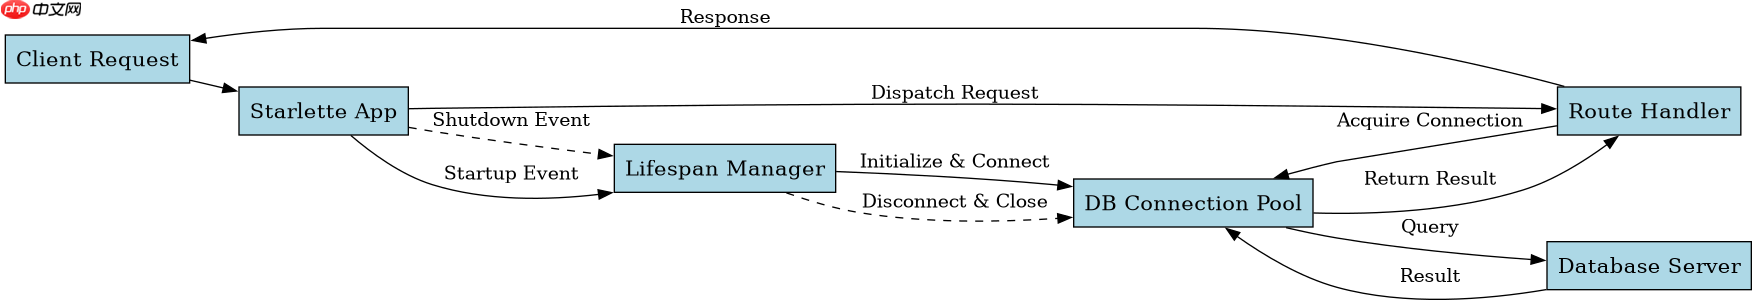
如何在 Starlette 的 lifespan 中管理连接池的生命周期
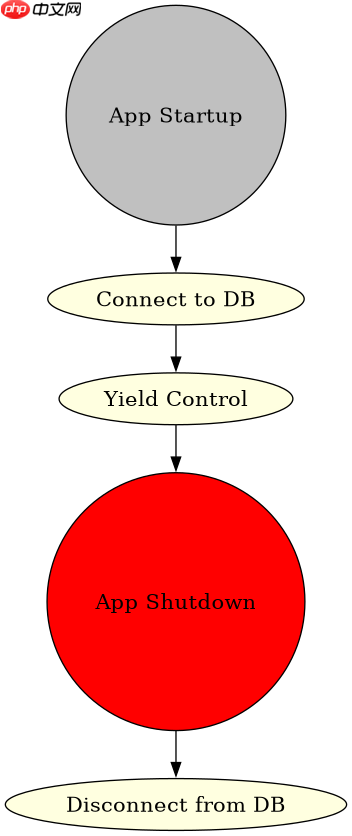
在 Starlette 中,数据库连接池的生命周期必须与应用的生命周期严格绑定。通过在 lifespan 事件处理器中管理连接池的初始化和销毁,可以确保在服务器启动时建立连接,在服务器关闭时安全地断开连接。这种机制利用了 Starlette 的上下文管理器特性,保证了资源的正确分配和回收。
import asyncio
from contextlib import asynccontextmanager
from starlette.applications import Starlette
from starlette.responses import JSONResponse
from databases import Database

# 假设使用 databases 库作为 ORM 抽象层
database = Database('postgresql://user:password@localhost/dbname')

async def lifespan(app):
    await database.connect()
    yield
    await database.disconnect()

app = Starlette(lifespan=lifespan)

@app.get('/health')
async def health_check(request):
    # 这里只是示例,实际查询需要依赖注入
    return JSONResponse({'status': 'ok'})
上述代码展示了基本的生命周期管理。在实际生产中,通常会结合具体的 ORM 或驱动(如 SQLAlchemy、asyncpg)来创建更复杂的连接池配置。例如,使用 SQLAlchemy 的 AsyncEngine 可以在 startup 时创建引擎,在 shutdown 时 dispose 引擎。关键点是确保所有异步操作都在正确的上下文中执行,并且连接池的大小和超时设置符合应用需求。
如何通过依赖注入将连接池传递给路由处理函数
为了实现解耦和可测试性,推荐使用 Starlette 的依赖注入系统。通过定义一个异步依赖项,可以在路由处理函数中直接获取数据库连接。这种方式使得路由逻辑专注于业务处理,而无需关心数据库连接的获取细节。同时,依赖注入允许在测试期间轻松替换为模拟数据库连接。
Starlette 1.5.1 是轻量级 Python ASGI 框架与工具集,提供路由、请求响应、中间件、WebSocket 和后台任务等组件,适合构建异步 Web 服务。本下载为官方 PyPI 通用 wheel 包,可使用 pip 安装,并由包管理器处理依赖;运行应用时还需配置 ASGI 服务器。

from starlette.dependencies import Depends
from starlette.requests import Request

async def get_db_connection(request: Request):
    # 从 app.state 中获取数据库实例
    db = request.app.state.database
    if not db.is_connected:
        await db.connect()
    return db

@app.get('/users')
async def get_users(db=Depends(get_db_connection)):
    query = 'SELECT * FROM users'
    users = await db.fetch_all(query)
return JSONResponse(users)在这个例子中,get_db_connection 是一个依赖项,它被注入到 get_users 路由中。每次请求到达时,Starlette 都会调用这个依赖项,并将返回的数据库连接对象作为参数传递给路由函数。如果数据库未连接,依赖项会负责连接它。这种方法确保了每个请求都有独立的连接上下文,避免了共享连接带来的竞争条件。
当数据库连接池满时如何处理并发请求
当并发请求数量超过连接池的最大容量时,新的请求将会被阻塞,直到有可用的连接。这种行为取决于所使用的数据库驱动和连接池实现。例如,如果使用 asyncpg,默认情况下,当连接池满时,新请求会等待直到有连接可用。这可能导致请求超时,如果等待时间过长。因此,合理设置连接池大小和超时时间是关键。此外,可以通过监控连接池的使用情况,动态调整池大小,以应对流量高峰。
# 示例:使用 SQLAlchemy 创建带有最大连接数的引擎
from sqlalchemy.ext.asyncio import create_async_engine

engine = create_async_engine(
    'postgresql+asyncpg://user:password@localhost/dbname',
    pool_size=10,      # 最大连接数
    max_overflow=5,    # 超出 pool_size 后允许的最大额外连接数
    pool_timeout=30    # 获取连接的超时时间(秒)
)在上述配置中,pool_size 定义了基础连接数,max_overflow 允许在高峰期临时增加连接,而 pool_timeout 则限制了等待连接的最长时间。如果请求在超时时间内无法获得连接,将会抛出异常。开发者需要根据应用的负载特性和数据库的性能瓶颈,仔细调整这些参数,以平衡资源利用率和响应速度。同时,建议在应用层面实现重试机制或熔断器,以优雅地处理连接不可用的情况。






















