








判断gc停顿是否过长,核心依据是监控日志中full gc或major gc事件的时间戳差值,并将其与业务允许的最大延迟阈值进行比对。具体做法是通过正则表达式提取日志中的`[full gc (allocation failure)... xxxms]`字段,解析出停顿时长,若该数值超过预设的sla标准(如200ms),即判定为停顿过长。此外,还需结合堆内存使用率的变化趋势,确认是否存在因内存泄漏导致的频繁长停顿。

如何从GC日志中提取停顿时间
直接回答:通过解析Java GC日志中的特定行,提取括号内标注的毫秒数即可得到停顿时间。主要关注包含`full gc`、`mark-sweep`或`concurrent mode failure`关键字的行,这些通常代表Stop-The-World(STW)事件。例如,在Parallel Scavenge + Parallel Old组合下,日志会明确显示`[Times: user=... sys=... real=...]`,其中real即为总停顿时间。对于G1收集器,则需查找`Pause Time`或`Total Time`字段。提取时需注意区分Young GC和Full GC,只有Full GC或混合收集阶段的停顿才通常被视为需要重点分析的“过长”停顿。
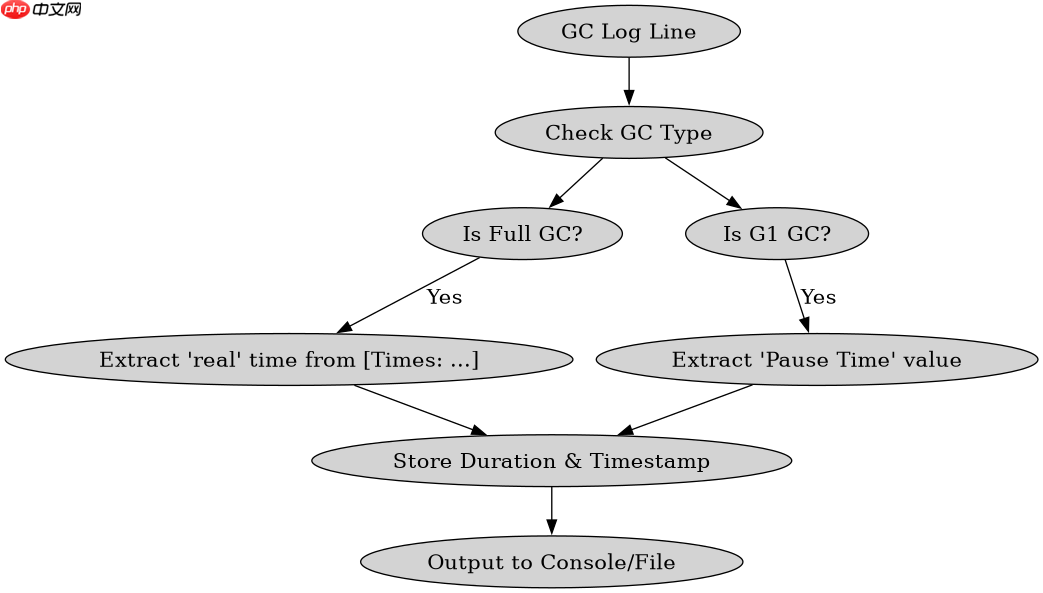
import java.io.BufferedReader; import java.io.FileReader; import java.io.IOException; import java.util.regex.Matcher; import java.util.regex.Pattern; public class GcLogAnalyzer { private static final Pattern FULL_GC_PATTERN = Pattern.compile("\[(full gc|mark-sweep)[^\]]*\]\s*(\d+)ms"); private static final Pattern G1_PAUSE_PATTERN = Pattern.compile("Pause Time:\s*(\d+)\.?(\d*) ms"); public static void analyze(String logPath, long thresholdMs) throws IOException { try (BufferedReader br = new BufferedReader(new FileReader(logPath))) { String line; while ((line = br.readLine()) != null) { if (line.contains("full gc") || line.contains("mark-sweep")) { Matcher m = FULL_GC_PATTERN.matcher(line); if (m.find()) { long duration = Long.parseLong(m.group(2)); if (duration > thresholdMs) { System.out.println("Long Full GC detected: " + duration + "ms at line: " + line.trim()); } } } else if (line.contains("G1")) { Matcher m = G1_PAUSE_PATTERN.matcher(line); if (m.find()) { double pauseTime = Double.parseDouble(m.group(1) + "." + m.group(2)); if (pauseTime > thresholdMs) { System.out.println("Long G1 Pause detected: " + pauseTime + "ms at line: " + line.trim()); } } } } } } public static void main(String[] args) { // 假设阈值为200ms analyze("gc.log", 200); } }预期结果:当gc.log中包含超过200ms的Full GC记录时,控制台将打印具体的停顿时间和对应的日志行。若所有停顿均低于阈值,则无输出。此代码仅做基础匹配,实际生产环境建议使用Elastic GC Logs等专用工具处理复杂格式。
立即学习“Java免费学习笔记(深入)”;

停顿过长的常见原因有哪些
直接回答:GC停顿过长通常由堆内存碎片化、大对象分配、元空间不足或并发线程阻塞引起。最常见的原因是老年代空间不足触发Full GC,且此时堆中存在大量存活对象,导致标记和清理阶段耗时增加。另一个原因是发生了Concurrent Mode Failure,即并发标记阶段未能完成,被迫转为串行Full GC。此外,如果应用中有长时间持有的锁或执行了重型I/O操作,也可能间接导致GC线程调度延迟,表现为停顿时间异常。分析时需结合堆转储文件(Heap Dump)查看对象分布,确认是否存在内存泄漏或大对象堆积。

// 模拟产生长停顿的场景 public class LongGcSimulator { public static void main(String[] args) { // 设置较小的堆大小以加速Full GC触发 // -Xmx64m -Xms64m -XX:+UseParallelOldGC List<byte[]> list = new ArrayList<>(); for (int i = 0; i < 100000; i++) { // 分配大对象,可能直接进入老年代 list.add(new byte[1024 * 100]); // 100KB } // 强制触发GC System.gc(); try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } } }预期结果:运行上述代码并启用GC日志(-XX:+PrintGCDetails),可观察到频繁的Full GC事件,且每次停顿时间显著高于Young GC。通过对比不同堆大小下的停顿时间,可验证内存压力对GC性能的影响。注意:System.gc()仅为测试手段,生产环境应避免显式调用。
基于程序中某个输入、条件或结果的具体问题
直接回答:当程序输入为大容量集合且存活率高时,Full GC停顿时间会急剧上升。具体而言,若向堆中注入大量短期存活对象后,再保留少量长期存活对象,GC器在清理短期对象后仍需遍历长期对象,导致标记阶段耗时增加。此时,即使堆总使用率不高,停顿时间也可能超标。解决方法包括调整堆大小、优化对象生命周期或使用CMS/G1等低停顿收集器。通过监控日志中的`Survivor Space`利用率,可进一步定位是否为晋升失败导致的停顿延长。



















