








java 中 hashset 和 treeset 的选择取决于是否需要保持元素顺序。如果不需要排序且追求最高插入和查询性能,选择 hashset;如果需要自动排序或范围查询(如获取最小/最大元素),选择 treeset。hashset 基于哈希表实现,平均时间复杂度为 o(1);treeset 基于红黑树实现,时间复杂度为 o(log n)。
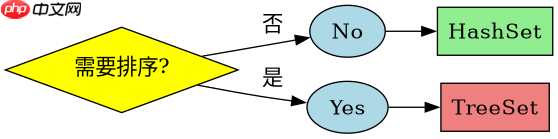
HashSet 的无序性与高性能表现
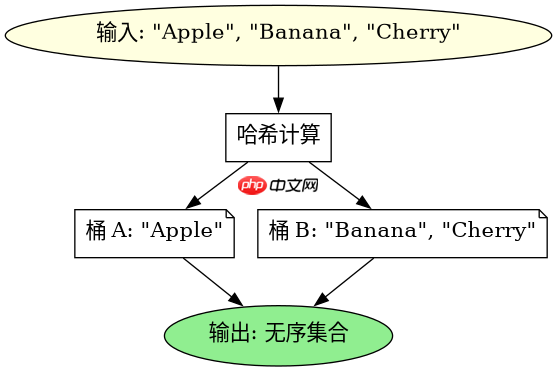
HashSet 不保证迭代顺序,其核心优势在于极快的增删改查速度。它通过哈希函数将元素映射到桶中,从而避免了对所有元素的遍历。对于大量数据的快速存取,它是首选方案。
import java.util.HashSet;
import java.util.Set;

public class HashSetDemo {
    public static void main(String[] args) {
        Set<String> set = new HashSet<>();
        set.add("Banana");
        set.add("Apple");
        set.add("Cherry");

        // 输出顺序可能与添加顺序不同
        System.out.println(set);
        System.out.println(set.contains("Apple")); // true
    }
}
运行上述代码,控制台输出的集合内容可能为 [Cherry, Banana, Apple] 或其他任意顺序,但包含检查始终返回 true。这验证了 HashSet 的无序性和高效查找特性。
立即学习“Java免费学习笔记(深入)”;

TreeSet 的有序性与导航功能
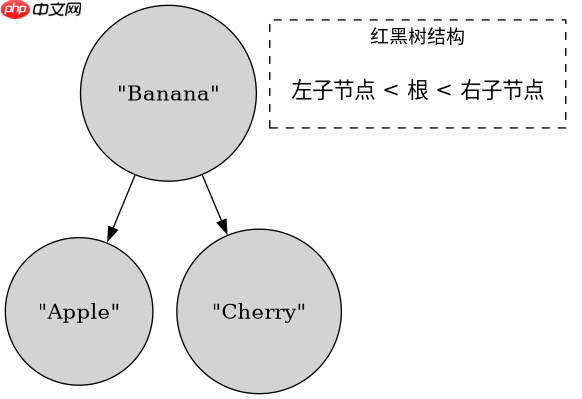
TreeSet 对元素进行自然排序(或按自定义 Comparator 排序)。它不仅支持 O(log n) 的增删查,还提供了丰富的导航方法,如 first()、last()、lower() 和 higher(),适用于需要范围操作或有序遍历的场景。
import java.util.TreeSet;
import java.util.Set;

public class TreeSetDemo {
    public static void main(String[] args) {
        Set<String> set = new TreeSet<>();
        set.add("Banana");
        set.add("Apple");
        set.add("Cherry");

        // 输出顺序为字母升序
        System.out.println(set); // [Apple, Banana, Cherry]
        System.out.println(set.first()); // Apple
        System.out.println(set.higher("Apple")); // Banana
    }
}
运行上述代码,控制台输出明确显示元素按字母顺序排列:[Apple, Banana, Cherry]。同时,first() 返回 "Apple",higher("Apple") 返回 "Banana",证明了 TreeSet 的排序能力和导航方法的可用性。
TreeSet 处理重复元素时的具体行为
当向 TreeSet 中添加已存在的元素时,它会依据比较结果判定为重复并拒绝添加,确保集合内元素唯一性。这与 HashSet 基于 equals() 判重略有不同,TreeSet 优先使用比较器或自然顺序。
import java.util.TreeSet;
import java.util.Set;

public class TreeSetDuplicateTest {
    public static void main(String[] args) {
        Set<Integer> set = new TreeSet<>();
        boolean added1 = set.add(10);
        boolean added2 = set.add(10);

        System.out.println("Added first 10: " + added1); // true
        System.out.println("Added second 10: " + added2); // false
        System.out.println("Set size: " + set.size()); // 1
    }
}
运行上述代码,第一次添加返回 true,第二次添加返回 false,集合大小仍为 1。这表明 TreeSet 严格遵循唯一性约束,重复元素被静默忽略,不会引发异常。



















