








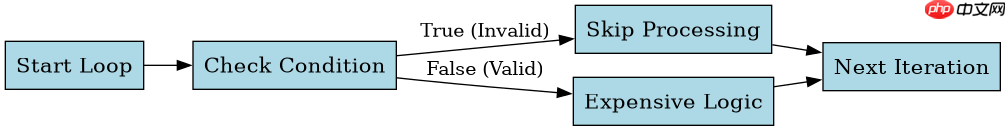
在 java 中,使用 continue 优化循环效率的核心做法是尽早过滤掉不符合条件的数据,从而减少后续不必要的计算和逻辑判断。当循环体中存在复杂的处理逻辑时,将前置条件检查放在循环开头并使用 continue 跳过当前迭代,可以避免进入深层嵌套或执行昂贵操作,使代码逻辑更清晰且运行更快。
如何识别适合 continue 优化的场景
适合使用 continue 的场景通常具备两个特征:一是存在明确的“无效”或“跳过”条件;二是满足该条件后,剩余的计算逻辑成本较高。例如在处理大量用户数据时,如果只需要处理活跃用户,那么非活跃用户的筛选就可以通过 continue 提前结束当前循环。
import java.util.ArrayList;
import java.util.List;

public class ContinueOptimization {
    public static void main(String[] args) {
        List<User> users = generateUsers();
        List<String> activeNames = new ArrayList<>();

        for (User user : users) {
            // 早期退出:如果不活跃,直接跳过后续复杂处理
            if (!user.isActive()) {
                continue;
            }

            // 假设这是昂贵的计算逻辑
            String processedData = expensiveProcessing(user);
            activeNames.add(processedData);
        }
        System.out.println("Active users count: " + activeNames.size());
    }

    private static String expensiveProcessing(User user) {
        try { Thread.sleep(10); } catch (InterruptedException e) {}
        return user.getName() + "_processed";
    }

    private static List<User> generateUsers() {
        List<User> list = new ArrayList<>();
        for (int i = 0; i < 100; i++) {
            list.add(new User("User_" + i, i % 2 == 0));
        }
        return list;
    }
}

class User {
    private String name;
    private boolean active;
    public User(String name, boolean active) { this.name = name; this.active = active; }
    public String getName() { return name; }
    public boolean isActive() { return active; }
}
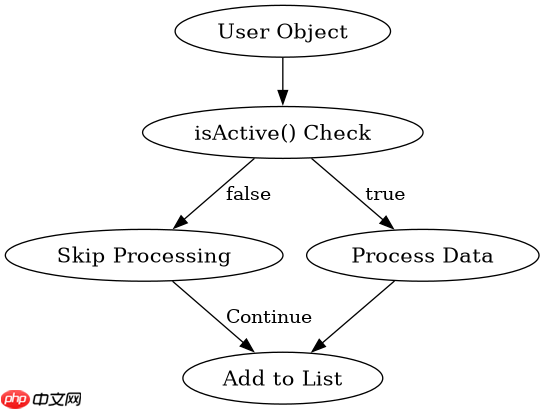
上述代码中,expensiveProcessing 模拟了耗时操作。通过 if (!user.isActive()) continue;,非活跃用户直接跳过该函数调用,显著提升了整体吞吐量。预期输出为 50 个活跃用户的处理结果。
立即学习“Java免费学习笔记(深入)”;

continue 与 break 及标签的使用差异
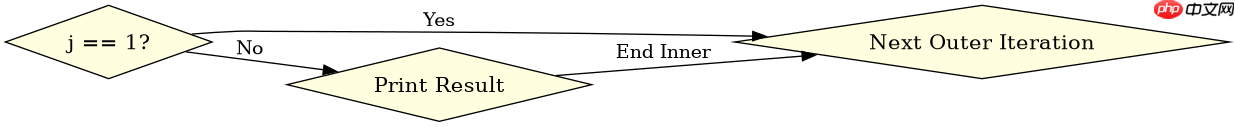
虽然 break 用于完全终止循环,但 continue 仅跳过当前迭代并继续下一次循环。在多层嵌套循环中,continue 默认只影响最内层循环。若需跳出外层循环的当前迭代,可使用标签(Label)语法。这种机制在处理矩阵或多维数据结构时非常有用,可以精确控制流程走向而不引入额外的标志位变量。
public class LabeledContinue {
    public static void main(String[] args) {
        outerLoop:
        for (int i = 0; i < 3; i++) {
            for (int j = 0; j < 3; j++) {
                if (j == 1) {
                    continue outerLoop; // 跳过外层当前迭代,直接进入下一轮 i
                }
                System.out.println("i=" + i + ", j=" + j);
            }
        }
    }
}
运行上述代码,当 j=1 时,程序不会打印 i=0, j=1 及其后的 j=2,而是直接跳到 i=1 的循环开始。这展示了 continue 结合标签对复杂流程控制的灵活性。预期输出仅包含 j=0 的行,因为每次 j=1 都会触发外层跳过。
基于输入数据分布对性能的具体影响
当输入数据中符合“跳过条件”的比例很高时,continue 带来的性能提升最为明显。如果绝大多数数据都需要处理,continue 的分支预测开销可能微乎其微,甚至不如直接执行逻辑快。因此,优化效果高度依赖于数据的分布情况。在实际开发中,应优先过滤掉那些占比大且处理成本高的无效数据。



















