








java 日志记录中实现日志采样,核心做法是借助 slf4j 提供的 mdc(mapped diagnostic context)或 threadlocal 机制,在请求入口处生成一个唯一的 traceid 并放入上下文,随后通过自定义的 logback appender 或 filter 拦截日志事件,利用该 id 结合随机数判断是否丢弃当前日志。这样做可以在高并发场景下显著降低 i/o 开销和存储压力,同时保留部分关键日志用于链路追踪和问题排查。

如何在代码中注入并传递 TraceId
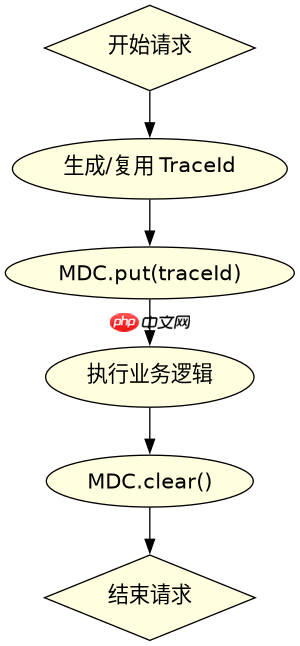
要在 Java 应用中实现采样,第一步是在请求处理的入口(如 Servlet Filter、Spring Interceptor 或 Dubbo Filter)生成一个全局唯一的标识符,通常称为 TraceId。这个 ID 需要被存入 MDC 中,因为大多数主流日志框架(如 Logback)默认支持从 MDC 读取变量并写入日志文件。MDC 基于 ThreadLocal 实现,能确保在同一线程内不同层级的代码都能访问到同一个 TraceId,从而实现跨模块的链路关联。
import org.slf4j.MDC;
import java.util.UUID;

public class TraceFilter {
    public void doFilter() {
        // 1. 生成唯一ID
        String traceId = UUID.randomUUID().toString().replace("-", "");
        // 2. 放入MDC
        MDC.put("traceId", traceId);
        try {
            // 执行业务逻辑
            processRequest();
        } finally {
            // 3. 清理资源,防止内存泄漏
            MDC.clear();
        }
    }
}
上述代码展示了最基础的注入方式。在实际生产环境中,如果上游已经传入了 TraceId(例如来自网关),应优先复用上游 ID 以保持链路连续性;若无上游 ID,则生成新的。关键点在于 finally 块中的 MDC.clear(),这能有效避免线程池复用导致的上下文污染。一旦 TraceId 进入 MDC,后续的日志调用如 logger.info("Processing...") 都会在输出中自动包含该 ID,前提是日志配置文件正确配置了 PatternLayout。
立即学习“Java免费学习笔记(深入)”;

如何配置 Logback 实现基于概率的采样过滤
仅仅有 TraceId 是不够的,采样逻辑必须发生在日志输出的环节。Logback 提供了 LevelFilter、ThresholdFilter 等内置过滤器,但原生并不直接支持“按百分比采样”。因此,我们需要编写一个自定义的 Filter 类来实现概率判断。这个过滤器会继承 ch.qos.logback.classic.filter.ThresholdFilter 或直接实现 Filter 接口,在 decide 方法中获取当前的日志级别和 MDC 中的 TraceId,然后生成一个随机数来决定是否接受该日志事件。

import ch.qos.logback.classic.filter.ThresholdFilter;
import org.slf4j.MDC;
import ch.qos.logback.classic.spi.ILoggingEvent;

public class SamplingFilter extends ThresholdFilter {
    private double samplingRate = 0.1; // 10% 采样率

    @Override
    public FilterReply decide(ILoggingEvent event) {
        // 1. 检查是否开启了采样开关
        if (!isStarted()) {
            return FilterReply.NEUTRAL;
        }

        // 2. 基础级别过滤(可选,比如只采样 ERROR 以上)
        FilterReply reply = super.decide(event);
        if (reply != FilterReply.NEUTRAL) {
            return reply;
        }

        // 3. 概率采样判断
        // 注意:实际生产中建议使用更安全的随机数生成器
        if (Math.random() < samplingRate) {
            return FilterReply.ACCEPT;
        } else {
            return FilterReply.DENY;
        }
    }
}
将上述 SamplingFilter 配置到 logback.xml 的 Appender 中即可生效。配置时需注意,采样过滤器应放在其他业务过滤器之后,或者根据需求调整顺序。例如,如果希望所有级别的日志都参与采样,只需将 samplingRate 设置为小于 1 的值。若希望仅对特定级别(如 DEBUG)进行采样,可以在 decide 方法中增加对 event.getLevel() 的判断。这种基于概率的采样虽然简单,但在高流量下能有效削峰。对于更复杂的场景,如基于用户 ID 的一致性哈希采样(确保同一用户的日志始终被记录或始终被丢弃),则需要修改随机算法,使用 TraceId 或 UserID 作为种子进行取模运算。
采样后如何保证关键错误日志不被误删
在使用概率采样时,最大的风险是可能丢失重要的调试信息或偶发的错误日志。为了解决这个问题,必须在采样逻辑中加入“白名单”或“强制保留”机制。具体做法是在自定义过滤器中,先检查日志事件的异常堆栈、日志内容或 MDC 中的特定标记,如果命中关键条件,则直接返回 ACCEPT,跳过概率判断。这样可以确保即使采样率为 1%,关键的 ERROR 级别日志或包含特定关键字(如 “Exception”、“Timeout”)的日志也能完整保留。
import ch.qos.logback.classic.Level;
import ch.qos.logback.classic.spi.ILoggingEvent;
import ch.qos.logback.core.filter.Filter;
import ch.qos.logback.core.spi.FilterReply;

public class CriticalLogPreserveFilter extends Filter<ILoggingEvent> {
    @Override
    public FilterReply decide(ILoggingEvent event) {
        // 1. 强制保留 ERROR 及以上级别
        if (event.getLevel().isGreaterOrEqual(Level.ERROR)) {
            return FilterReply.ACCEPT;
        }

        // 2. 强制保留包含特定关键字的日志
        String message = event.getMessage();
        if (message.contains("OutOfMemory") || message.contains("Deadlock")) {
            return FilterReply.ACCEPT;
        }

        // 3. 其他日志交由后续采样过滤器处理
        return FilterReply.NEUTRAL;
    }
}
在 logback.xml 配置中,应将 CriticalLogPreserveFilter 放置在 SamplingFilter 之前。这样,日志事件会先经过关键性检查,只有通过检查的非关键日志才会进入采样环节。这种分层过滤策略既保证了系统的稳定性(不丢关键日志),又实现了性能优化(丢弃大量无用 DEBUG/INFO 日志)。此外,还可以结合 MDC 中的动态开关,允许运维人员在运行时通过 JMX 或配置中心调整采样率,而无需重启应用,进一步提升运维灵活性。



















