








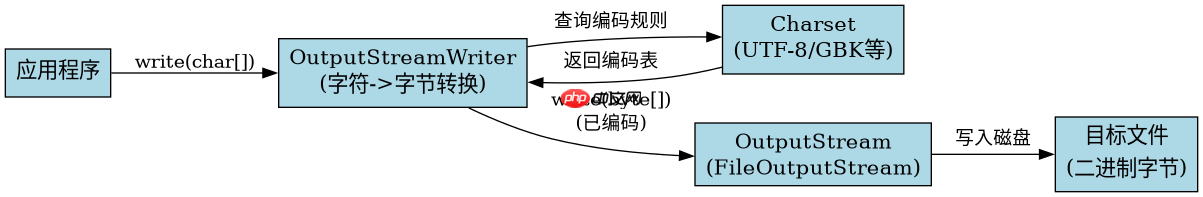
在java中,`outputstreamwriter` 是连接字节流与字符流的桥梁,它作为字符流通向字节流的桥梁,使用指定的字符集将写入其中的字符编码为字节。要使用它,只需传入一个 `outputstream`(如 `fileoutputstream`)和具体的 `charset`(如 `standardcharsets.utf_8`),然后调用其 `write()` 方法即可将字符串或字符数组转换为指定编码的字节输出到目标流中。
如何创建并配置 OutputStreamWriter 实例
创建 `OutputStreamWriter` 的核心在于选择合适的底层字节流和目标字符集。通常我们使用 `FileOutputStream` 作为底层流来操作文件,并通过构造函数指定编码格式,例如 UTF-8。这样,后续写入的任何字符都会自动根据该字符集进行转换。如果省略字符集参数,则使用平台默认编码,这在跨平台环境中可能导致乱码,因此显式指定字符集是最佳实践。
import java.io.FileOutputStream;
import java.io.OutputStreamWriter;
import java.nio.charset.StandardCharsets;

public class Main {
    public static void main(String[] args) throws Exception {
        // 1. 创建底层字节流
        FileOutputStream fos = new FileOutputStream("output.txt");

        // 2. 创建 OutputStreamWriter,指定 UTF-8 编码
        OutputStreamWriter osw = new OutputStreamWriter(fos, StandardCharsets.UTF_8);

        // 3. 写入字符数据
        osw.write("Hello, World!");

        // 4. 关闭资源(会自动刷新并关闭底层流)
        osw.close();
    }
}
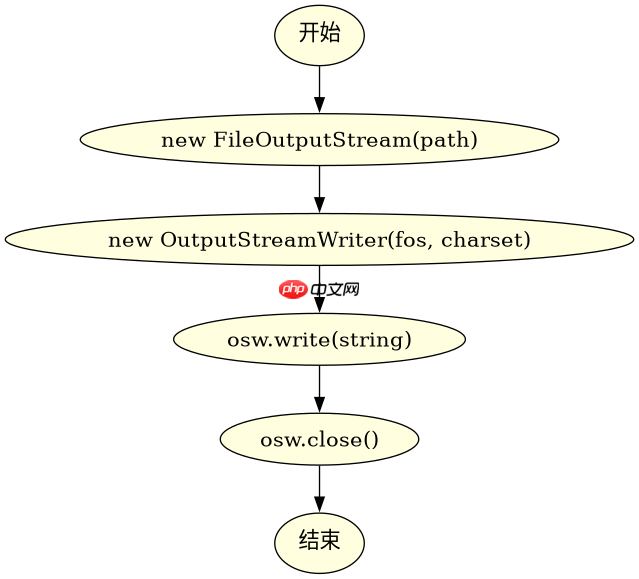
上述代码首先建立了文件输出流,接着将其包装进 `OutputStreamWriter` 并指定了 UTF-8 编码。当调用 `write` 方法时,字符 "Hello, World!" 会被转换为对应的 UTF-8 字节序列写入文件。最后通过 `close()` 确保所有缓冲数据被写出并释放系统资源。
立即学习“Java免费学习笔记(深入)”;

如何处理缓冲区刷新与异常
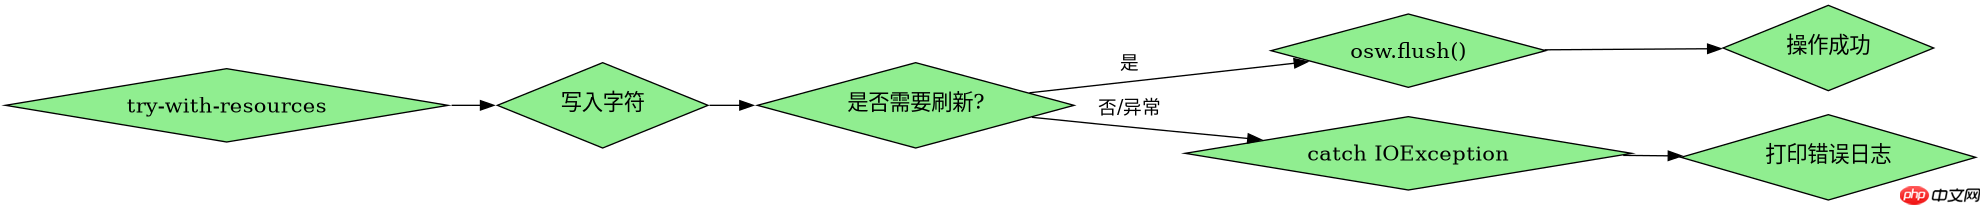
`OutputStreamWriter` 内部维护了一个字符缓冲区,为了提高效率,它不会每次写入都立即转化为字节输出到底层流,而是积累一定量后才进行转换和输出。因此,在写入大量数据或需要实时看到输出效果时,必须手动调用 `flush()` 方法。此外,由于涉及 I/O 操作,该方法会抛出 `IOException`,必须在代码中进行处理。如果不刷新缓冲区就关闭流,可能会导致部分数据丢失。
import java.io.FileOutputStream;
import java.io.OutputStreamWriter;
import java.io.IOException;
import java.nio.charset.StandardCharsets;

public class Main {
    public static void main(String[] args) {
        try (FileOutputStream fos = new FileOutputStream("data.bin");
             OutputStreamWriter osw = new OutputStreamWriter(fos, StandardCharsets.UTF_8)) {

            String data = "测试数据";
            osw.write(data);

            // 强制将缓冲区内容转换为字节并写入底层流
            osw.flush();

            System.out.println("数据已成功写入并刷新");

        } catch (IOException e) {
            System.err.println("写入失败: " + e.getMessage());
        }
    }
}
在这个示例中,使用了 try-with-resources 语句来自动管理资源,避免了显式调用 `close()` 可能遗漏的风险。在写入字符串后,显式调用了 `flush()`,确保字符 "测试数据" 已经被转换为字节并写入 `data.bin` 文件中。如果发生 `IOException`,程序会捕获异常并打印错误信息,保证程序的健壮性。
基于写入中文乱码问题的具体排查
如果在读取生成的文件时发现中文出现乱码,通常是因为 `OutputStreamWriter` 使用的字符集与文件实际保存的字符集不一致。例如,若代码中使用 `StandardCharsets.UTF_8` 写入,但用记事本以 ANSI 编码打开,或者反之,就会出现乱码。解决此问题的关键是确保写入时的编码与读取时的解码完全匹配。可以通过检查 `getEncoding()` 方法确认当前 Writer 使用的编码,并在编辑器中统一设置编码格式。



















