








volatile 通过内存屏障禁止指令重排序并保证可见性,其性能开销主要源于 mesi 协议下的缓存一致性同步。在 java 中,对 volatile 变量的写操作会触发 cpu 将当前缓存行标记为 modified 并失效其他核心副本,读操作则需从主存或拥有最新数据的缓存行加载数据,这种跨核心的缓存行搬运和状态转换是性能损耗的根本原因。

写操作如何触发 MESI 协议中的总线风暴
当线程 A 修改 volatile 变量时,CPU 必须确保其他核心看到的都是新值。这导致持有该缓存行副本的其他核心(如 Core B)必须将其状态从 Shared 或 Exclusive 降级为 Invalid。如果多个核心频繁竞争同一个 volatile 变量,就会引发大量的缓存行无效化和重新加载,即所谓的“伪共享”或总线风暴现象,显著降低吞吐量。
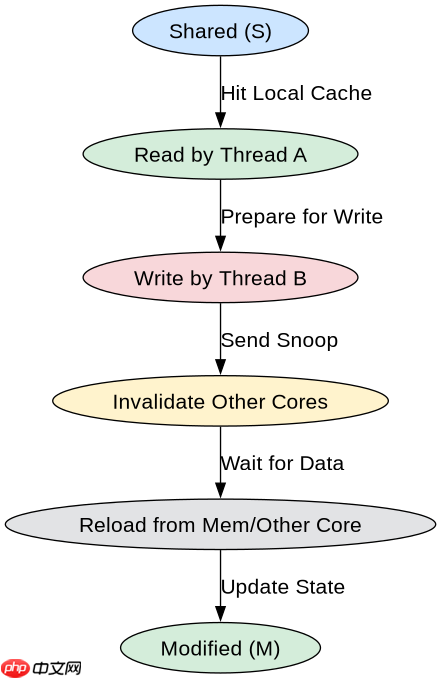
读操作在不同核心间的延迟差异分析
读取 volatile 变量时,如果本地缓存命中且未被其他核心失效,速度极快;但若其他核心刚写入过该变量,本地缓存行已失效,CPU 必须等待该缓存行从拥有 Modified 状态的另一个核心或主存中传输过来。这种跨核心的数据传输延迟远高于本地 L1 缓存访问,因此在高并发场景下,频繁的读写交替会导致严重的停顿。

立即学习“Java免费学习笔记(深入)”;

基于单变量高频更新的具体性能瓶颈
以单个 volatile int counter 为例,当两个线程分别进行自增(实际是读-改-写)和直接赋值时,每次写操作都会使对方的缓存行失效。若线程 A 和线程 B 轮流写,缓存行会在 M、S、I 状态间剧烈震荡,导致 CPU 流水线因等待内存数据而停滞。这种基于具体输入(双线程竞争同一地址)的结果显示,即使没有锁,volatile 的可见性保证也带来了不可忽视的硬件级延迟。




















