








使用正则表达式 preg_match_all 配合 unicode 属性 \p{han} 和 [0-9] 可以准确提取字符串中的中文和数字。具体做法是将匹配模式设为 '/(\p{han}|[0-9])+/u',传入目标字符串并获取结果数组,该函数会返回所有连续的中文字符串段和数字段。
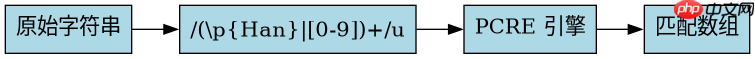
preg_match_all 如何区分中文与数字块?
该函数通过正则引擎的交替逻辑将连续的中文归为一组,连续的数字归为另一组。输入包含混合字符的字符串时,它会跳过标点符号和其他非中非数内容,仅保留符合模式的片段。例如输入 '你好123世界456',结果数组的第一项是 ['你好', '123', '世界', '456'],第二项是各片段的起始位置索引。
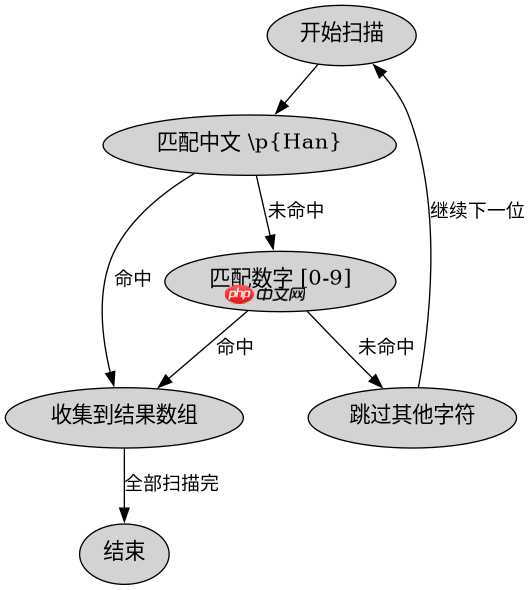
$str = '你好123世界456';
$pattern = '/(\p{Han}|[0-9])+/u';
preg_match_all($pattern, $str, $matches);
print_r($matches[0]); // 输出: Array ( [0] => 你好 [1] => 123 [2] => 世界 [3] => 456 )
遇到空字符串或纯英文时会发生什么?
当输入为空字符串或完全不包含中文及数字时,preg_match_all 不会报错,而是返回 0 次匹配。此时 $matches 数组的结构依然保持完整,但 $matches[0] 是一个空数组。这种设计允许代码直接检查 count($matches[0]) 来判断是否提取到了有效内容,无需额外处理异常。

Build MCP servers and clients for PHP applications with the official PHP SDK
下载
使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
立即学习“PHP免费学习笔记(深入)”;
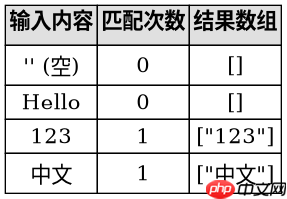
$str = 'Hello World';
$pattern = '/(\p{Han}|[0-9])+/u';
$result = preg_match_all($pattern, $str, $matches);
var_dump($result); // int(0)
var_dump($matches); // array(0) { }
基于输入 '测试#123!' 的具体提取结果是什么?
对于包含特殊符号的混合输入,正则表达式会忽略 # 和 !,仅提取相邻的有效字符块。输入 '测试#123!' 时,程序会将 '测试' 和 '123' 分别作为两个独立的匹配项返回,中间被符号隔开的部分不会合并。这确保了提取结果的粒度始终保持在语义完整的词或数值单元上。
















