








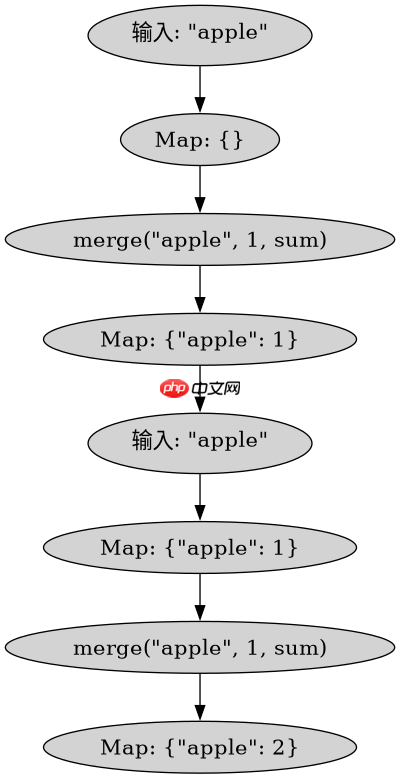
使用 hashmap.merge() 统计词频的核心在于利用其提供的合并函数,自动处理键不存在和已存在两种情况。只需传入键、初始值(通常为1)以及一个将旧值与新值相加的 lambda 表达式,即可在单次调用中完成计数更新。

merge() 方法如何处理键冲突
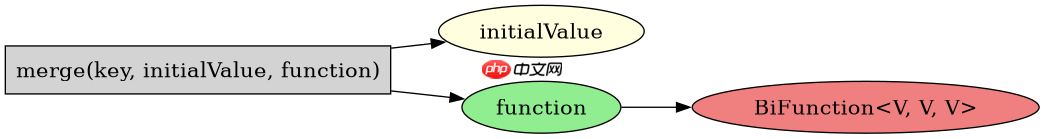
merge() 通过检查键是否已存在于 Map 中来决定执行逻辑。如果键不存在,它直接放入指定的初始值;如果键已存在,它调用提供的 BiFunction 将旧值与初始值合并。这种机制避免了手动编写 containsKey 判断或 getOrDefault 的逻辑分支。
import java.util.HashMap;
import java.util.Map;

public class WordFrequency {
    public static void main(String[] args) {
        Map<String, Integer> wordCounts = new HashMap<>();
        String[] words = {"apple", "banana", "apple", "orange", "banana", "apple"};

        for (String word : words) {
            // 核心逻辑:若key不存在则put(1),若存在则oldValue + 1
            wordCounts.merge(word, 1, Integer::sum);
        }

        System.out.println(wordCounts);
    }
}运行上述代码,控制台输出结果为:{orange=1, banana=2, apple=3}。可以看到,apple 出现了三次,值为3;banana 出现了两次,值为2;orange 出现一次,值为1。这验证了 Integer::sum 正确地将每次遇到的单词计数累加。
立即学习“Java免费学习笔记(深入)”;

自定义合并逻辑的应用场景
虽然统计词频通常使用加法,但 merge() 的强大之处在于可以传入任意合并逻辑。例如,如果需要记录每个单词最后出现的索引位置,可以使用 (oldVal, newVal) -> newVal 来覆盖旧值,或者使用更复杂的逻辑来处理列表追加等场景。
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

public class ListAggregator {
    public static void main(String[] args) {
        Map<String, List<String>> categoryMap = new HashMap<>();
        String[] items = {"fruit", "vegetable", "fruit", "dairy"};

        for (String item : items) {
            // 如果key不存在,初始化一个空列表并添加当前item
            // 如果key存在,获取现有列表并添加当前item
            categoryMap.merge(item, new ArrayList<>(), (existingList, newList) -> {
                existingList.add(newList.get(0)); // 这里简化演示,实际应处理newList内容
                return existingList;
            });
        }
        // 注意:上面的Lambda写法在实际中需确保newList包含待添加元素,
        // 更常见的做法是merge时传入单元素列表或使用computeIfAbsent配合add
    }
}
为了更清晰地展示自定义逻辑,我们修正上述示例为更标准的“列表聚合”模式,即每次 merge 时传入一个包含新元素的列表,并将它们合并到现有列表中:
import java.util.Arrays;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

public class ListAggregatorFixed {
    public static void main(String[] args) {
        Map<String, List<String>> categoryMap = new HashMap<>();
        String[] items = {"fruit", "vegetable", "fruit", "dairy"};

        for (String item : items) {
            // 每次传入包含当前item的单元素列表
            // 合并逻辑:将新列表的元素添加到旧列表中
            categoryMap.merge(item, Arrays.asList(item), (existingList, newList) -> {
                existingList.addAll(newList);
                return existingList;
            });
        }

        System.out.println(categoryMap);
    }
}运行修正后的代码,输出结果为:{fruit=[fruit, fruit], vegetable=[vegetable], dairy=[dairy]}。这表明 merge() 成功地将相同类别的项目聚合到了同一个列表中。此例展示了当初始值和合并逻辑不单纯是数值运算时,merge() 依然能保持代码的简洁性。
merge() 在并发环境下的局限性
尽管 merge() 在单线程环境下非常便捷,但它并非原子操作。在多线程环境中,多个线程同时调用 merge() 可能导致数据竞争。例如,两个线程同时读取某个键的值,然后各自计算新值并写入,其中一个写入可能会覆盖另一个的结果。因此,在需要高并发计数的场景下,应使用 ConcurrentHashMap 的 merge() 方法,它提供了原子性的保证。


















