








在java中使用lambda表达式配合`files.walkfiletree`,核心是将传统的匿名内部类替换为函数式接口。具体做法是传入一个实现了`filevisitor
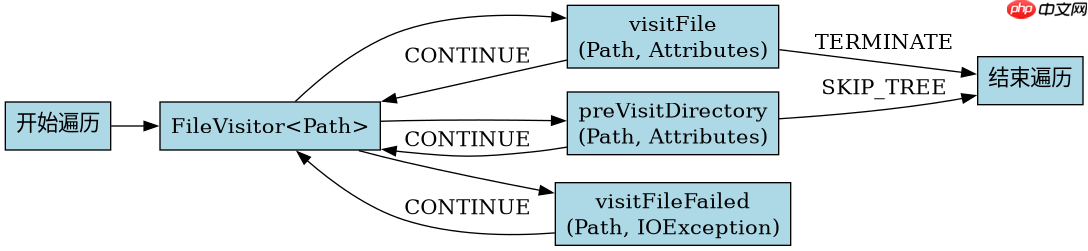
如何构建基础的FileVisitor Lambda
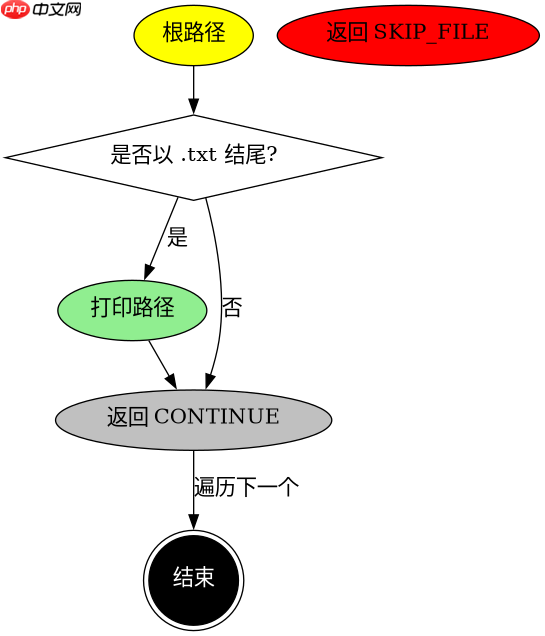
要构建基础的访问者,最直接的方法是继承`java.nio.file.SimpleFileVisitor`。虽然不能直接对接口进行单方法Lambda转换(因为`FileVisitor`有四个方法),但可以针对特定行为编写简短的Lambda或局部类。例如,仅查找特定扩展名的文件,只需重写`visitFile`方法。输入是一个根路径,目标是列出所有`.txt`文件。结果是在控制台打印这些文件的路径。关键在于捕获外部变量或使用线程安全的集合来收集结果。
import java.io.IOException;
import java.nio.file.*;
import java.util.stream.Stream;

public class Main {
    public static void main(String[] args) throws IOException {
        Path start = Paths.get(".");
        // 使用 SimpleFileVisitor 作为基础,重写 visitFile
        Files.walkFileTree(start, new SimpleFileVisitor<Path>() {
            @Override
            public FileVisitResult visitFile(Path file, BasicFileAttributes attrs) throws IOException {
                if (file.toString().endsWith(".txt")) {
                    System.out.println("Found: " + file);
                }
                return FileVisitResult.CONTINUE;
            }
        });
    }
}
如何处理异常与跳过目录
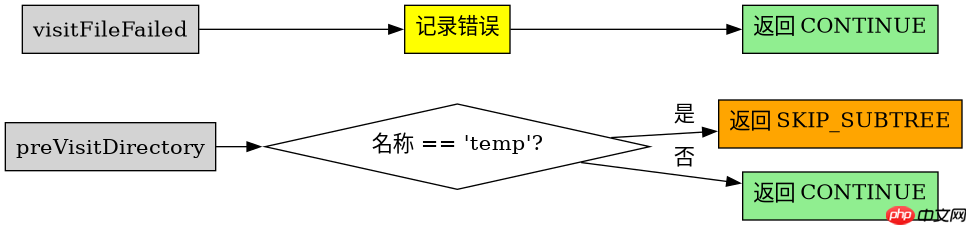
在实际开发中,经常遇到权限不足或符号链接循环的问题。此时需要在`visitFileFailed`方法中处理异常,并在`preVisitDirectory`中决定是否继续深入。输入包含受保护目录和正常目录,目标是忽略错误并继续遍历其他部分。结果是程序不会因单个文件报错而中断。通过返回`FileVisitResult.CONTINUE`而非`TERMINATE`,可以确保遍历完成。这种处理方式比传统异常抛出更优雅,符合函数式编程的错误处理习惯。

立即学习“Java免费学习笔记(深入)”;
import java.io.IOException;
import java.nio.file.*;
import java.nio.file.attribute.BasicFileAttributes;

public class RobustWalker {
    public static void main(String[] args) throws IOException {
        Path start = Paths.get("/some/path");
        Files.walkFileTree(start, new SimpleFileVisitor<Path>() {
            @Override
            public FileVisitResult preVisitDirectory(Path dir, BasicFileAttributes attrs) throws IOException {
                // 示例:跳过名为 'temp' 的目录
                if (dir.getFileName().toString().equals("temp")) {
                    System.out.println("Skipping: " + dir);
                    return FileVisitResult.SKIP_SUBTREE;
                }
                return FileVisitResult.CONTINUE;
            }

            @Override
            public FileVisitResult visitFileFailed(Path file, IOException exc) throws IOException {
                // 记录错误但不终止
                System.err.println("Error accessing: " + file + ", reason: " + exc.getMessage());
                return FileVisitResult.CONTINUE;
            }
        });
    }
}
结合Stream API进行并行处理
当需要处理大量文件且逻辑简单时,可以将`Files.walk`与Lambda结合,但这不同于`walkFileTree`的深度优先控制。如果必须使用`walkFileTree`的结构但希望更函数化,可以考虑将结果收集到列表中再处理。输入是大目录树,目标是统计文件大小。结果是一个总和。虽然`walkFileTree`本身不直接返回Stream,但可以手动累积数据。这种方式适合需要精细控制访问顺序的场景,而`Files.list`或`Files.walk`更适合简单的流式处理。注意内存占用,避免一次性加载所有路径。

















