








python 3 的 statistics.mean() 计算算术平均值,median() 计算中位数;两者遇到空数据都会抛 statisticserror。先明确数据范围,再处理空值和非有限浮点数,不能为了让计算成功而悄悄删除无效记录。下面示例分别验证平均值、奇偶样本的中位数及输入错误。
用 mean 计算平均值,并确认没有修改原数据
下面是可单独执行的示例。mean 接受可迭代数值,返回结果的具体类型与输入有关,不应假定整数平均值总是 float。浮点结果如需比较,可按业务容差使用 math.isclose。
from statistics import mean
import math

data = [2, 4, 9]
assert mean(data) == 5
assert data == [2, 4, 9]
assert math.isclose(mean([1.0, 2.0, 2.0]), 5 / 3)
print("平均值:", mean(data))
平均值容易受极端值影响。例如一组大多数数值较小、个别数值很大的数据,均值可能远离多数样本。是否需要用中位数描述典型水平,取决于数据含义,不能只比较两个函数谁更“准确”。
用 median 分别处理奇数和偶数个样本
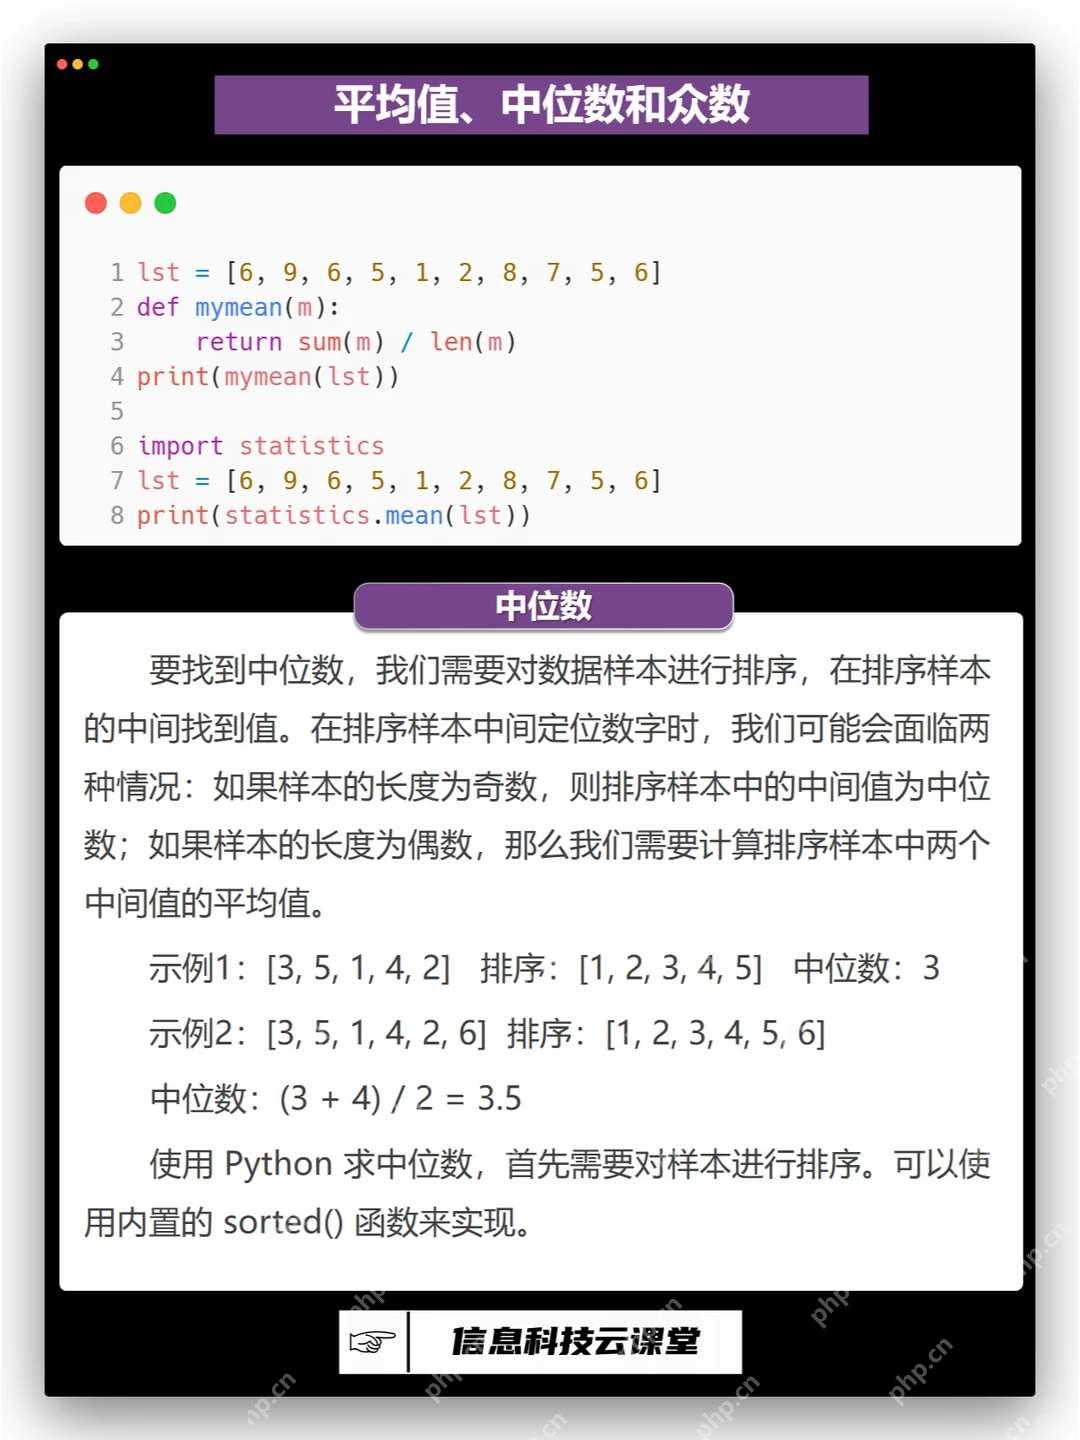
median 内部会按数值顺序定位中间位置,不要求调用前已经排序,也不会原地重排传入列表。奇数个样本返回中间值,偶数个样本返回中间两个数的平均值。
立即学习“Python免费学习笔记(深入)”;

from statistics import median

odd = [3, 5, 1, 4, 2]
even = [3, 5, 1, 4, 2, 6]
assert median(odd) == 3
assert median(even) == 3.5
assert odd == [3, 5, 1, 4, 2]
assert even == [3, 5, 1, 4, 2, 6]
print("奇数中位数:", median(odd))
print("偶数中位数:", median(even))
median 与平均值回答的是不同问题。若输入含 NaN 等特殊值,应先制定明确的拒绝或清洗规则,不要把含特殊值的排序结果直接当成正常统计结果。
拒绝空数据和无效值,避免静默改变样本
此业务函数仅接受非空的有限 int、float 数据,不接受 bool。它会先验证,再同时计算两种统计量;错误不会被悄悄过滤。原生 statistics 对混合类型的错误不一定都是 StatisticsError,因此不要把所有输入错误归成空数据。
from statistics import mean, median, StatisticsError
import math

def summarize(values):
    data = list(values)
    if not data:
        raise StatisticsError("没有可统计的数据")
    for value in data:
        if type(value) not in (int, float):
            raise TypeError("本例仅接受 int 和 float")
        if isinstance(value, float) and not math.isfinite(value):
            raise ValueError("不接受 NaN 或无穷值")
    return {"mean": mean(data), "median": median(data)}

assert summarize([1, 2, 9]) == {"mean": 4, "median": 2}
for data, expected in [([], StatisticsError), ([1, True], TypeError), ([1, float("nan")], ValueError)]:
    try:
        summarize(data)
    except expected:
        print("预期错误已识别:", expected.__name__)
    else:
        raise AssertionError("该输入应被拒绝")
若数据缺失在业务上允许,应先单独记录被排除项和原因,再计算并报告实际样本数。这里采取严格拒绝策略,避免“返回一个数字”掩盖原始数据问题。


















