








python 3 的 textwrap.wrap(text, width=n) 返回换行后的字符串列表,fill() 返回用换行符连接的文本。width 按字符计数,不能代表终端里的中文显示列宽。默认会拆开超长单词;要保留完整单词,可关闭 break_long_words,但这时某些行可能超过指定宽度。
用 wrap 将连续文本拆成指定宽度的多行
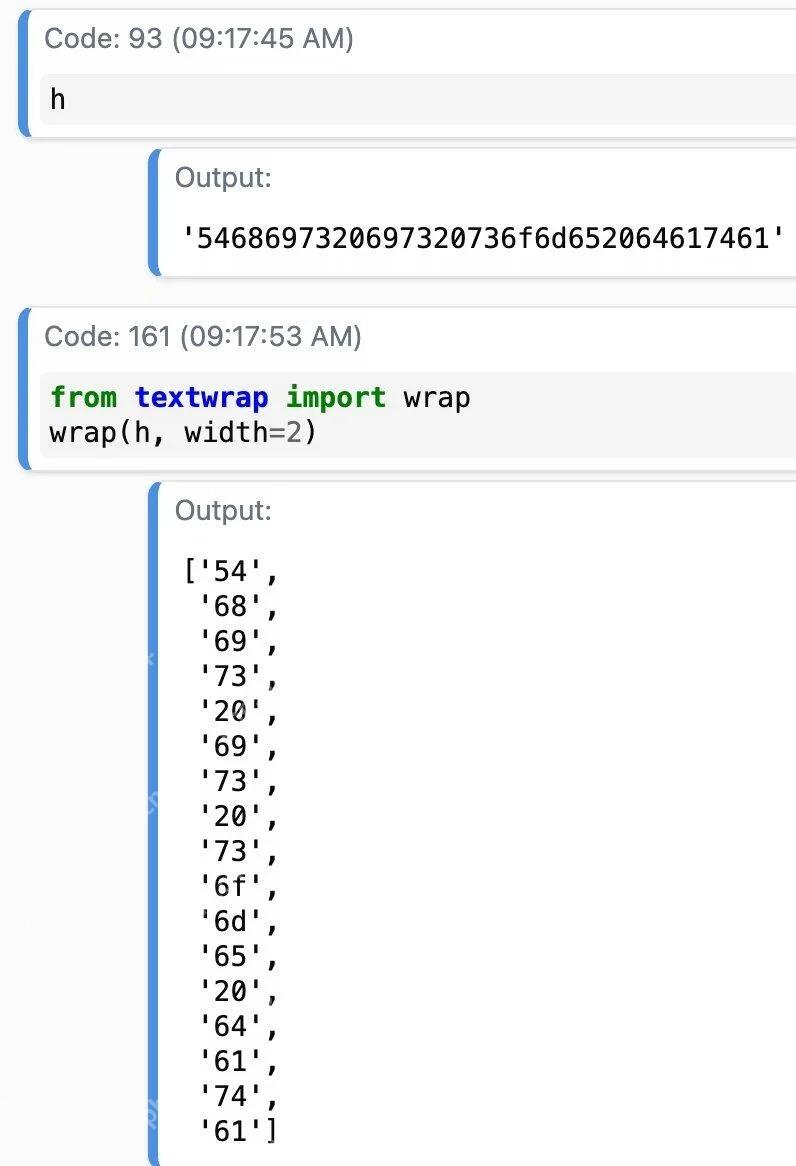
以下示例可直接执行。连续字符没有词间空格时,默认按宽度拆分;英文句子则优先在空白等合适位置换行。wrap 针对单个段落处理,默认会把原有换行等空白规范化,不保留多段文本的空行结构。
from textwrap import wrap

assert wrap("1234567890", width=2) == ["12", "34", "56", "78", "90"]
assert wrap("alpha beta gamma", width=10) == ["alpha beta", "gamma"]
assert wrap("", width=10) == []
assert wrap("你好世界", width=2) == ["你好", "世界"]
print(wrap("1234567890", width=2))
中文示例中的 width=2 表示每行两个字符,不是两个显示单元。全角字符、组合字符和表情的视觉占用与 len() 不总一致,不能据此承诺终端列对齐。需要逐段保留空行时,应先分段,再分别调用 wrap 或 fill。
立即学习“Python免费学习笔记(深入)”;

用 fill 加入换行符,并计算前缀占用的宽度
fill 相当于对 wrap 的结果用换行符连接。initial_indent 添加在首行,subsequent_indent 添加在后续行,二者都会占用 width 的长度预算。列表项目、日志说明等需要不同首行前缀时,可以采用这个方式。
from textwrap import fill, wrap

options = dict(width=12, initial_indent="> ", subsequent_indent="  ")
text = "alpha beta gamma delta"
result = fill(text, **options)
assert result == "> alpha beta\n  gamma\n  delta"
assert result == "\n".join(wrap(text, **options))
assert all(len(line) <= 12 for line in result.splitlines())
print(result)
前缀不是先把正文按完整宽度换行、再额外追加,而是先预留空间。选择前缀时应确保它比目标宽度短;如果不希望原段落换行被折叠,应在调用前明确段落边界。
保留超长单词时接受行宽超限
默认 break_long_words=True,break_on_hyphens=True。两个选项一起关闭,可以避免在长单词内部及连字符处拆分,但一整词超过 width 时会单独占一行并超宽。应在“硬性限制长度”与“保持单词完整”之间明确选择。
from textwrap import wrap

word = "abcdefghijk"
assert wrap(word, width=5) == ["abcde", "fghij", "k"]
kept = wrap(word, width=5, break_long_words=False, break_on_hyphens=False)
assert kept == [word]
assert len(kept[0]) > 5
print(kept)
try:
    wrap("text", width=0)
except ValueError:
    print("非正宽度已拒绝")
else:
    raise AssertionError("width=0 应失败")
换行后如果要截断而不是继续产生新行,应单独定义截断规则,不能把 wrap 当成字符串长度验证器。对代码、URL 或文件路径拆行时,也要考虑拆开的内容是否仍便于复制。
















