








python 3 的 urllib.parse.urlencode() 可把字典编码成查询字符串;列表参数需要 doseq=true 才会展开为重复的键。解析时用 urlsplit() 取得 query,再交给 parse_qs(),它会完成百分号解码并把每个键的值放进列表。只编码查询参数,不要把整条 url 再编码一次。
把中文参数编码进 URL,并保留原有片段
以下示例没有发送网络请求。urlunsplit() 会按组件重组 URL,避免把查询串追加到 # 片段后面。示例替换原查询串;如果要保留已有参数,需要先解析、合并,再编码。
from urllib.parse import urlencode, urlsplit, urlunsplit

parts = urlsplit("https://example.com/search?old=1#results")
query = urlencode({"q": "Python 教程", "page": "1"})
url = urlunsplit(parts._replace(query=query))
assert url.endswith("#results")
assert "old=1" not in url
assert "Python+" in url
print(url)
用 doseq 展开多值参数
doseq=False 时列表会被转换成字符串再编码,不会自动变成多个参数。doseq=True 才能得到 tag=python&tag=web。接口是否接受重复键,以服务端约定为准;空列表不会生成参数项。

Camoufox Open Source Anti-Detect Browser for Python Automation
下载
Camoufox 是一个基于 Firefox 构建的开源反检测浏览器,为 Python 自动化工作流程提供强大的指纹注入和反机器人检测规避功能。它与 Playwright 集成,以提供能够绕过现代机器人检测系统的隐身浏览能力。
from urllib.parse import urlencode, parse_qs

params = {"tag": ["python", "web"], "q": "C++ 入门", "empty": ""}
query = urlencode(params, doseq=True)
assert query.startswith("tag=python&tag=web&")
parsed = parse_qs(query, keep_blank_values=True)
assert parsed["tag"] == ["python", "web"]
assert parsed["q"] == ["C++ 入门"]
assert parsed["empty"] == [""]
print(query)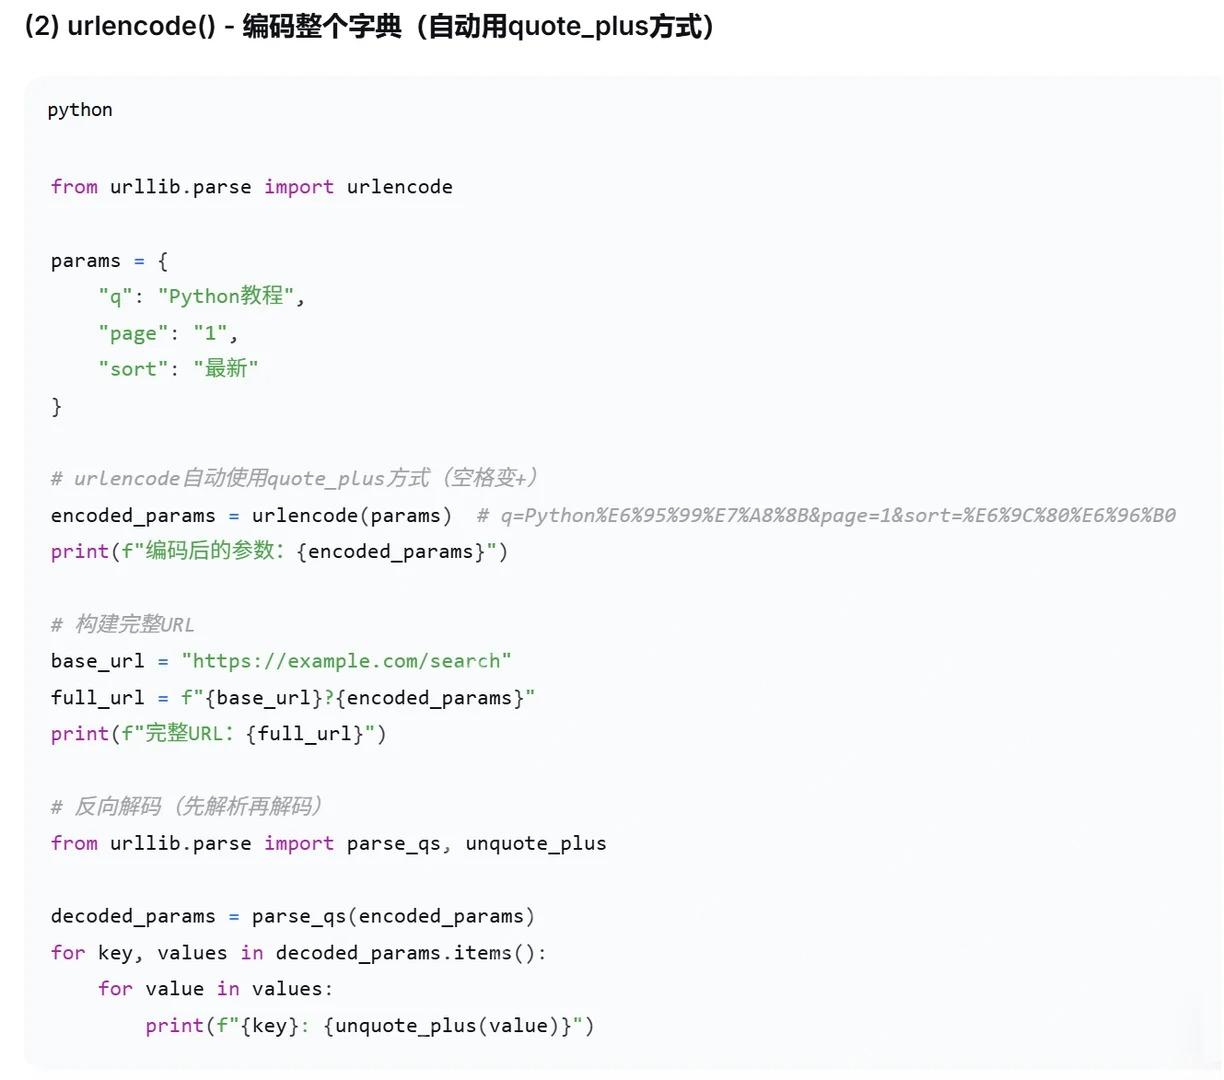
立即学习“Python免费学习笔记(深入)”;
解析查询串时保留空值,避免重复解码
parse_qs 已经解码百分号转义及加号,不要再调用 unquote_plus,否则 C++ 中的加号可能被误改为空格。保留空参数用 keep_blank_values=True;缺少的键和存在但为空的键应分别处理。
from urllib.parse import urlsplit, parse_qs

url = "https://example.com/?q=C%2B%2B&tag=python&tag=web&empty="
params = parse_qs(urlsplit(url).query, keep_blank_values=True)
assert params["q"] == ["C++"]
assert params["tag"] == ["python", "web"]
assert params["empty"] == [""]
assert "missing" not in params
keyword = params.get("q", [""])[0]
print(keyword) # C++ 
















