








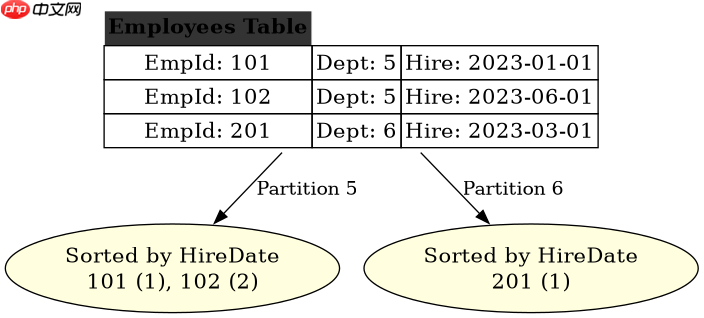
使用 row_number() 按多字段分组排序,核心在于 over 子句中的 partition by 和 order by。partition by 指定分组依据的列(如部门 id),order by 指定组内排序依据的列(如入职日期)。执行时,sql server 会为每个分区内的行生成从 1 开始的连续序号。若需处理并列情况,可改用 rank() 或 dense_rank()。

如何为不同部门的员工按入职时间排名?
通过 PARTITION BY DepartmentId 实现部门分组,并在 ORDER BY HireDate 中指定升序排列,即可得到各部门内部的入职先后顺序。该操作不会改变原始数据,仅增加一列序号。
SELECT EmployeeId, Name, DepartmentId, HireDate,
       ROW_NUMBER() OVER (
           PARTITION BY DepartmentId
           ORDER BY HireDate ASC
       ) AS RowNum
FROM Employees;
假设输入数据包含三个部门,其中研发部有两名员工分别于 2023-01-01 和 2023-06-01 入职,销售部有一名员工于 2023-03-01 入职。运行上述查询后,研发部员工序号分别为 1 和 2,销售部员工序号为 1。结果集保持原表结构,仅新增 RowNum 列,类型为 BIGINT。
如何处理同一天入职的并列情况?
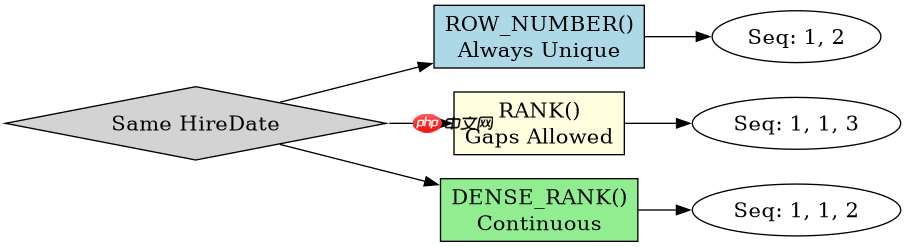
当 ORDER BY 指定的列存在重复值时,ROW_NUMBER() 仍会强制分配唯一序号,顺序由数据库内部决定,可能不稳定。若希望相同入职日期的员工获得相同排名,应使用 RANK() 或 DENSE_RANK()。RANK() 会产生跳跃排名(如 1, 1, 3),而 DENSE_RANK() 保持连续(如 1, 1, 2)。
SELECT EmployeeId, Name, DepartmentId, HireDate,
       RANK() OVER (
           PARTITION BY DepartmentId
           ORDER BY HireDate ASC
       ) AS RankNum
FROM Employees;
沿用上一节示例,若研发部两名员工均在 2023-01-01 入职,则 RANK() 返回的序号均为 1,下一位员工序号为 3。若改用 DENSE_RANK(),下一位员工序号为 2。此行为差异直接影响后续过滤逻辑,例如筛选“每组前两名”时,ROW_NUMBER() 总是返回两行,而 RANK() 可能返回多于两行。
基于部门ID为5的员工,其排名是否受其他部门影响?
不受影响。PARTITION BY 将数据划分为独立区间,每个区间的序号计算互不干扰。部门 ID 为 5 的员工仅在自身分区内参与排序,其序号范围始终从 1 开始,与其他部门的员工数量或排序结果无关。即使删除所有其他部门数据,部门 5 的内部相对顺序和序号保持不变。














