








在sql存储过程中限制单个用户的最大并发执行数,核心做法是利用数据库的会话级临时表或内存表记录当前活跃任务,并在过程入口处进行计数检查。通过查询该表中属于当前用户且状态为“运行中”的记录数量,若达到上限则抛出异常终止执行,否则插入新记录并继续业务逻辑,退出时清理数据。这种方法依赖事务的一致性来保证计数的准确性,适用于需要精确控制资源占用的场景。
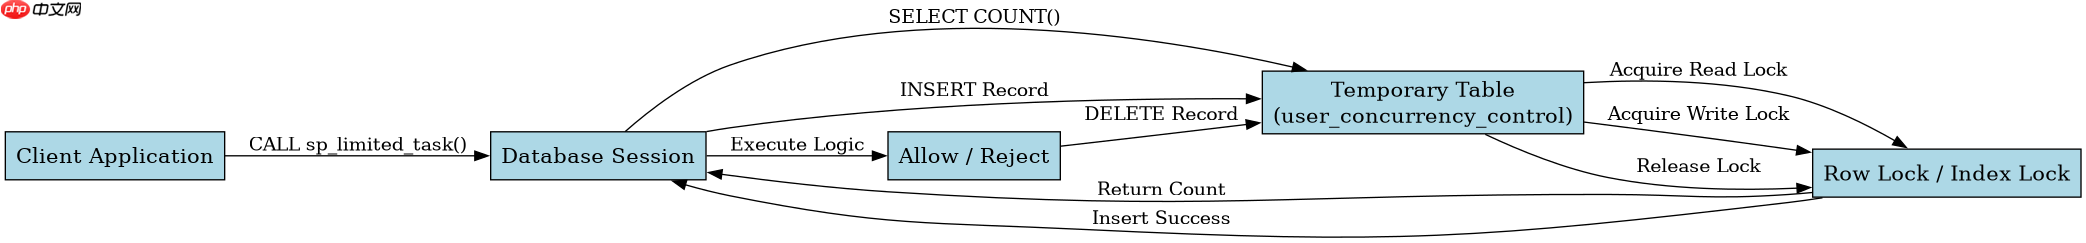
如何设计用于并发控制的会话状态表
设计此类表的关键在于使用会话级(Session-Specific)的生命周期,确保数据随连接断开自动清除,避免手动清理带来的遗漏风险。在MySQL中,MEMORY引擎配合TEMPORARY关键字是最佳选择,因为它速度快且隔离性好。表结构需包含唯一标识、用户ID和状态字段,索引应覆盖用户ID以加速并发时的计数查询。
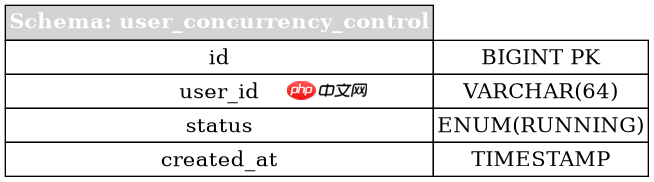
CREATE TEMPORARY TABLE IF NOT EXISTS user_concurrency_control (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    user_id VARCHAR(64) NOT NULL,
    status ENUM('RUNNING', 'FINISHED') DEFAULT 'RUNNING',
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    INDEX idx_user_status (user_id, status)
) ENGINE=MEMORY;
上述代码创建了一个内存临时表,仅对当前会话可见。当存储过程结束时,该表会自动销毁,无需担心残留数据影响后续并发。索引`idx_user_status`确保了在检查并发数时能快速定位到特定用户的活跃记录,减少锁竞争。
如何在存储过程中实现计数与拦截逻辑
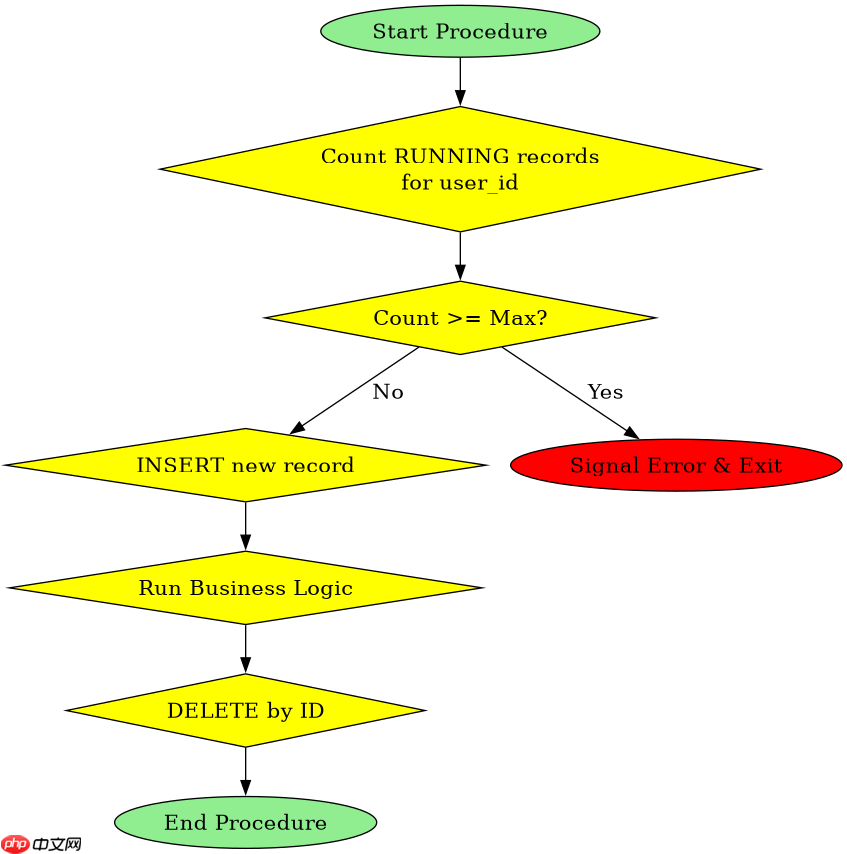
在存储过程的入口,必须执行一个原子性的检查-插入操作。首先查询当前用户已存在的‘RUNNING’状态记录数,如果超过阈值,直接抛出错误。如果未超限,则插入一条新记录,并将该记录的ID绑定到当前会话变量,以便在出口处精准删除。这种模式避免了因并发插入导致的计数偏差,因为插入操作本身具有排他性。
DELIMITER //
CREATE PROCEDURE sp_limited_task(IN p_user_id VARCHAR(64))
BEGIN
    DECLARE v_count INT;
    DECLARE v_max_concurrent INT DEFAULT 5;
    DECLARE v_record_id BIGINT;

    -- 1. 检查当前并发数
    SELECT COUNT(*) INTO v_count
    FROM user_concurrency_control
    WHERE user_id = p_user_id AND status = 'RUNNING';

    IF v_count >= v_max_concurrent THEN
        SIGNAL SQLSTATE '45000'
            SET MESSAGE_TEXT = 'Concurrency limit exceeded for this user.';
    END IF;

    -- 2. 插入新记录并获取ID
    INSERT INTO user_concurrency_control (user_id, status)
    VALUES (p_user_id, 'RUNNING');

    SET v_record_id = LAST_INSERT_ID();

    -- 3. 执行业务逻辑
    BEGIN
        -- 模拟耗时操作
        DO SLEEP(1);
        -- 实际业务代码...
    END;

    -- 4. 清理记录
    DELETE FROM user_concurrency_control
    WHERE id = v_record_id;
END //
DELIMITER ;
这段代码展示了完整的拦截流程。`SIGNAL`语句用于抛出标准SQL异常,客户端捕获后即可知道被拒绝的原因。`LAST_INSERT_ID()`确保了即使在并发环境下,也能准确删除由当前过程插入的那条记录,防止误删其他会话的数据。业务逻辑包裹在独立的BEGIN-END块中,确保无论成功与否,清理步骤都能执行(在实际生产中建议结合HANDLER处理异常以确保清理)。
基于程序输入条件如何处理高并发下的死锁风险
当多个用户同时触发存储过程时,对`user_concurrency_control`表的并发写入可能引发行锁竞争,极端情况下可能导致死锁。虽然MEMORY表通常不涉及磁盘I/O等待,但索引锁仍可能存在。为了降低风险,应避免在检查计数和插入记录之间执行任何长时间运行的非数据库操作。此外,可以将`status`字段的枚举值简化,并确保查询条件尽可能利用索引前导列。如果并发量极大,可考虑引入Redis等外部缓存作为预过滤器,数据库仅作为最终一致性校验,从而减轻数据库压力。


















