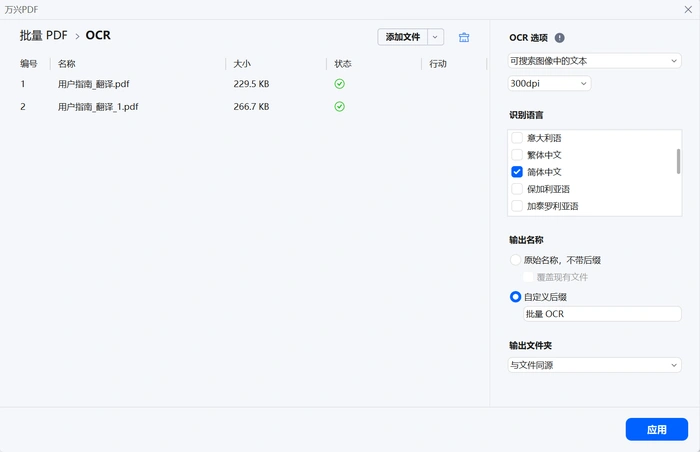
扫描pdf里选不中的文字,需要ocr识别。迅捷ocr文字识别软件适合提取内容并导出word、txt等文件;万兴pdf更适合把扫描资料变成可搜索或可编辑的pdf,之后继续在pdf里工作。两者的重点不同,先决定要拿走文字,还是保留pdf形态,选起来就清楚了。
迅捷OCR文字识别软件:以提取文字和转换格式为主
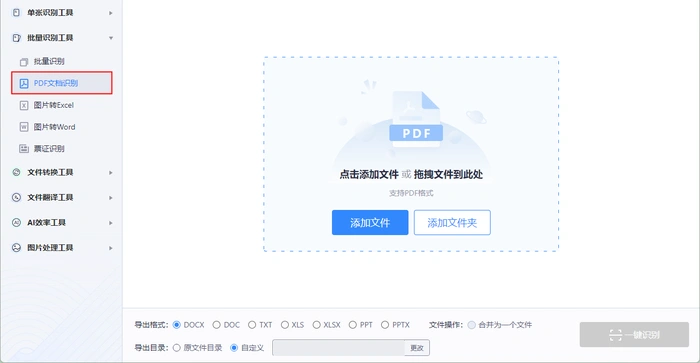
如果拿到扫描资料后,主要想把文字放进Word重新排版,或导出TXT做检索,迅捷OCR的PDF文档识别更对路。它提供文件和文件夹导入,并可选择DOCX、DOC、TXT及表格等导出格式。
要处理PDF,应使用“PDF文档识别”,而不是把图片批量识别入口当作同一个功能。识别准确度受扫描清晰度、倾斜和版面影响,中文数字、表格和专有名词仍需校对。软件提供会员权益,完整识别额度和导出权限以当前授权为准。
万兴PDF:适合保留原文档并继续检索和编辑
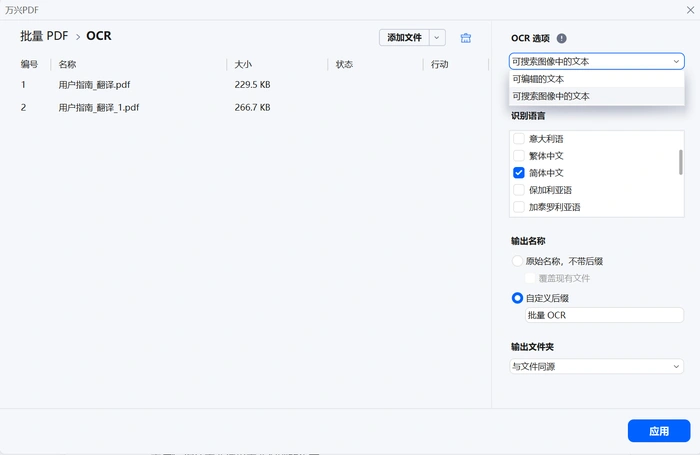
万兴PDF的优势是OCR之后仍围绕PDF处理。批量OCR允许选择可编辑文本,或为图像添加可搜索文本,适合整理档案、扫描教材等需要继续按页阅读和检索的材料。
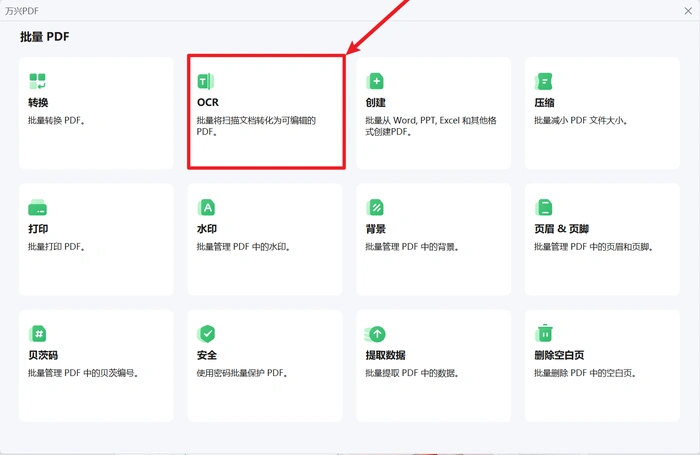
在“工具—批量PDF—OCR”中添加文件,再按资料语言选择识别语言。需要保持扫描页外观时,优先考虑可搜索图像文本;需要进一步改正文时,再选择可编辑文本。两种输出目标不同,并非选择更多选项就一定更准确。
首次使用可能需要加载OCR组件,OCR可用范围取决于所购版本。后续只要查找扫描档案,未必需要转成Word;需要重排成新文稿时,迅捷OCR的文档格式导出更直接。