








在sql中利用子查询实现动态阈值告警检测,核心思路是将静态的固定数值替换为基于历史数据或关联表计算出的实时统计值(如平均值、标准差或分位数)。具体做法是在主查询的where子句中嵌入一个标量子查询,该子查询根据当前记录的时间窗口或分组条件计算出动态基准线,并将主表中的指标字段与该基准线及偏移量进行比较。如果指标偏离基准线超过设定范围,则判定为异常并触发告警。

如何基于时间窗口计算滑动平均作为动态基准
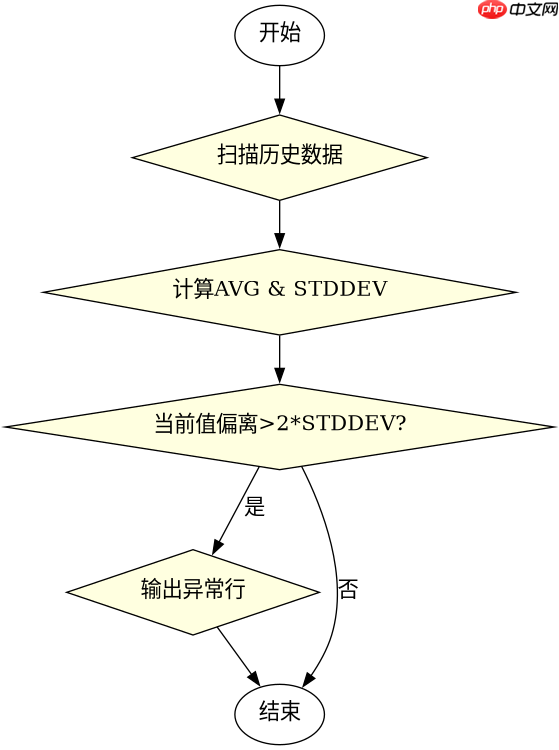
要实现基于时间窗口的动态基准,通常使用相关子查询来限制计算范围。例如,假设我们需要检测传感器读数是否偏离过去一小时内的平均值超过两个标准差。我们可以编写一个查询,在主查询的每一行执行时,子查询会重新扫描同一传感器在过去一小时内产生的所有数据,计算其均值和标准差,然后与当前行的值进行比对。这种方法确保了每个时刻的“正常”范围是动态调整的,能够适应趋势变化。
SELECT
    s.sensor_id,
    s.timestamp,
    s.value,
    sub.avg_val,
    sub.std_val
FROM sensor_readings s
CROSS JOIN LATERAL (
    SELECT
        AVG(sr.value) as avg_val,
        STDDEV_POP(sr.value) as std_val
    FROM sensor_readings sr
    WHERE sr.sensor_id = s.sensor_id
      AND sr.timestamp BETWEEN s.timestamp - INTERVAL '1 hour' AND s.timestamp
) sub
WHERE ABS(s.value - sub.avg_val) > 2 * sub.std_val;
上述代码展示了如何使用LATERAL子查询(或在不支持LATERAL的数据库中改写为相关子查询)来计算滑动窗口内的统计量。输入为sensor_readings表,包含sensor_id, timestamp, value。预期结果是返回那些偏离过去一小时均值超过两倍标准差的记录。注意,这种写法在数据量大时性能较差,因为每行都触发一次子查询扫描,但在逻辑上清晰体现了动态阈值的计算过程。
如何基于分组聚合结果设置差异化阈值
当不同类别的设备或用户具有不同的基线水平时,动态阈值应基于分组聚合结果。例如,电商系统中不同品类的商品转化率差异巨大,不能统一使用一个转化率阈值来判断异常。此时,可以在子查询中按品类(category)分组计算历史平均转化率,然后在主查询中将当前商品的转化率与该品类的平均值进行比较。这样,高转化品类的阈值会自动抬高,低转化品类的阈值会自动降低,从而实现差异化的异常检测。

SELECT
    p.product_id,
    p.category,
    p.conversion_rate,
    cat_stats.avg_conv,
    cat_stats.threshold
FROM products p
JOIN (
    SELECT
        category,
        AVG(conversion_rate) as avg_conv,
        AVG(conversion_rate) * 1.5 as threshold
    FROM products
    GROUP BY category
) cat_stats ON p.category = cat_stats.category
WHERE p.conversion_rate < cat_stats.threshold;
这段代码演示了如何通过JOIN子查询的结果来实现差异化阈值。子查询首先按category分组计算平均转化率,并定义了一个简单的动态阈值规则(均值的1.5倍)。主查询将每个产品与其所属品类的统计信息关联,筛选出低于该动态阈值的产品。输入是products表,输出是转化率低于其品类平均1.5倍的产品列表。这种方式避免了全局单一阈值带来的误报问题。
当子查询返回多行时会发生什么错误
如果在标量子查询的位置使用了非相关的聚合查询,且该查询未通过GROUP BY或LIMIT限制返回行数,当匹配到多条记录时,SQL引擎会抛出“子查询返回多行”的错误。例如,若忘记在子查询中加入与主表关联的条件,或者错误地使用了集合操作而非标量计算,就会导致此问题。开发者在调试此类动态阈值查询时,应确保子查询对于主表的每一行输入,仅返回单个标量值。可以通过添加EXISTS检查或使用ROW_NUMBER()等窗口函数来规避此风险,或者在业务逻辑层面确保分组键的唯一性。


















