








sql触发器会破坏微服务架构中的事务边界,因为它在数据库层面执行隐式逻辑,导致业务逻辑分散且难以追踪。要权衡这一点,应尽量避免使用触发器进行跨服务的数据同步或核心业务逻辑处理,转而采用应用层事件驱动架构(如发布/订阅消息队列)来解耦服务间的数据变更。对于必须保留的简单数据完整性约束,可限制触发器仅用于同一表内的基础校验,并确保其逻辑极简、无副作用。
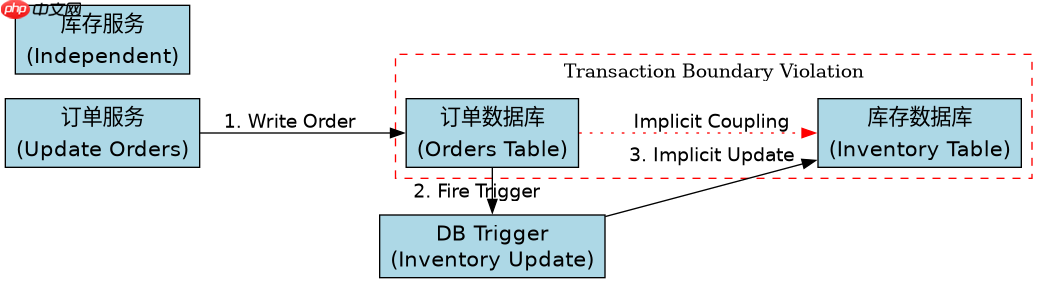
触发器如何导致事务边界模糊
当微服务直接操作共享数据库或使用触发器时,一个看似简单的更新操作可能隐式触发一系列其他表的变更,这些变更发生在同一个数据库事务中,但属于不同业务域。这破坏了微服务应有的独立事务原则,使得故障排查和一致性保证变得极其困难。
-- 假设订单服务直接操作库存表,并依赖触发器扣减库存
BEGIN TRANSACTION;
UPDATE orders SET status = 'paid' WHERE order_id = 1001;
-- 此处触发了 inventory_trigger,自动执行:
-- UPDATE inventory SET quantity = quantity - 1 WHERE product_id = 5001;
COMMIT;
上述代码中,orders表和inventory表的更新被包裹在同一个事务中。如果inventory更新失败(例如库存不足),整个事务回滚,包括订单状态。然而,这种耦合是隐式的,开发者可能不知道orders表的修改会影响inventory。更严重的是,如果未来inventory服务独立部署,它无法感知这个隐式事务,导致数据不一致。
如何设计无触发器的数据同步方案
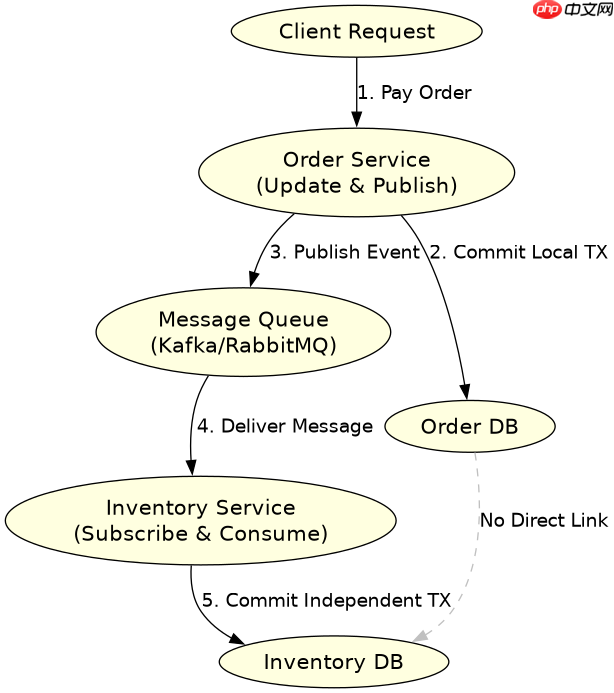
替代触发器的最佳实践是使用应用层的事件发布机制。当服务需要更新数据时,先更新本地数据库,然后发送一条消息到消息队列(如Kafka或RabbitMQ)。其他服务订阅该消息,并在自己的事务中处理数据变更。这样,每个服务都拥有独立的事务边界,且通过最终一致性保证数据同步。
// 伪代码:订单服务在支付成功后发布事件
function handlePayment(orderId) {
    // 1. 更新本地订单状态
    db.update('orders', {status: 'paid'}, {id: orderId});

    // 2. 发布事件,而非直接调用库存服务
    eventBus.publish('OrderPaidEvent', {orderId: orderId, productId: 5001});
}

// 库存服务订阅事件
eventBus.subscribe('OrderPaidEvent', (event) => {
    // 3. 在库存服务自己的事务中扣减库存
    db.transaction(() => {
        const stock = db.query('SELECT quantity FROM inventory WHERE product_id = ?', [event.productId]);
        if (stock.quantity >= 1) {
            db.update('inventory', {quantity: stock.quantity - 1}, {product_id: event.productId});
        } else {
            throw new Error('Insufficient stock');
        }
    });
});在这个方案中,handlePayment函数只负责更新orders表并发布事件。库存服务的逻辑完全解耦,拥有自己的事务。即使库存扣减失败,也不会影响订单状态的提交,订单服务可以记录失败并重试或通知用户。这种设计清晰了事务边界,提高了系统的可维护性和可扩展性。
基于程序中某个输入、条件或结果的具体问题
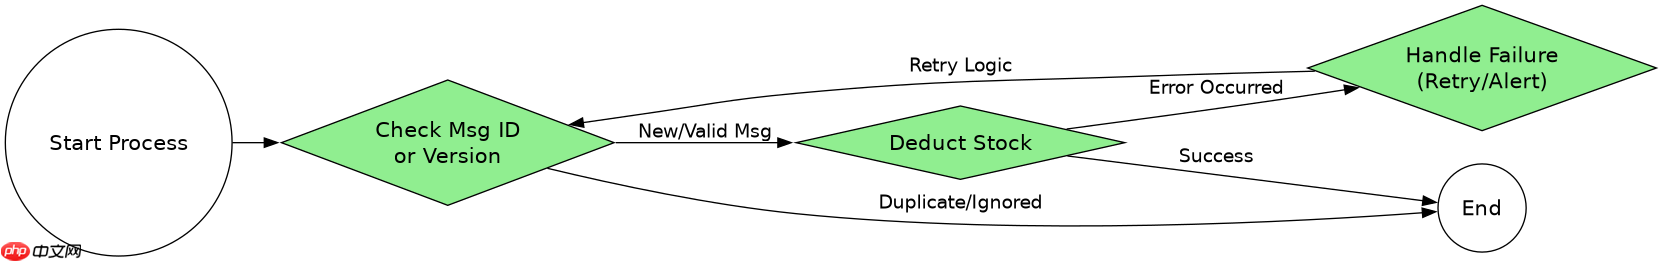
在上述无触发器方案中,如果OrderPaidEvent消息丢失或重复投递,会导致什么结果?具体而言,当消息队列因网络波动导致消息丢失时,库存数据将永远少于订单数据;而当消息重复投递时,库存可能被超额扣减。为解决此问题,需在库存服务中实现幂等性检查,例如使用唯一消息ID或版本号来控制并发更新。


















