








sql中or条件作为join关联键会导致全表扫描,是因为关系型数据库的查询优化器通常无法将包含or逻辑的等值连接转换为高效的嵌套循环或哈希连接,从而被迫放弃索引查找,退化为对驱动表和被驱动表的逐行比对。要解决这一问题,应当将or拆分为多个独立的union all查询,或者使用位图索引、函数索引等特定手段来恢复索引的使用。当or涉及不同列时,优化器难以确定单一索引路径,必须扫描全表以验证每一行是否满足任一条件。
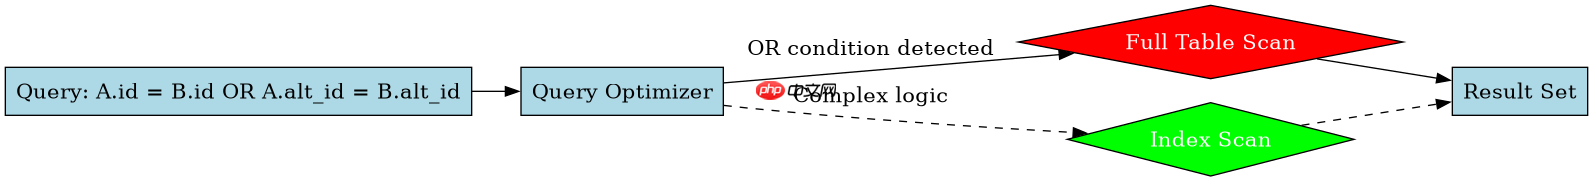
为什么OR JOIN会触发全表扫描
当JOIN条件中包含OR时,例如 A.id = B.id OR A.alt_id = B.alt_id,优化器面临选择困难。大多数B-Tree索引只能高效处理单个列的等值或范围查询。对于OR条件,优化器可能需要同时扫描两个不同的索引,然后合并结果,这在某些情况下开销巨大。更常见的情况是,优化器认为合并两个索引扫描的成本高于直接全表扫描,因此选择全表扫描。此外,如果OR条件中的列选择性不高,或者数据分布不均,优化器也可能倾向于全表扫描以避免大量的随机I/O。
-- 原始低效写法
SELECT *
FROM table_a a
JOIN table_b b ON a.id = b.id OR a.alt_id = b.alt_id;
上述代码在大多数数据库中都会导致全表扫描。为了验证这一点,我们可以查看执行计划。在实际运行中,如果 table_a 和 table_b 都很大,且没有合适的复合索引,数据库引擎将不得不读取每一行数据进行比较。这种操作的时间复杂度接近 O(N*M),其中 N 和 M 分别是两个表的行数。相比之下,如果使用单独的等值连接,时间复杂度可以降至 O(N log M) 或 O(N + M)。因此,避免在JOIN中使用OR是提升性能的关键。
如何重构OR JOIN以提升性能
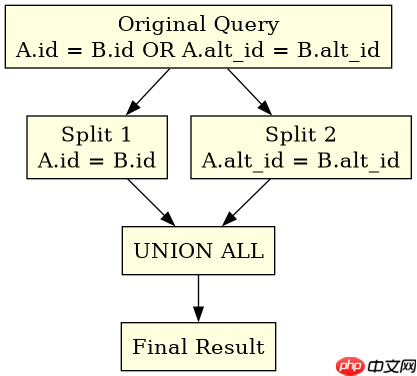
将OR条件拆分为UNION ALL是解决此问题的标准做法。通过将OR逻辑分解为多个独立的查询,每个查询都可以利用各自的索引进行高效查找。最后通过UNION ALL将结果合并。这种方法确保了每个子查询都能充分利用索引,避免了全表扫描。需要注意的是,UNION ALL不会去重,如果业务逻辑允许重复数据,这是最高效的方式。如果需要去重,可以使用UNION,但这会增加额外的排序和去重开销。
-- 重构后的高效写法
SELECT * FROM table_a a
JOIN table_b b ON a.id = b.id
UNION ALL
SELECT * FROM table_a a
JOIN table_b b ON a.alt_id = b.alt_id
WHERE a.id != b.id; -- 可选:根据业务逻辑调整
这种重构方式虽然增加了SQL的复杂度,但显著提升了查询性能。每个子查询都可以独立优化,并且可以利用各自列上的索引。例如,第一个子查询可以利用 a.id 和 b.id 上的索引,第二个子查询可以利用 a.alt_id 和 b.alt_id 上的索引。这样,查询的执行计划将从全表扫描变为索引扫描,大大减少了I/O操作。此外,如果 id 和 alt_id 之间存在互斥关系,即一行数据不可能同时满足两个条件,那么UNION ALL的结果就是正确的,无需额外处理。
基于具体输入条件的索引使用情况
假设我们有一个具体的输入场景:table_a 有100万行数据,table_b 也有100万行数据。id 和 alt_id 都是唯一的。在没有索引的情况下,OR JOIN会导致全表扫描,耗时可能达到数十秒甚至更长。而在添加索引并重构为UNION ALL后,查询时间可以缩短到毫秒级。这是因为索引扫描只需要访问必要的页面,而不是整个表。此外,如果 alt_id 上的数据分布非常不均匀,某些值出现频率极高,那么即使使用索引,也可能因为回表次数过多而导致性能下降。在这种情况下,可以考虑使用覆盖索引,或者进一步优化查询逻辑。


















