








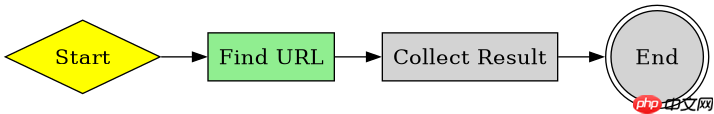
使用 preg_match_all() 配合正则表达式可以提取字符串中的 url 地址。核心做法是定义一个匹配 http/https 协议的规则,传入目标文本,获取所有匹配项。该函数会返回一个包含所有完整匹配结果的数组,若未找到则返回空数组。
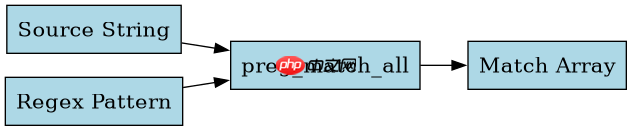
如何从混合文本中提取完整的 HTTP 链接
直接调用 preg_match_all() 并传入特定的正则模式即可提取。输入是一段包含多个链接的 HTML 片段或纯文本,输出是一个索引数组,每个元素都是一个完整的 URL 字符串。只要链接符合标准的协议头格式,就能被准确捕获。
<?php
$text = "Visit https://example.com and http://test.org/page for info.";
$pattern = '/https?:\/\/[^\s]+/';
preg_match_all($pattern, $text, $matches);
print_r($matches[0]);
?>
运行上述代码将输出:
Array
(
[0] => https://example.com
[1] => http://test.org/page
)
如何处理带有查询参数的复杂 URL
调整正则表达式的字符类范围以包含查询参数符号。默认的正则通常能覆盖大多数情况,但显式允许问号、等号和斜杠能确保带参数的链接不被截断。输入为包含 ?id=1&type=a 的 URL,输出将保留完整的参数部分。这种写法避免了因特殊字符导致的匹配中断。

Build MCP servers and clients for PHP applications with the official PHP SDK
下载
使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
立即学习“PHP免费学习笔记(深入)”;
<?php
$text = "Check https://api.site.com/v1?key=123 now.";
$pattern = '/https?:\/\/[^\s"\'>]+/';
preg_match_all($pattern, $text, $matches);
print_r($matches[0]);
?>
运行结果确认链接被完整提取:
Array
(
[0] => https://api.site.com/v1?key=123
)
当字符串中不存在任何 URL 时程序返回什么
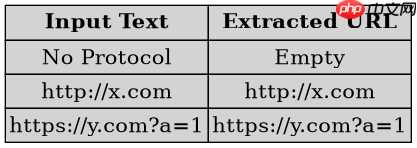
程序会返回一个空的匹配数组。输入为纯文本句子,不包含任何协议头,preg_match_all() 执行后 $matches 变量依然被初始化,但其内部索引为 0 的子数组为空。开发者可以通过检查 count($matches[0]) 来判断是否成功提取到内容,避免后续处理空数据时报错。


















