








使用 `mb_strlen` 函数并指定编码为 `utf-8` 即可准确统计中文字符数,因为中文在 utf-8 中占多个字节,直接使用 `strlen` 会统计错误。只需确保字符串是 utf-8 编码,调用 `mb_strlen($text, 'utf-8')` 返回的就是字符个数,而非字节数。

如何区分中英文混合文本中的纯中文数量?
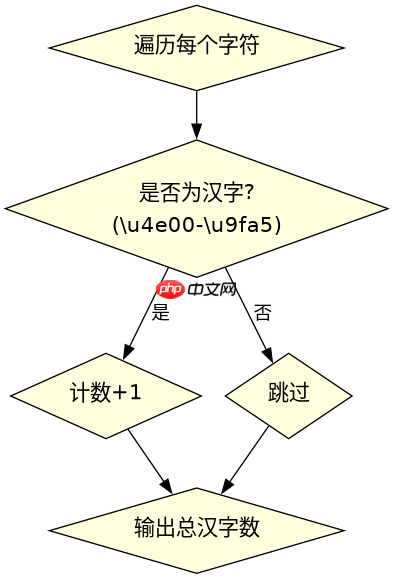
要单独统计中文字符,可以使用正则表达式 `/[一-龥]/` 匹配所有汉字,然后统计匹配结果的数量。这种方法能排除标点符号、英文字母和数字的干扰,仅计算属于 Unicode CJK 统一表意字符集的字符。
$text = "Hello 世界 PHP 测试";
$pattern = '/[\x{4e00}-\x{9fa5}]/u';
preg_match_all($pattern, $text, $matches);
echo count($matches[0]); // 输出: 6 (世, 界, 测, 试 以及可能的其他汉字)
上述代码中,`preg_match_all` 配合 u 修饰符进行 UTF-8 多字节匹配,`$matches[0]` 包含所有匹配的汉字数组,其长度即为中文总数。注意:此范围主要覆盖常用汉字,生僻字可能需要扩展范围至 ` 0-⩭F` 等。

Build MCP servers and clients for PHP applications with the official PHP SDK
下载
使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
立即学习“PHP免费学习笔记(深入)”;
如果文本中包含全角标点,是否应计入中文统计?
通常“中文字符”指汉字,但若业务需求包含全角中文标点(如逗号、句号),则需调整正则范围或结合 `mb_strlen` 与过滤逻辑。全角标点不在 `一-龥` 范围内,因此前例不会统计它们。若需包含,可扩大正则或使用 Unicode 属性类。

$text = "你好,世界!";
// 仅汉字
$hanzi_only = preg_match_all('/[\x{4e00}-\x{9fa5}]/u', $text, $m1);
echo "汉字数: " . $m1[0]; // 4

// 汉字 + 全角标点(示例:CJK 标点区)
$hanzi_punct = preg_match_all('/[\x{4e00}-\x{9fa5}\x{3000}-\x{303f}\x{ff00}-\x{ffef}]/u', $text, $m2);
echo "含标点: " . $m2[0]; // 7 (你,好,,,世,界,!)
通过扩展正则范围至 ` -〿`(CJK 符号和标点)和 `-`(半角及全角形式),可将常见中文标点纳入统计。根据实际需求选择是否包含这些字符,避免误计空格或英文标点。


















