








使用 fetch 获取 m2v 数据时,应调用 response.arraybuffer() 方法将响应体转换为二进制缓冲区。m2v 是 mpeg-2 video 的专有封装格式,浏览器原生不支持直接播放或解码这种流式视频数据,因此通常的做法是将获取到的 arraybuffer 通过 url.createobjecturl 创建 blob url,然后赋值给 <video></video> 元素的 src 属性,或者将其作为二进制数据上传至后端进行进一步处理。

如何正确解析 Fetch 返回的二进制流
要正确解析 M2V 数据,关键在于避免使用 response.text() 或 response.json(),因为这两种方法会尝试对字节序列进行字符编码转换,导致二进制数据损坏。正确的做法是显式指定请求头或使用 arrayBuffer 方法。当服务器返回 M2V 内容时,其 MIME 类型通常为 video/m2v 或 application/octet-stream。开发者需要确保在获取响应后,立即提取原始字节数组,以便后续构建 Blob 对象。
const url = '/api/video/stream.m2v';

fetch(url)
  .then(response => {
    if (!response.ok) {
      throw new Error('Network response was not ok');
    }
    // 关键步骤:获取 ArrayBuffer
    return response.arrayBuffer();
  })
  .then(buffer => {
    // 将 ArrayBuffer 转换为 Blob
    const blob = new Blob([buffer], { type: 'video/m2v' });
    // 创建可供 <video> 标签使用的 URL
    const videoUrl = URL.createObjectURL(blob);

    const videoElement = document.createElement('video');
    videoElement.src = videoUrl;
    videoElement.controls = true;
    document.body.appendChild(videoElement);

    // 注意:大多数现代浏览器内核(如 Chrome, Firefox)默认不支持 M2V 解码
    // 如果无法播放,可能需要后端转码为 MP4/WebM,或使用 MSE (Media Source Extensions)
    console.log('Video element created with M2V source');
  })
  .catch(error => {
    console.error('Fetch error:', error);
  });
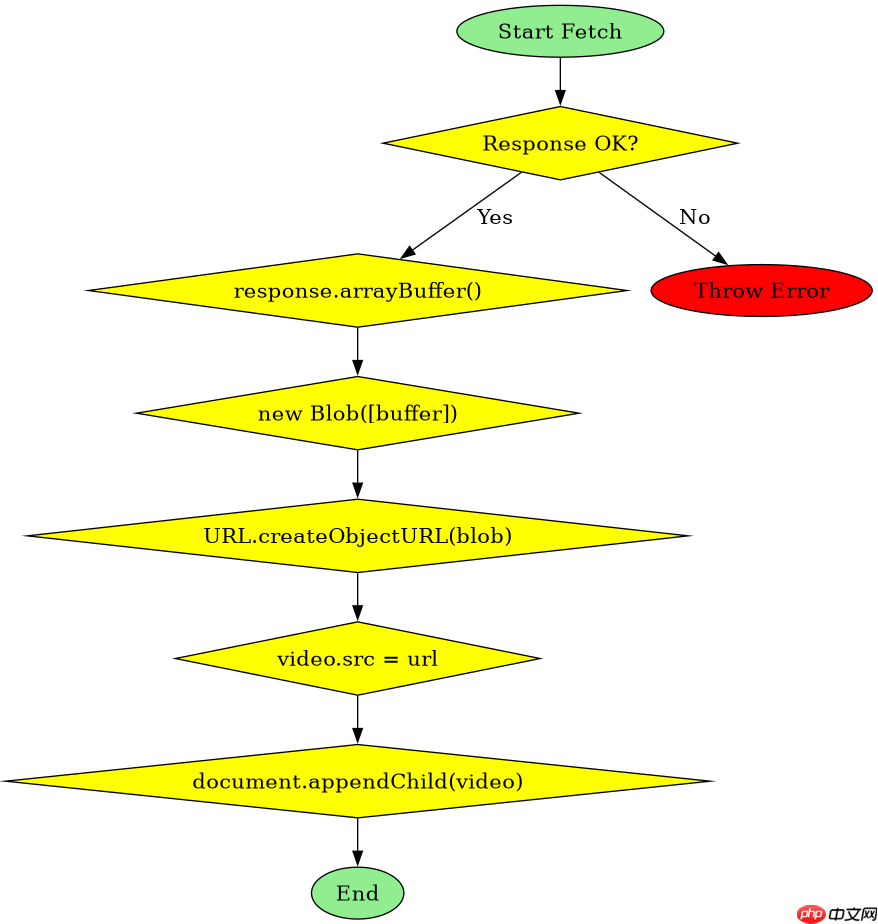
上述代码展示了从发起请求到生成可播放元素的全过程。首先检查 HTTP 状态码,确保请求成功。接着调用 arrayBuffer() 获取底层二进制数据。随后,利用 Blob 构造函数将缓冲包装起来,并指定正确的 MIME 类型。最后,通过 URL.createObjectURL 生成一个临时的本地 URL,并将其赋给新创建的 <video></video> 元素。需要注意的是,虽然语法上可行,但 M2V 并非所有浏览器都原生支持的视频格式,若需广泛兼容,建议在服务端将 M2V 转换为 MP4 格式后再返回。
立即学习“Java免费学习笔记(深入)”;

M2V 数据在前端存储与传输中的注意事项
在处理 M2V 数据时,除了基本的获取方式,还需关注数据的完整性与传输效率。M2V 文件通常较大,且包含连续的视频帧数据。如果在网络不稳定环境下,断点续传或分片下载是常见需求。此时,可以使用 Range 请求头来获取部分数据,并将多个 ArrayBuffer 合并。此外,由于 M2V 是未压缩或轻度压缩的 MPEG-2 视频流,其数据量远大于 H.264/H.265,因此在移动端或低带宽场景下直接使用可能会造成严重的性能瓶颈。开发者应考虑是否真的需要在客户端直接处理 M2V,还是应该在后端完成解码或转码工作。

// 示例:合并多个 ArrayBuffer (模拟分片下载)
async function fetchAndMergeChunks(chunks) {
  const buffers = [];
  for (let i = 0; i < chunks.length; i++) {
    const range = `bytes=${i * 1024}-${(i + 1) * 1024 - 1}`;
    const response = await fetch('/api/video/stream.m2v', {
      headers: { 'Range': range }
    });
    if (response.ok) {
      buffers.push(await response.arrayBuffer());
    }
  }

  // 合并所有片段
  const totalLength = buffers.reduce((acc, buf) => acc + buf.byteLength, 0);
  const mergedBuffer = new Uint8Array(totalLength);
  let offset = 0;
  for (const buf of buffers) {
    mergedBuffer.set(new Uint8Array(buf), offset);
    offset += buf.byteLength;
  }

  // 最终生成完整的 Blob
  const finalBlob = new Blob([mergedBuffer], { type: 'video/m2v' });
  return URL.createObjectURL(finalBlob);
}
该代码片段演示了如何处理分片下载的 M2V 数据。通过循环发送带有 Range 头的请求,获取各个数据块。每个块都通过 arrayBuffer() 获取。然后,创建一个足够大的 Uint8Array 来容纳所有数据,并逐个将各块的字节复制进去。最后,将合并后的完整缓冲区转换为 Blob 并生成 URL。这种方法确保了即使在大文件传输中,也能保持数据的二进制完整性,避免字符编码带来的错误。对于 M2V 这种特定格式,保持字节流的精确性至关重要,任何字节的丢失或错位都可能导致视频流无法被正确解析。
当 M2V 数据过大导致内存溢出时该如何优化
如果 M2V 数据非常大,一次性加载到 ArrayBuffer 中可能会导致浏览器内存溢出(OOM)。在这种情况下,应改用 Media Source Extensions (MSE) API。MSE 允许 JavaScript 动态地将媒体数据片段传递给浏览器解码器,而无需等待整个文件下载完毕。这种方式特别适合直播或超大文件的流式播放。开发者需要将 M2V 数据分割成小的 ArrayBuffer 片段,然后通过 SourceBuffer.appendBuffer() 方法逐段推送。这需要更复杂的逻辑来处理时间戳、序列号和缓冲区的管理,但能显著降低内存占用并提升首屏加载速度。


















