








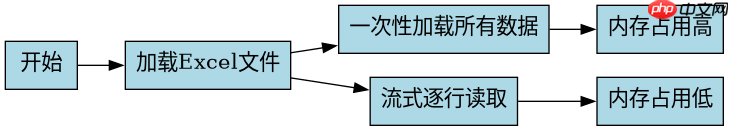
使用epplus库的loadfromcollection方法一次性将数据加载到内存会导致大文件处理时内存占用过高。调整方法是改用流式读取或分页加载,例如通过excelpackage.loadasync结合worksheet.cells逐行遍历,避免一次性实例化所有对象。
如何优化EPPlus加载大数据的性能
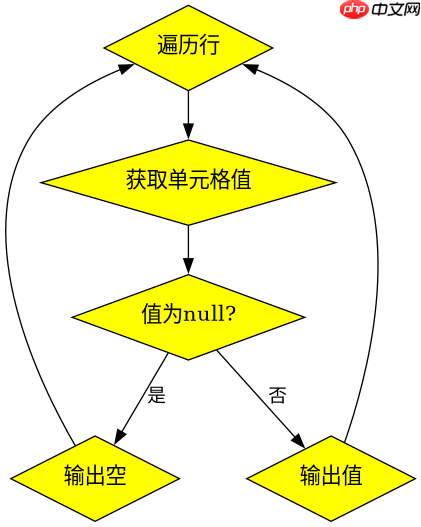
通过异步加载和逐行处理可以显著降低内存峰值。具体做法是调用ExcelPackage.LoadAsync打开文件,然后使用foreach循环遍历Worksheet.Cells,每次只处理当前行的数据并释放引用。

using OfficeOpenXml;
using System.IO;

class Program
{
    static async Task Main()
    {
        ExcelPackage.LicenseContext = LicenseContext.NonCommercial;
        using var stream = File.OpenRead("large.xlsx");
        using var package = new ExcelPackage(stream);
        var worksheet = package.Workbook.Worksheets[0];

        for (int row = 1; row <= worksheet.Dimension.Rows; row++)
        {
            // 处理单行数据
            var cellValue = worksheet.Cells[row, 1].Value?.ToString();
            Console.WriteLine(cellValue);
        }
    }
}
如何处理空值与默认行为
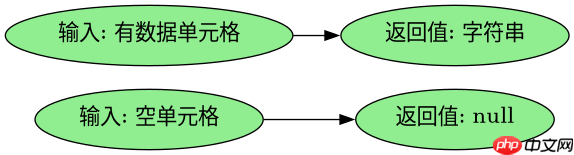
在逐行遍历时,Cells[row, col].Value可能返回null。需要检查空值以避免NullReferenceException。默认情况下,未填充单元格返回null,而非空字符串。
using OfficeOpenXml;
using System.IO;

class Program
{
    static void Main()
    {
        ExcelPackage.LicenseContext = LicenseContext.NonCommercial;
        using var stream = File.OpenRead("test.xlsx");
        using var package = new ExcelPackage(stream);
        var worksheet = package.Workbook.Worksheets[0];

        var value = worksheet.Cells[1, 1].Value;
        if (value == null)
        {
            Console.WriteLine("Empty");
        }
        else
        {
            Console.WriteLine(value.ToString());
        }
    }
}
基于程序中某个输入、条件或结果的具体问题
当输入文件包含大量空行时,worksheet.Dimension.Rows会返回实际有数据的最大行数,而非物理行数。这可能导致遗漏末尾的空行数据,需根据实际需求调整遍历逻辑。














