








使用 collections.synchronizedmap() 可以将一个普通的 hashmap 包装成线程安全的集合,其核心做法是内部所有方法都通过 synchronized 关键字加锁来实现互斥访问。调用该静态方法并传入目标 map 实例即可得到包装后的对象,后续对该对象的增删改查操作均会自动同步。需要注意的是,对于迭代器等需要跨越多个方法的复合操作,必须手动对包装后的 map 对象进行显式同步,否则仍可能出现并发修改异常。

如何创建并使用同步 Map 实例
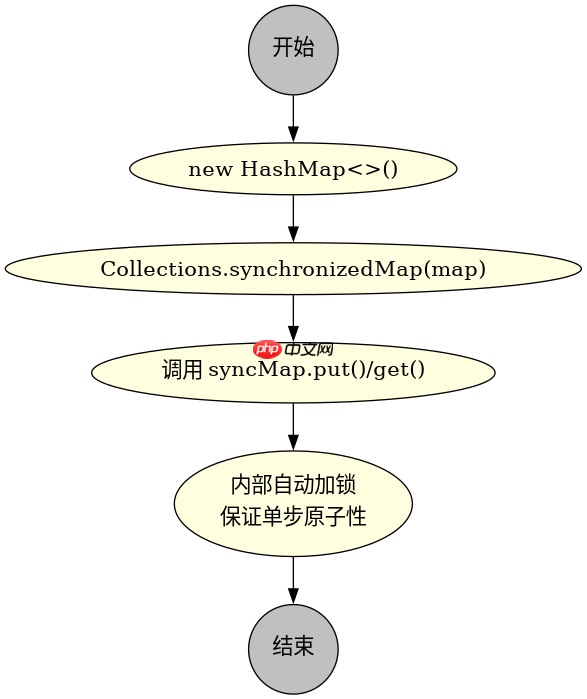
直接调用 Collections.synchronizedMap() 并将普通 HashMap 作为参数传入,即可获得一个线程安全的代理对象。该对象在每次执行 put、get 等单步操作时,都会自动获取内部锁,确保同一时刻只有一个线程能修改或读取数据。这种实现方式简单直接,适用于大多数不需要复杂并发控制的场景。
import java.util.*;

public class SyncMapDemo {
    public static void main(String[] args) {
        // 1. 创建普通 HashMap
        Map<String, Integer> map = new HashMap<>();

        // 2. 使用 Collections.synchronizedMap 包装
        Map<String, Integer> syncMap = Collections.synchronizedMap(map);

        // 3. 安全地放入数据
        syncMap.put("key1", 100);
        syncMap.put("key2", 200);

        // 4. 安全地获取数据
        System.out.println(syncMap.get("key1")); // 输出: 100
    }
}
上述代码展示了最基础的用法。首先实例化一个标准的 HashMap,然后将其传递给 Collections.synchronizedMap。返回的 syncMap 对象在类型上仍然是 Map 接口,但内部维护了一个监视器锁。当线程 A 调用 syncMap.put() 时,它会锁定该对象;此时如果线程 B 尝试调用 syncMap.get(),它必须等待线程 A 释放锁后才能执行。这种机制保证了基本操作的原子性。
立即学习“Java免费学习笔记(深入)”;

Biome 是一个基于 Rust 的高性能工具链,适用于 JavaScript、TypeScript、JSX、JSON、CSS 和 GraphQL,它将格式化和 linting 统一到一个工具中。具有 97% 的 Prettier 兼容性以及超过 450 条 lint 规则,Biome 以显著更快的执行速度取代了 ESLint 和 Prettier。
为什么迭代操作需要额外同步?
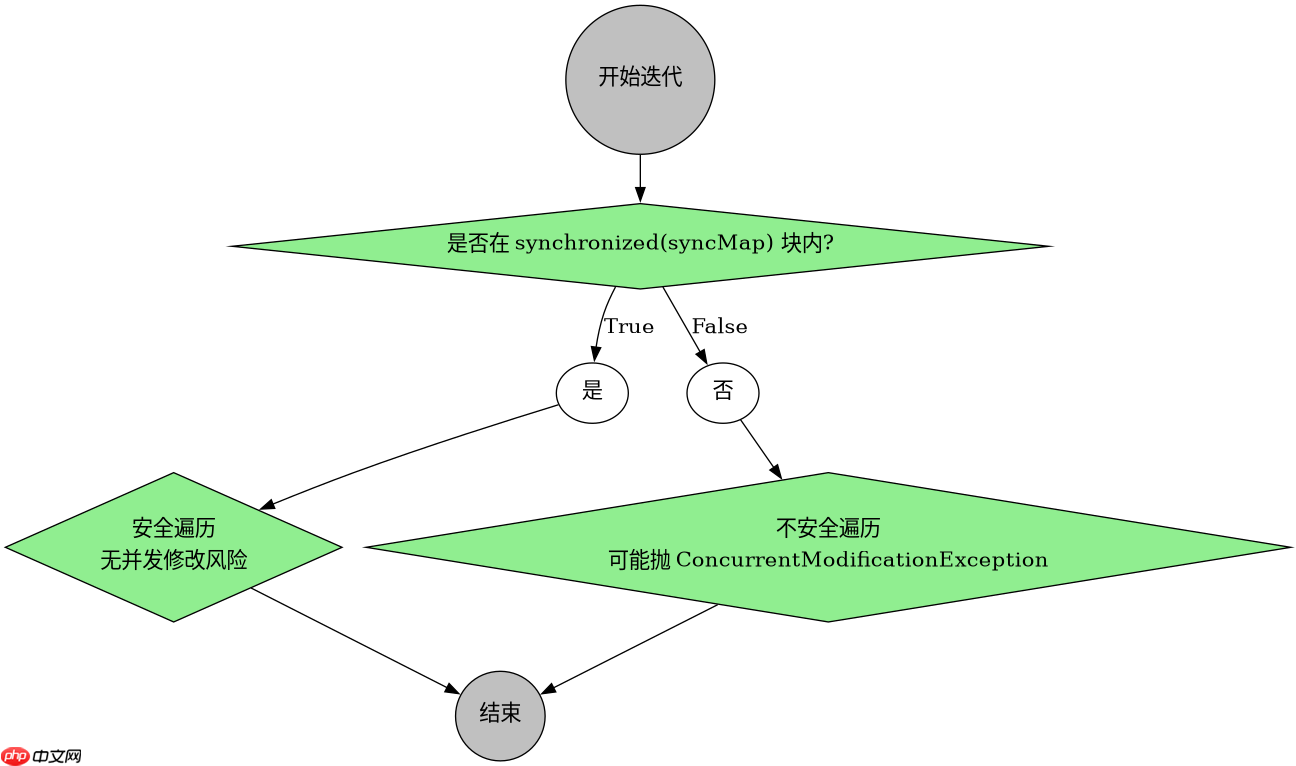
虽然单步操作如 put 和 get 是线程安全的,但迭代遍历(如增强 for 循环)涉及多个步骤,不属于原子操作。如果在迭代过程中其他线程修改了 Map 的结构,会导致 ConcurrentModificationException。因此,必须在使用迭代器时,手动将同步块包裹在对 syncMap 的访问上,以确保在遍历期间没有其他线程能修改 Map。
import java.util.*;

public class IterationSyncDemo {
    public static void main(String[] args) {
        Map<String, Integer> map = new HashMap<>();
        Map<String, Integer> syncMap = Collections.synchronizedMap(map);

        syncMap.put("A", 1);
        syncMap.put("B", 2);

        // 错误写法:可能导致 ConcurrentModificationException
        // for (Map.Entry<String, Integer> entry : syncMap.entrySet()) { ... }

        // 正确写法:手动同步
        synchronized (syncMap) {
            for (Map.Entry<String, Integer> entry : syncMap.entrySet()) {
                System.out.println(entry.getKey() + " = " + entry.getValue());
            }
        }
    }
}
在上面的代码中,我们演示了正确的迭代方式。关键点在于 synchronized (syncMap) 这一行。它将整个迭代过程锁定,直到循环结束才释放锁。这样,即使有其他线程在后台试图向 syncMap 添加或删除元素,它们也会被阻塞,直到当前线程完成遍历。如果不加这个同步块,一旦另一个线程在迭代中间调用了 remove 或 put,迭代器的状态就会失效,抛出运行时异常。这是使用 Collections.synchronizedMap 时最容易忽略的细节。
在多线程环境下如何验证同步效果?
为了验证 Collections.synchronizedMap 确实能防止数据竞争,我们可以模拟两个线程同时向同一个 Map 写入数据的场景。通过统计最终 Map 的大小,可以确认是否所有写入都成功且没有丢失。如果未使用同步机制,由于 HashMap 非线程安全,最终大小通常会小于预期;而使用 Collections.synchronizedMap 后,结果将严格等于预期值。
import java.util.*;
import java.util.concurrent.CountDownLatch;

public class ConcurrencyTest {
    public static void main(String[] args) throws InterruptedException {
        Map<String, String> map = new HashMap<>();
        Map<String, String> syncMap = Collections.synchronizedMap(map);

        int threadCount = 10;
        int writesPerThread = 100;
        CountDownLatch latch = new CountDownLatch(threadCount);

        // 启动多个线程同时写入
        for (int i = 0; i < threadCount; i++) {
            final int id = i;
            new Thread(() -> {
                try {
                    for (int j = 0; j < writesPerThread; j++) {
                        syncMap.put("thread-" + id + "-key-" + j, "value");
                    }
                } finally {
                    latch.countDown();
                }
            }).start();
        }

        // 等待所有线程完成
        latch.await();

        // 验证结果
        int expectedSize = threadCount * writesPerThread;
        System.out.println("Expected size: " + expectedSize);
        System.out.println("Actual size: " + syncMap.size());
        System.out.println("Success: " + (syncMap.size() == expectedSize));
    }
}
这段测试代码创建了 10 个线程,每个线程向 syncMap 写入 100 条记录,总共期望有 1000 条数据。由于使用了 Collections.synchronizedMap,每个 put 操作都是原子的,因此最终 Map 的大小必然为 1000。如果我们将 syncMap 替换为原始的 map,由于并发写冲突,最终大小往往小于 1000,甚至可能引发程序崩溃。这证明了 Collections.synchronizedMap 在处理高并发写入时的有效性。



















