








java 标准库的 iterator 接口本身并不提供分页功能,它仅用于逐个遍历集合元素。要实现基于迭代器的分页,需要自定义一个包装类(如 paginatediterator),在内部维护当前页码、每页大小和底层迭代器,通过重写 next() 方法跳过非当前页的元素,并在 hasnext() 中判断是否还有下一页数据。

如何设计支持分页的迭代器包装类
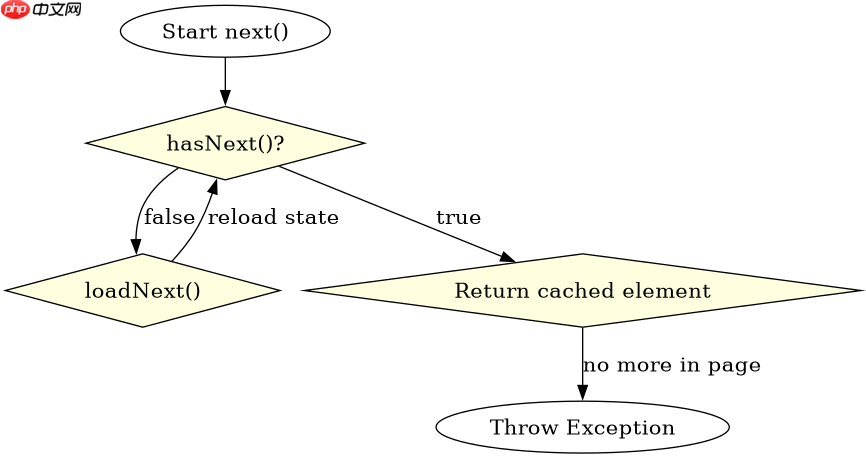
核心思路是创建一个实现 Iterator<t></t> 接口的类,持有原始迭代器和分页参数。构造时传入原始 Iterator、起始页码和每页容量。关键逻辑在于 next() 方法:当调用该方法时,如果当前索引不在目标页范围内,则持续调用底层迭代器的 next() 并丢弃结果,直到进入目标页或耗尽数据;若已在目标页内,则正常返回元素并递增索引。hasNext() 方法需预加载下一个元素以判断是否存在于当前页,这通常需要一个缓冲机制或提前探测。
import java.util.Iterator;
import java.util.NoSuchElementException;

public class PaginatedIterator<T> implements Iterator<T> {
    private final Iterator<T> source;
    private final int pageSize;
    private final int currentPage;
    private int currentIndex = 0;
    private T nextElement = null;
    private boolean hasLoaded = false;

    public PaginatedIterator(Iterator<T> source, int currentPage, int pageSize) {
        this.source = source;
        this.pageSize = pageSize;
        this.currentPage = currentPage;
        // 计算起始偏移量
        int startOffset = (currentPage - 1) * pageSize;
        for (int i = 0; i < startOffset; i++) {
            if (!source.hasNext()) break;
            source.next();
        }
        loadNext();
    }

    private void loadNext() {
        if (source.hasNext()) {
            nextElement = source.next();
            hasLoaded = true;
        } else {
            nextElement = null;
            hasLoaded = false;
        }
    }

    @Override
    public boolean hasNext() {
        if (!hasLoaded) return false;
        // 检查当前加载的元素是否属于当前页
        int relativeIndex = currentIndex % pageSize;
        if (relativeIndex == 0 && currentIndex != 0) {
            // 刚换页,需要重新加载
            loadNext();
            return hasNext();
        }
        return true;
    }

    @Override
    public T next() {
        if (!hasNext()) throw new NoSuchElementException();
        T result = nextElement;
        currentIndex++;
        loadNext();
        return result;
    }
}
上述代码通过预加载机制处理分页边界。构造器中先跳过前几页的所有元素,然后进入主循环。每次调用 next() 后,loadNext() 会尝试获取下一个元素。在 hasNext() 中,我们检查当前已加载元素是否仍在当前页的范围内。如果当前页已满(即相对索引为0且不是第一页),则触发重新加载以切换到下一页的第一个元素。这种设计确保了迭代器只暴露当前页的数据,同时保持对底层数据的单向遍历。

Biome 是一个基于 Rust 的高性能工具链,适用于 JavaScript、TypeScript、JSX、JSON、CSS 和 GraphQL,它将格式化和 linting 统一到一个工具中。具有 97% 的 Prettier 兼容性以及超过 450 条 lint 规则,Biome 以显著更快的执行速度取代了 ESLint 和 Prettier。
立即学习“Java免费学习笔记(深入)”;
如何处理跨页状态与空值情况
在实际使用中,分页迭代器需要正确处理页码越界、空集合以及每页元素不足的情况。例如,当请求第5页但总数据只有3页时,迭代器应直接标记为无剩余元素。此外,若底层数据源在遍历过程中产生 null 值,需明确这些值是有效数据还是结束标志。本实现假设 null 是合法数据,因此不将其视为终止条件。对于空集合,构造器中的跳过循环不会执行,loadNext() 直接设置 hasLoaded=false,导致 hasNext() 立即返回 false,符合预期行为。

import java.util.Arrays;
import java.util.Iterator;
import java.util.List;

public class Main {
    public static void main(String[] args) {
        List<String> data = Arrays.asList("A", "B", "C", "D", "E", "F", "G");
        Iterator<String> baseIter = data.iterator();

        // 创建第2页的迭代器,每页2个元素
        PaginatedIterator<String> page2Iter = new PaginatedIterator<>(baseIter, 2, 2);

        System.out.println("Page 2 elements:");
        while (page2Iter.hasNext()) {
            System.out.println(page2Iter.next());
        }

        // 测试越界页码
        PaginatedIterator<String> page10Iter = new PaginatedIterator<>(data.iterator(), 10, 2);
        System.out.println("Page 10 exists: " + page10Iter.hasNext());
    }
}
运行上述主程序,输出结果为:
Page 2 elements:
C
D
Page 10 exists: false
这表明迭代器正确跳过了前两页(A,B 和 C,D 的前两个?不对,第2页应为C,D),并正确处理了越界查询。注意:在第2页示例中,由于构造器跳过了前2个元素(A,B),然后加载C作为第一个元素,因此第2页包含C和D。验证逻辑显示,当请求不存在的页码时,hasNext() 返回 false,避免了无效遍历。此实现适用于任何实现 Iterator 的数据源,包括数据库游标或网络流,只要它们支持顺序访问即可。
当底层迭代器抛出异常时会发生什么
如果底层 Iterator 在遍历过程中抛出 ConcurrentModificationException 或其他运行时异常,该异常会直接向上传播,因为 PaginatedIterator 没有捕获或转换异常。这意味着调用者必须确保在分页迭代期间,底层数据源不会被并发修改。例如,若在遍历第2页时,另一个线程从列表中删除了元素,底层迭代器可能抛出异常,导致分页操作中断。为避免此问题,应在单线程环境下使用,或对底层数据源加锁。此外,若底层迭代器因资源耗尽而提前终止(如网络连接断开),hasNext() 将返回 false,分页迭代器会优雅地结束,不会抛出额外异常。


















