








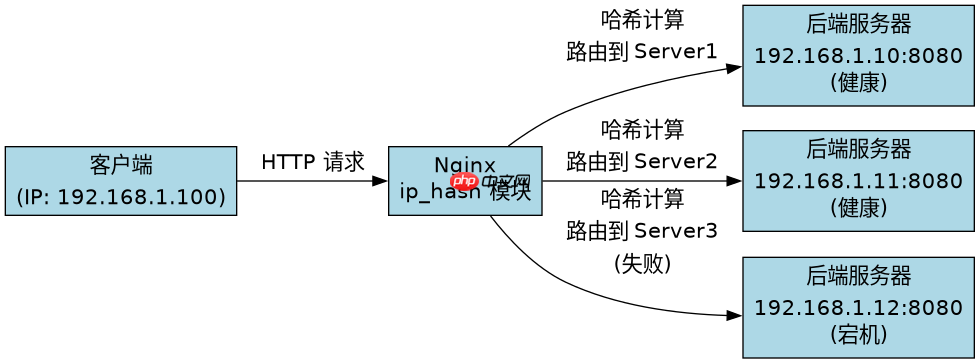
排查 nginx ip_hash 导致部分用户无法访问的故障,核心在于确认请求是否被正确路由到健康的后端节点。通常是因为客户端 ip 属于某个特定后端服务器,而该服务器宕机或健康检查失败,导致请求持续投递给不可用节点。通过查看 nginx 错误日志中的 upstream timed out 或 connection refused 错误,并结合 curl -i 模拟不同 ip 的请求,可以快速定位是哪个后端节点出了问题。
如何验证 ip_hash 是否生效及当前路由情况
要验证 ip_hash 是否生效,最直接的方法是观察同一来源 IP 的多次请求是否始终到达同一个后端服务器。可以通过在 Nginx 配置中启用 access_log 并记录上游地址,或者使用 curl 命令模拟不同 IP 的请求来测试。如果配置了 hash $remote_addr consistent;,则可以使用一致性哈希算法减少节点变动时的缓存失效,但基本逻辑仍是基于 IP 固定路由。
server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://backend_pool;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }
}

upstream backend_pool {
    ip_hash;
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    server 192.168.1.12:8080;
}
上述配置中,ip_hash 指令默认基于 $remote_addr 进行哈希计算。当客户端发起请求时,Nginx 会根据其 IP 地址计算出一个哈希值,并将该请求永久分配给对应的后端服务器。如果某个后端服务器(如 192.168.1.10)出现故障,所有哈希值映射到该服务器的 IP 将无法访问,除非手动将该服务器标记为 down 或等待 Nginx 重新计算权重(在 ip_hash 模式下,通常不会自动重分布,需手动干预)。
如何通过日志和工具定位故障节点
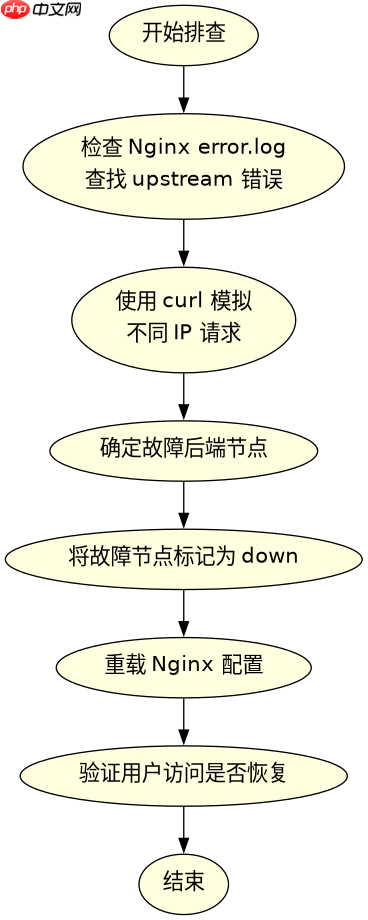
当发现部分用户无法访问时,应首先检查 Nginx 的错误日志(通常是 error.log),查找是否有针对特定上游服务器的连接超时或拒绝错误。同时,可以使用 curl 命令指定不同的源 IP 进行测试,以确认哪些 IP 段受到了影响。例如,使用 -e 参数模拟不同的客户端 IP,观察响应状态码和延迟。


# 模拟来自 192.168.1.100 的请求
curl -I -H "X-Forwarded-For: 192.168.1.100" http://example.com/

# 模拟来自 192.168.1.101 的请求
curl -I -H "X-Forwarded-For: 192.168.1.101" http://example.com/

# 检查错误日志
tail -f /var/log/nginx/error.log | grep "upstream"
在测试过程中,如果发现某个 IP 的请求返回 502 Bad Gateway 或 504 Gateway Timeout,则说明该 IP 被路由到了故障的后端服务器。此时,可以登录到 Nginx 服务器,临时将故障的后端服务器从 upstream 块中移除或标记为 down,以恢复服务。例如,修改配置如下:
upstream backend_pool {
    ip_hash;
    server 192.168.1.10:8080 down; # 标记为不可用
    server 192.168.1.11:8080;
    server 192.168.1.12:8080;
}
修改后,重新加载 Nginx 配置(nginx -s reload),观察故障是否消除。如果问题依旧,可能需要进一步检查后端服务器的健康状况、网络连通性或防火墙规则。
当后端服务器宕机时 ip_hash 的具体行为是什么
在 ip_hash 模式下,如果某个后端服务器宕机,Nginx 默认不会自动将原本路由到该服务器的请求转移到其他健康节点。这意味着,所有哈希值映射到宕机服务器的 IP 将持续收到错误响应,直到管理员手动将该服务器标记为 down 或重启 Nginx 以重新计算哈希分布。这种行为可能导致部分用户长时间无法访问,即使其他后端服务器处于健康状态。




















